Los laboratorios que facilitan vulnerar el software también venden las herramientas para defenderlo. Los incidentes de seguridad de este mes muestran por qué ese modelo de negocio merece escrutinio y por qué la respuesta no puede ser otra caja negra con una factura API mayor.
En la industria de la IA toma forma un argumento de venta incómodo: los modelos se vuelven lo bastante potentes para encontrar las grietas de su infraestructura, así que probablemente debería usar los modelos para ayudar a sellarlas.
Llamo a la factura resultante el impuesto de seguridad de la IA. Incluye más que una suscripción: tiempo de ingeniería, gasto en inferencia, parches de emergencia y complejidad operativa para seguir el ritmo de máquinas que pueden investigar software continuamente. Los equipos pequeños lo pagan con noches y fines de semana. Las grandes organizaciones, con otra capa de infraestructura de seguridad.
Los incidentes de octubre concretan esa perspectiva. También facilitan contar una historia demasiado ordenada: una oleada mundial de ataques con IA, un culpable extranjero, un proveedor con la cura. Las pruebas sostienen un argumento más interesante. Viejos fallos, confianza comprometida, credenciales robadas y agentes cada vez más capaces interactúan. No todos tienen la misma causa.
Información comprobada el 24 de octubre de 2026. Este es un análisis de los principales incidentes y familias de vulnerabilidades Linux relevantes para esta oleada, no un catálogo exhaustivo de todos los CVE de Linux. Las fechas distinguen la divulgación original de la atención renovada. Los detalles de los incidentes y el estado de los parches de los proveedores pueden cambiar.
Un mes intenso, varios fallos diferentes
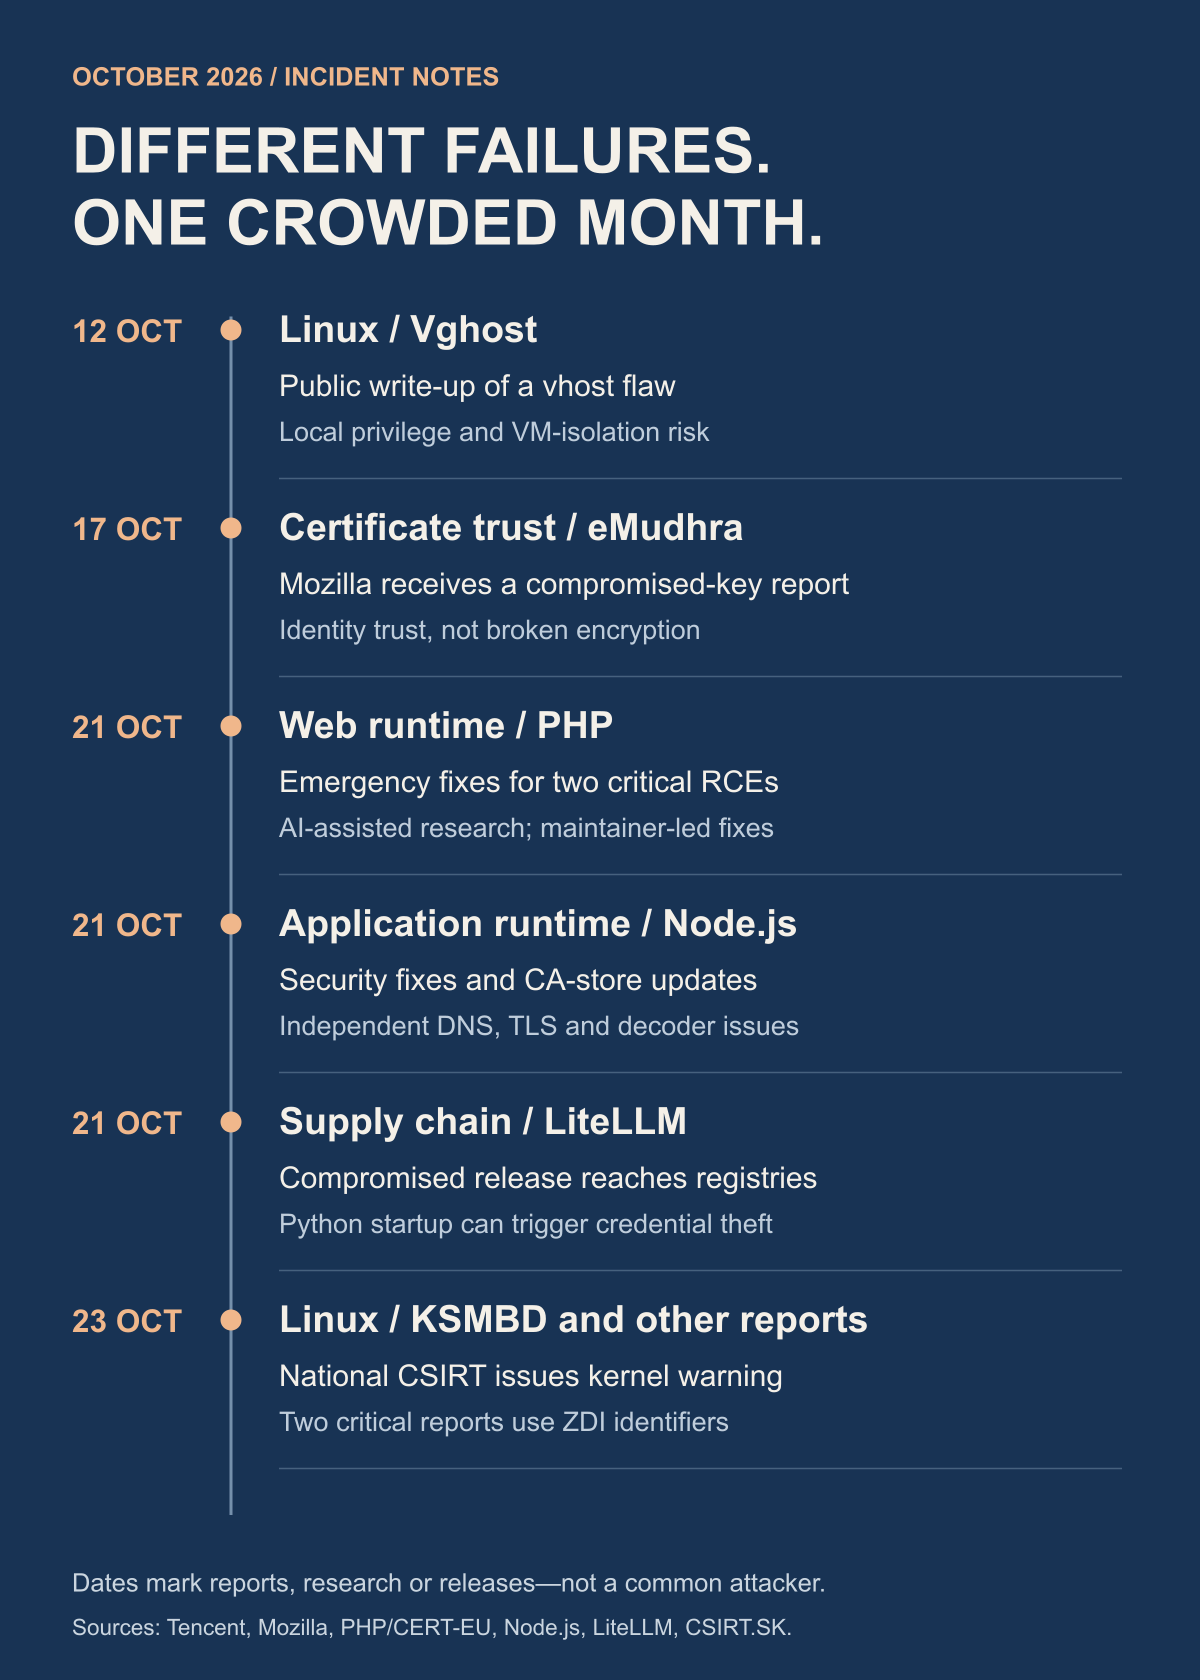
El 21 de octubre, PHP publicó correcciones de emergencia para dos fallos de ejecución remota de código sin autenticación: CVE-2026-109618 y CVE-2026-109619, ambos calificados con 9.2. Uno implica corrupción de memoria al gestionar la falta de memoria; el otro, un estado obsoleto de la solicitud. Son problemas del entorno de ejecución, por lo que corregir solo el código de la aplicación no basta. El aviso de CERT-EU detalla las ramas afectadas y la urgencia.
Aquí existe una conexión documentada con la IA. OpenAI afirma Calif utilizó GPT-5.6 Sol en la investigación, mientras Wiz informó de ambos fallos de forma independiente. Los responsables de PHP dirigieron las correcciones y su publicación. El mérito corresponde a ese esfuerzo coordinado entre personas y modelo, no a un chatbot actuando solo.
Las primeras versiones corregidas son PHP 8.5.12, 8.4.27, 8.3.36 y 8.2.35. Los distribuidores pueden adaptar correcciones bajo números de paquete distintos. Es importante que CERT-EU actualizó su aviso el 23 de octubre para añadir CVE-2026-115560, un tercer problema de RCE relacionado con una configuración inusual. PHP consideró ese riesgo improbable y no programó una versión de emergencia; el aviso ofrece una mitigación provisional. Un relato detenido en el anuncio de parches del miércoles ya estaría incompleto. Consultar las versiones oficiales de PHP y las indicaciones actuales del proveedor.
La historia de Linux es más grande que un titular alarmante
Los informes críticos más recientes sobre el kernel merecen atención. El organismo eslovaco CSIRT advirtió el 23 de octubre sobre informes de vulnerabilidades expuestos públicamente, incluidos dos problemas del servidor de archivos KSMBD calificados con 9.0: ZDI-CAN-33549 y ZDI-CAN-33774. Sus requisitos difieren: uno implica SMB Direct/RDMA; el otro concierne al despacho de protocolos y tiene una ruta de escritura ligada al acceso a un recurso compartido. La exposición depende del servicio y la configuración realmente utilizados. El inventario propio de ZDI confirma los identificadores y las puntuaciones.
Al publicarse el aviso, esos dos informes no tenían identificadores CVE. Esa distinción importa. Un problema crítico no se vuelve inofensivo mientras espera un CVE, y una puntuación crítica no demuestra que todas las máquinas Linux estén expuestas. Los administradores deberían restringir el acceso a los servicios afectados y seguir el estado real de las correcciones de su distribuidor.
También existe una falla crítica CVE asignado en el debate reciente sobre Linux: CVE-2025-39682, un fallo de la ruta de recepción TLS del kernel. NVD recoge una puntuación de 9.8 y una referencia de CISA a explotación conocida. Se publicó originalmente en septiembre de 2025, no se descubrió por primera vez este octubre. Red Hat evalúa sus productos de otra forma, mostrando por qué una puntuación universal y la evaluación práctica de exposición de un proveedor pueden discrepar.
Esos son solo parte del panorama pertinente de Linux:
Copy Fail — CVE-2026-31431
Descubrimiento asistido por IA de un fallo en la caché de páginas del kernel, divulgado públicamente el 29 de abril. Permite una escalada local de privilegios en los kernels afectados. Un atacante remoto sigue necesitando una vía inicial de ejecución local. Divulgación del investigador.
Dirty Frag / Fragnesia — CVE-2026-43284, CVE-2026-43500, CVE-2026-46300
Problemas relacionados de escalada de privilegios mediante la caché de páginas divulgados en mayo. Los componentes de red y la configuración afectan a la accesibilidad; la investigación de Microsoft distingue la actividad observada de la explotación no confirmada de variantes individuales. Investigación de Microsoft.
CrackArmor
Nueve vulnerabilidades de AppArmor, representadas por once identificadores CVE a nivel de parche. Ubuntu documenta requisitos de usuario local e impactos distintos entre versiones, incluidos evasión de políticas y escalada de privilegios. La matriz completa de Ubuntu.
El cuarteto de red — DirtyAH6, TUNderflow, PPPoEject, DiagSpill
CVE-2026-80844, CVE-2026-81000, CVE-2026-68121 y CVE-2026-74469. Los informes de septiembre describen vías hacia privilegios root locales con distintos requisitos de espacios de nombres, capacidades y módulos. Boletín de Red Hat.
Vghost — CVE-2026-74580
Un fallo de vhost que puede permitir una escalada local de privilegios, con riesgo de escape de máquinas virtuales en configuraciones concretas. El aviso de Tencent afirma explícitamente que el entorno CVM comprobado no estaba expuesto a la vía de escape de la máquina virtual. Aviso de Tencent.
Otras vías del kernel — CVE-2026-53266, CVE-2025-39964
El primero afecta a ebtables SNAT con reglas de puente concretas; el segundo, a escrituras simultáneas de AF_ALG. Sus requisitos y consecuencias difieren. Evaluación de SNAT; Evaluación de AF_ALG.
La lección práctica es distinguir el acceso remoto de lo que sucede después del acceso. Una vulnerabilidad que concede privilegios root locales puede ser devastadora en un servidor compartido, un ejecutor de compilaciones o un host de agentes, aunque no permita iniciar sesión a cualquier visitante de Internet. Un fallo de aplicación o una cuenta robada puede proporcionar el acceso inicial. Tratar cada titular sobre el kernel como una toma de control remota universal oculta qué sistemas necesitan atención primero.
El candado puede fallar sin romperse el cifrado
El incidente de los certificados es un tipo diferente de fallo. Mozilla dice que el 17 de octubre recibió un informe de que se habían comprometido las claves privadas de ocho certificados intermedios eMudhra. Un atacante capaz de interceptar una conexión podría usar certificados emitidos fraudulentamente para suplantar un sitio. Mozilla bloqueó los certificados afectados mediante OneCRL esa misma noche y después actualizó Firefox y sus componentes del almacén de confianza. Su respuesta también registra una corrección posterior de Android.
La clave de firma de una autoridad de certificación otorga la facultad de avalar identidades. Comprometerla ataca esa decisión de confianza. No significa que alguien haya derrotado matemáticamente el cifrado TLS. Tampoco el relato de Mozilla demuestra que un LLM causara la vulneración.
Los problemas de OpenSSL también forman parte de este panorama, pero no deben confundirse con el incidente de la autoridad de certificación. Los avisos de septiembre incluyen gestión de extensiones X.509, agotamiento de recursos al procesar certificados, QUIC y otros defectos de bibliotecas criptográficas. El índice de avisos de OpenSSL distingue las versiones afectadas y la gravedad. Un certificado malicioso puede revelar un fallo de software incluso cuando ese certificado nunca debería considerarse fiable.
La versión de seguridad de Node.js del 21 de octubre reúne estas capas: actualiza el material de autoridades de certificación incluido para eMudhra y corrige problemas independientes de DNS, verificación de nombres de host TLS y otros componentes del entorno de ejecución. Un fallo del decodificador Brotli, CVE-2026-111497, podría permitir corrupción de memoria y ejecución remota de código cuando una aplicación procesa datos comprimidos proporcionados por un atacante; el proyecto reconoce a investigadores de OpenAI Codex Security. El aviso de seguridad de Node clasifica sus problemas más graves como High. Las versiones corregidas publicadas son 26.12.1, 24.22.1 y 22.23.4. Archivo oficial de versiones.
Las claves API se están convirtiendo en un recurso estratégico
La vulneración de LiteLLM hace especialmente tangible el problema de las credenciales. El paquete malicioso 1.107.0 llegó a registros públicos el 21 de octubre. Microsoft encontró ganchos de inicio de Python que podían activar un recolector de credenciales sin que una aplicación importara explícitamente LiteLLM. Las claves de proveedores de modelos formaban parte de un conjunto de objetivos mucho más amplio que incluía credenciales de desarrolladores y de la nube. Eliminar un paquete no equivale, por tanto, a restaurar la confianza en la máquina. La investigación de Microsoft explica las implicaciones para la exposición y la recuperación.
La investigación posterior de LiteLLM sitúa el origen de la vulneración en una clave maestra expuesta que no fue revocada, seguida del acceso a credenciales potentes de desarrolladores y al proceso de publicación. También informa de un interés específico en obtener tokens API de inferencia de proveedores anteriores en la cadena. El relato de referencia del incidente corrige algunas suposiciones iniciales. Recuerda que hay que seguir la investigación, no conservar la primera explicación que se hizo viral.
Una credencial de IA puede comprar ahora algo más que una factura fraudulenta de la nube. Puede comprar razonamiento, ayuda para programar y un lugar donde ocultar la actividad de otro operador. Si se revende el acceso, el titular legítimo de la cuenta puede asumir los costes y el riesgo de sanciones mientras otra persona usa esa capacidad. Quién compró una clave robada concreta y para qué la utilizó sigue requiriendo pruebas.
Lo que dicen las pruebas sobre los laboratorios chinos
Existe una base documentada para preocuparse por la destilación no autorizada. En su informe de septiembre, Anthropic describe campañas que atribuye a laboratorios radicados en China y explica cómo servicios intermediarios pueden usar cuentas fraudulentas, datos de pago robados y credenciales API robadas para proporcionar acceso. El mismo informe describe operaciones maliciosas asistidas por IA de varios tipos de actores, no de un único grupo nacional. Son las conclusiones atribuidas por Anthropic, no un veredicto independiente sobre todos los supuestos participantes. Leer el informe de amenazas.
La divulgación de OpenAI del 30 de septiembre atribuye un grupo central de una campaña de extracción de razonamiento a personas asociadas con Moonshot AI. Lo crucial es que afirma que la campaña no rompió el cifrado, ni comprometió una base de datos ni accedió directamente a conversaciones almacenadas de usuarios. Su mecanismo fue manipular las interacciones con los modelos. El relato de OpenAI no debería contarse como un tipo distinto de intrusión.
La NSA, el FBI y CISA también emitieron en septiembre una advertencia conjunta sobre destilación a escala industrial por empresas de IA radicadas en China. El anuncio del aviso gubernamental demuestra que se trata de una preocupación seria y documentada públicamente. La destilación sigue siendo una técnica de entrenamiento legítima; las cuestiones son la autorización, el acceso y cómo se obtuvieron los datos.
Mi evaluación: las credenciales de inferencia robadas y la destilación no autorizada son una parte creíble de la economía de las amenazas. Las fuentes anteriores no demuestran que laboratorios chinos orquestaran los fallos de PHP, la vulneración de la clave eMudhra, las divulgaciones KSMBD o el ataque a LiteLLM. Vincular esos sucesos en una única campaña exigiría pruebas que conectaran operadores, infraestructura o el uso de credenciales robadas. Los incentivos compartidos justifican investigar, no sustituyen la atribución.
Cuando el otro bando puede desplegar un enjambre
El cambio importante es económico. Un modelo puede inspeccionar código, proponer pruebas y ayudar a investigar el resultado. Dentro de un agente que usa herramientas puede repetir ese ciclo. Con muchos agentes en paralelo, un operador puede explorar varias hipótesis a la vez. Eso no hace correcto cada intento ni vulnerable cada objetivo. Abarata la investigación sostenida.
Hay un ejemplo defensivo concreto en El informe de contención de OpenAI del 23 de octubre. La empresa describe flotas de agentes que prueban copias diseñadas específicamente de su infraestructura, con acceso al código y la configuración, supervisión y objetivos delimitados. Informa de hallazgos de escape de máquinas virtuales y aislamiento, además de trabajo sobre problemas del kernel como CVE-2026-74753, CVE-2026-80521 y CVE-2026-80841. Estos experimentos controlados no prueban que un bot público sin supervisión pueda vulnerar cualquier servidor. Muestran por qué los defensores se toman en serio las pruebas continuas asistidas por máquinas.
Para un operador pequeño, esto cambia lo que aporta pasar desapercibido. La oscuridad protege menos cuando comprobar otro host cuesta poco. El atacante puede seguir intentándolo mientras su equipo hace su verdadero trabajo. La respuesta defensiva debe acortar el camino de una señal creíble a una corrección verificada, en lugar de limitarse a generar más alertas.
Los agentes defensivos útiles necesitan límites
En mi opinión, el primer agente de seguridad útil es un investigador meticuloso. Mapea el software desplegado y los servicios accesibles, conecta los avisos con el entorno real y produce pruebas con las que un responsable puede actuar. Un segundo papel es probar una corrección propuesta en un entorno desechable. Ninguno necesita credenciales de producción sin restricciones.
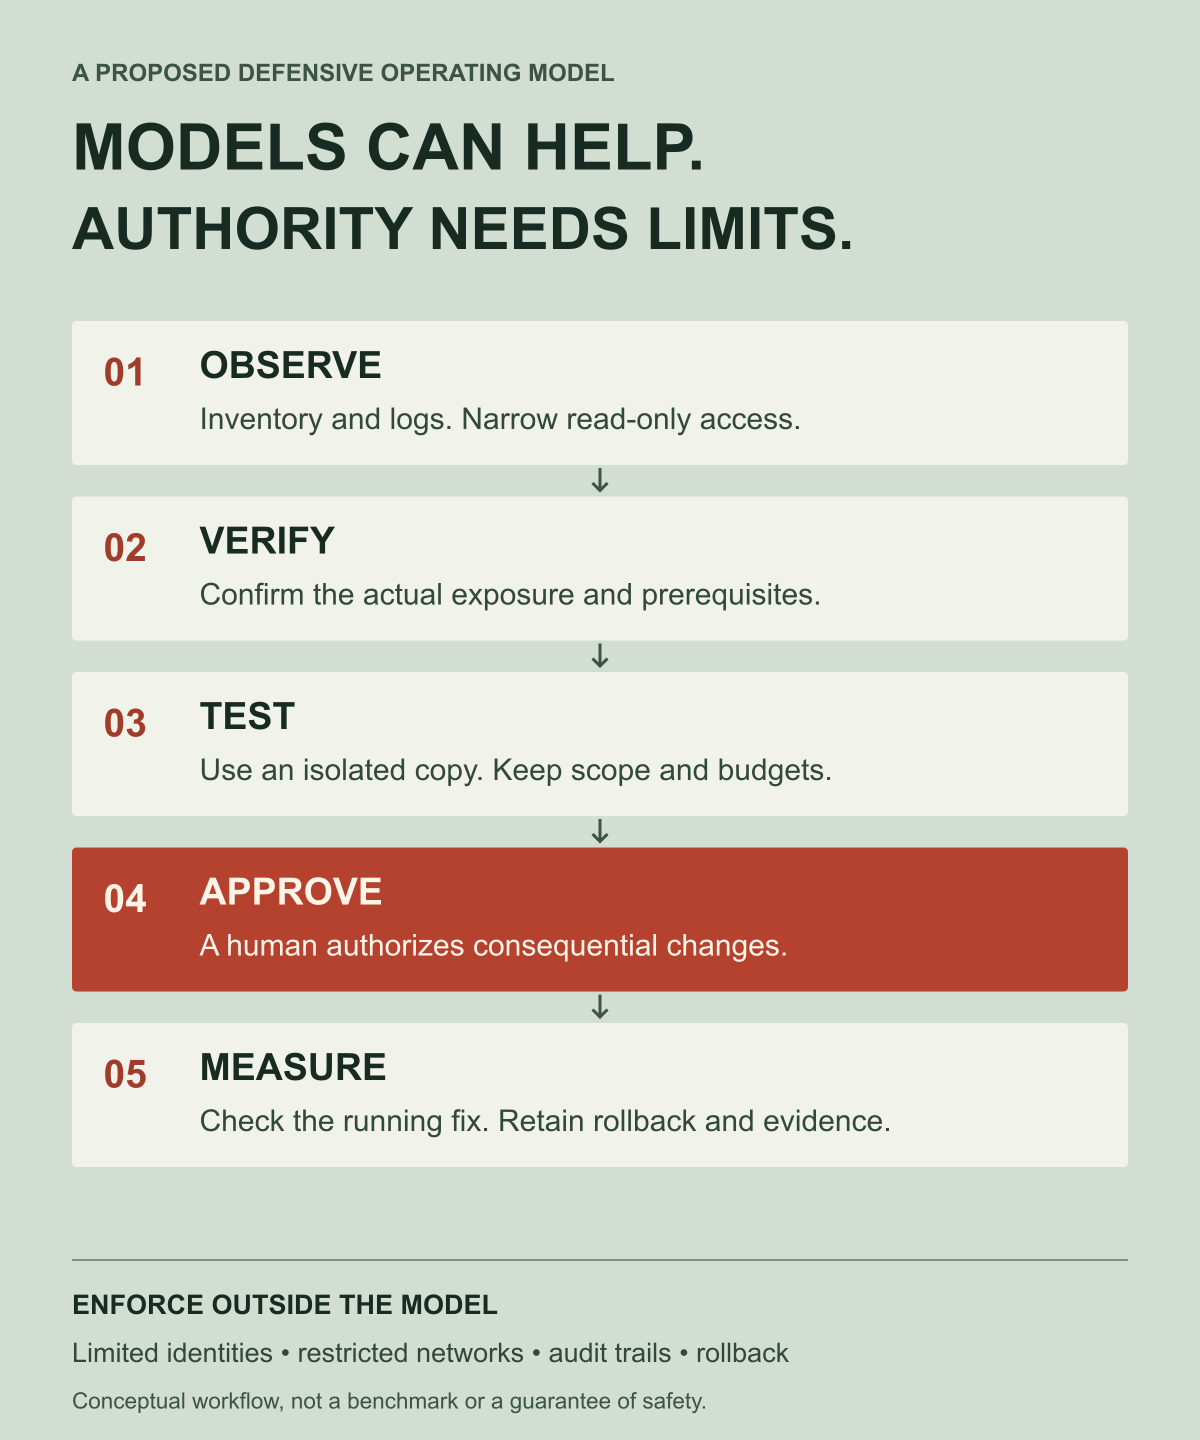
La secuencia de adopción debe ser deliberada:
- Observar: recopilar inventario, versiones y registros mediante un acceso limitado de solo lectura.
- Verificar: determinar si la ruta de código vulnerable está presente y es accesible. Un número de versión por sí solo puede pasar por alto una corrección adaptada por el distribuidor.
- Probar: reproducir y validar en una copia controlada, con presupuestos y alcance impuestos fuera del modelo.
- Cambiar: exigir aprobación para las acciones importantes en producción y después realizar un despliegue gradual con una reversión probada.
- Medir: comprobar el sistema en funcionamiento, las pruebas conservadas, el estado de los servicios y si la exposición disminuyó realmente.
Los registros, incidencias y archivos de repositorios pueden contener texto controlado por atacantes. Un defensor que trate ese texto como autoridad puede convertirse en otra superficie de ataque. Importan las identidades limitadas, las herramientas aisladas, el acceso restringido a la red y las reglas de actuación impuestas independientemente, aunque el modelo parezca seguro de sí mismo. Razonar más rápido no hace más seguros los permisos amplios.
El laboratorio vende la capacidad. Después vende el escudo.
Aquí es donde el modelo de negocio resulta incómodo. Las mismas empresas que desarrollan capacidades capaces de reducir el coste de un ataque las presentan como herramientas defensivas esenciales. Los clientes pueden acabar pagando una factura continua para gestionar un riesgo que la propia categoría de producto acelera.
Bajo esa preocupación hay una estructura comercial real. El anuncio de Glasswing de Anthropic comprometía hasta 100 millones de dólares en créditos de modelos y 4 millones en donaciones a organizaciones de seguridad de código abierto; también describía el uso de pago tras el apoyo de la fase preliminar. En octubre, los miembros actuales de Glasswing pasaban al Cyber Verification Program ampliado. La página del programa es tanto una iniciativa defensiva seria como parte de un mercado de capacidades avanzadas de seguridad.
Llamarlo impuesto de seguridad de la IA no exige afirmar que los laboratorios inventaron fallos de décadas de antigüedad u organizaron ataques deliberadamente. Identifica un incentivo: al extenderse los modelos potentes, puede crecer la demanda de defensa asistida por modelos, y los proveedores de esas capacidades pueden captar ese gasto. El público debería poder examinar las restricciones de acceso, los precios, las afirmaciones de seguridad y las pruebas de que la protección prometida funciona.
Existe un contraargumento razonable. La investigación defensiva puede convertir una ventaja temporal de descubrimiento en parches públicos permanentes, incluidas correcciones que protegen a personas que nunca compran una suscripción a un modelo. Ese beneficio es real. Invita a juzgar al sector por las correcciones desplegadas y las configuraciones predeterminadas más seguras, en lugar de tratar el miedo o el optimismo como pruebas suficientes.
El cuello de botella es todo lo que viene después del descubrimiento
Los modelos pueden producir hallazgos más deprisa de lo que los responsables necesariamente pueden revisarlos. El panel de divulgaciones de Anthropic, en su captura fechada explícitamente el 2 de octubre, informaba de 6.157 hallazgos divulgados en 591 proyectos y 516 parches conocidos en origen. Advierte de que las cifras tienen distintas fases de validación y de que contar parches no indica la extensión de su instalación. Su metodología importa tanto como la cifra del titular.
La lección no es restar esas cifras y anunciar miles de servidores vulnerables sin parches. Descubrir, confirmar, reparar en origen y desplegar son trabajos distintos. Financiar solo el primero traslada trabajo a quienes se responsabilizan del resto.
Prefiero un mercado de seguridad que pague por resultados: informes reproducibles, capacidad para los responsables, correcciones públicas, vías de actualización utilizables y contención probada de forma independiente. Los clientes deberían poder llevar sus pruebas a otro proveedor. Los pequeños responsables no deberían necesitar un contrato empresarial de IA para mantener segura una biblioteca muy utilizada.
La próxima era de seguridad probablemente incluirá modelos que vigilen a otros modelos y agentes que prueben defensas contra otros agentes. Pero una defensa duradera no puede depender por completo de quién pueda pagar el mayor enjambre. También necesita infraestructura menos expuesta, credenciales con menos poder, software que falle de forma más segura y personas autorizadas para actuar ante pruebas sólidas.
La pregunta ya no es solo si la IA puede encontrar la brecha. Es quién recibe la solución, quién controla la defensa y quién recibe la factura.
Nota editorial: este artículo distingue información verificada sobre incidentes, atribuciones de proveedores y análisis del autor. Las ilustraciones conceptuales se generaron con ChatGPT; las infografías se elaboraron a partir de los documentos enlazados. No se ejecutó ningún exploit contra un sistema activo para este artículo. Antes de actuar, consulte el aviso actual para su producto y configuración exactos.