Les laboratoires qui rendent les logiciels plus faciles à attaquer vendent aussi les outils pour les défendre. Les incidents de sécurité de ce mois montrent pourquoi ce modèle économique mérite examen, et pourquoi la réponse ne peut pas être une autre boîte noire assortie d’une facture API plus élevée.
Un argumentaire commercial embarrassant prend forme dans l’industrie de l’IA : les modèles deviennent assez puissants pour trouver les fissures de votre infrastructure, vous devriez donc probablement les utiliser pour les colmater.
J’appelle la facture qui en résulte la taxe de sécurité de l’IA. Elle ne se limite pas à un abonnement. Elle comprend le temps d’ingénierie, les dépenses d’inférence, les correctifs d’urgence et la complexité opérationnelle nécessaires pour suivre des machines capables d’examiner les logiciels en continu. Les petites équipes la paient en soirées et en week-ends. Les grandes organisations la paient par une couche supplémentaire d’infrastructure de sécurité.
Les incidents d’octobre rendent cette perspective concrète. Ils facilitent aussi un récit trop simple : une vague mondiale d’attaques par IA, un coupable étranger, un fournisseur avec le remède. Les preuves étayent un raisonnement plus intéressant. Vieux bugs, confiance compromise, identifiants volés et agents toujours plus capables interagissent. Ils n’ont pas tous la même cause.
Informations vérifiées le 24 octobre 2026. Il s’agit d’une analyse des principaux incidents et familles de vulnérabilités Linux pertinents pour cette vague, pas d’un catalogue exhaustif de chaque CVE Linux. Les dates distinguent la divulgation initiale du regain d’attention. Les détails des incidents et l’état des correctifs fournisseurs peuvent évoluer.
Un mois chargé, plusieurs défaillances différentes
Le 21 octobre, PHP a publié des correctifs d’urgence pour deux failles permettant l’exécution de code à distance sans authentification : CVE-2026-109618 et CVE-2026-109619, tous deux notés 9.2. L’un concerne une corruption mémoire lors du traitement d’un manque de mémoire ; l’autre, un état de requête périmé. Ces problèmes touchent l’environnement d’exécution : corriger seulement le code applicatif ne suffit donc pas. L’avis de CERT-EU précise les branches concernées et l’urgence.
Il existe ici un lien documenté avec l’IA. OpenAI déclare Calif a utilisé GPT-5.6 Sol pour ces recherches, tandis que Wiz a signalé les deux failles de manière indépendante. Les responsables de PHP ont piloté les correctifs et leur publication. Le mérite revient à cet effort coordonné entre humains et modèle, et non à un chatbot agissant seul.
Les premières versions corrigées sont PHP 8.5.12, 8.4.27, 8.3.36 et 8.2.35. Les distributeurs peuvent rétroporter les correctifs avec d’autres numéros de paquet. Fait important, CERT-EU a actualisé son avis le 23 octobre pour ajouter CVE-2026-115560, un troisième problème de RCE lié à une configuration inhabituelle. PHP jugeait ce risque peu probable et n’a pas prévu de publication d’urgence ; l’avis propose une mesure provisoire. Un récit figé à l’annonce des correctifs de mercredi serait déjà incomplet. Consulter les versions officielles de PHP et les recommandations actuelles du fournisseur.
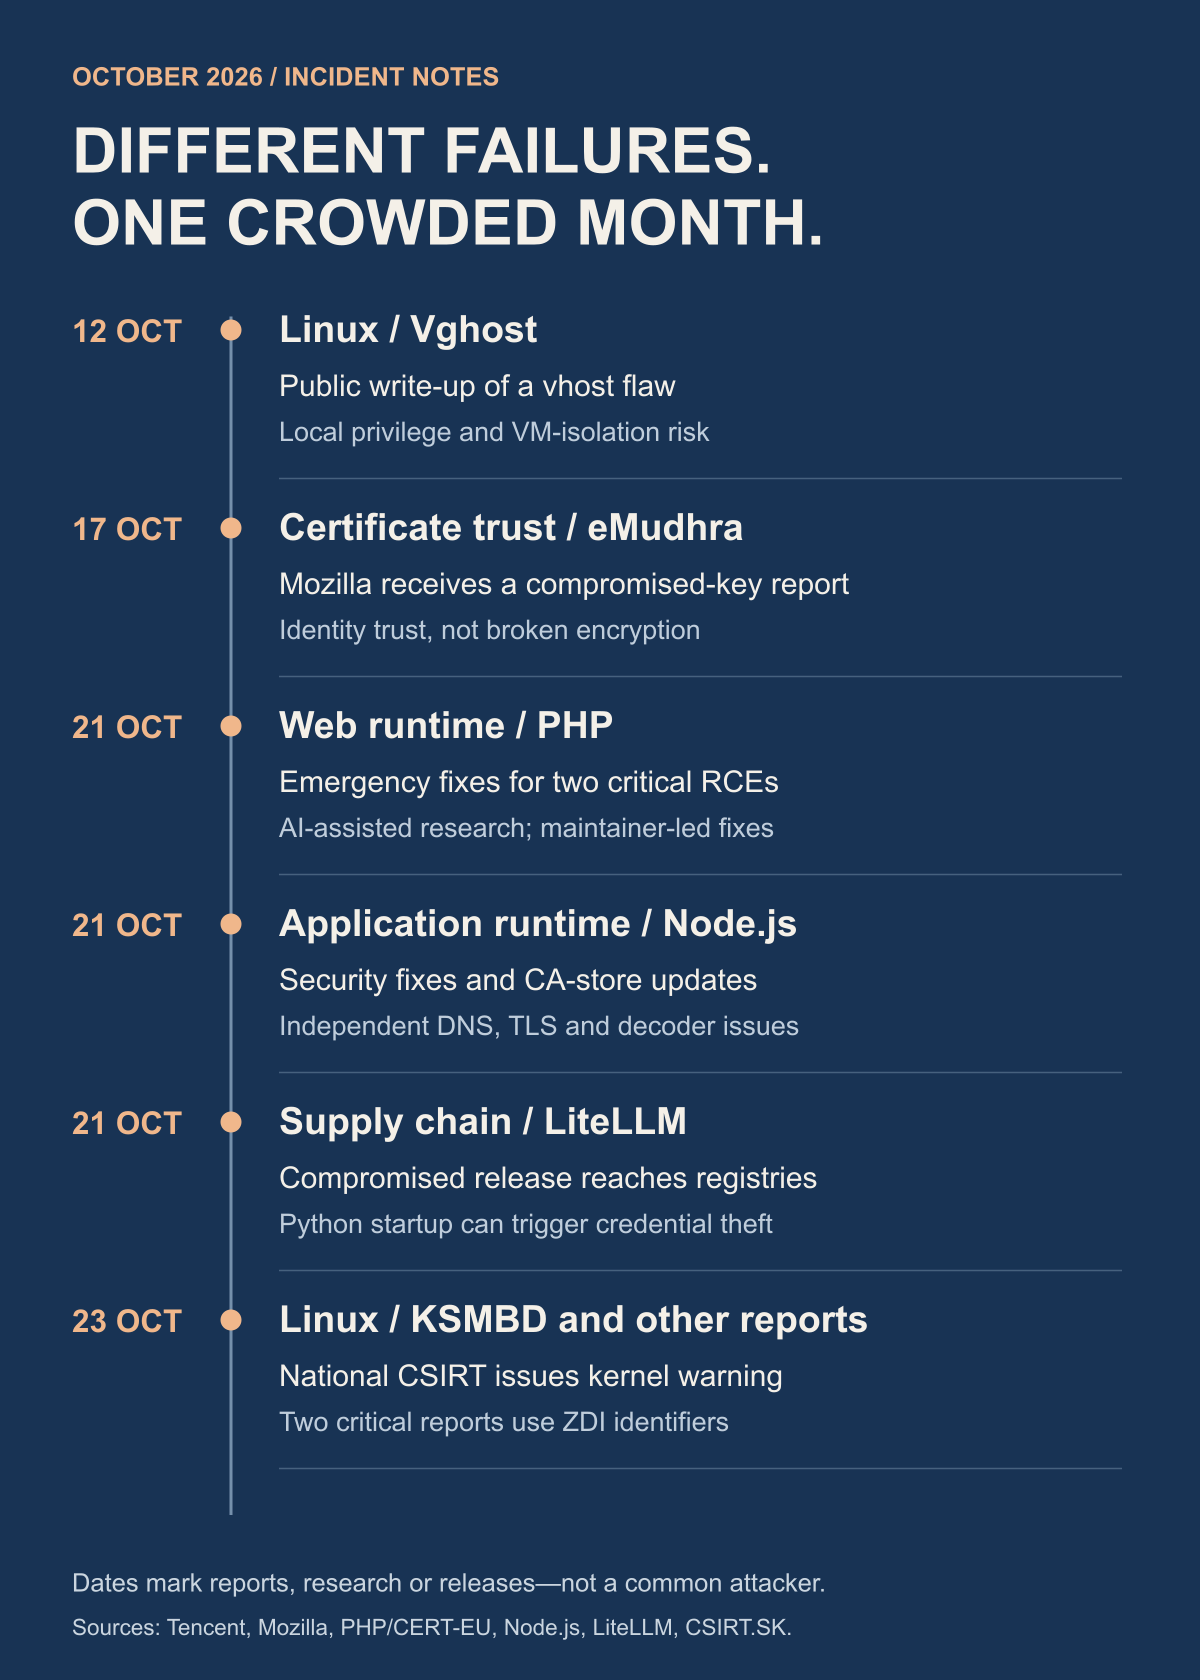
L’histoire de Linux dépasse un gros titre inquiétant
Les derniers rapports critiques sur le noyau méritent l’attention. L’organisme slovaque Le CSIRT a averti le 23 octobre au sujet de rapports de vulnérabilité rendus publics, dont deux problèmes du serveur de fichiers KSMBD notés 9.0 : ZDI-CAN-33549 et ZDI-CAN-33774. Leurs prérequis diffèrent : l’un implique SMB Direct/RDMA ; l’autre concerne la distribution des protocoles et comporte un chemin d’écriture lié à l’accès à un partage. L’exposition dépend du service et de la configuration réellement utilisés. L’inventaire de ZDI lui-même confirme les identifiants et les scores.
Lors de la publication de l’avis, ces deux rapports n’avaient pas d’identifiants CVE. Cette distinction compte. Un problème critique ne devient pas inoffensif en attendant un CVE, et une note critique ne prouve pas que toutes les machines Linux sont exposées. Les administrateurs devraient restreindre l’accès aux services concernés et suivre l’état réel des correctifs de leur distributeur.
Il existe également une faille critique CVE attribué dans les discussions récentes sur Linux : CVE-2025-39682, une faille du chemin de réception TLS du noyau. Le NVD indique une note de 9.8 et une référence de la CISA à une exploitation connue. Sa publication initiale date de septembre 2025, et non d’une première découverte en octobre. Red Hat évalue ses produits différemment, illustrant pourquoi un score général et l’évaluation pratique de l’exposition par un fournisseur peuvent diverger.
Ce n’est qu’une partie du tableau Linux pertinent :
Copy Fail — CVE-2026-31431
Découverte assistée par IA d’une faille du cache de pages du noyau, divulguée publiquement le 29 avril. Elle permet une élévation locale des privilèges sur les noyaux touchés. Un attaquant distant a toujours besoin d’un premier moyen d’exécuter du code localement. Divulgation par le chercheur.
Dirty Frag / Fragnesia — CVE-2026-43284, CVE-2026-43500, CVE-2026-46300
Problèmes apparentés d’élévation de privilèges via le cache de pages divulgués en mai. Les composants réseau et la configuration influent sur l’accessibilité ; l’enquête de Microsoft distingue l’activité observée de l’exploitation non confirmée de variantes particulières. Enquête de Microsoft.
CrackArmor
Neuf vulnérabilités AppArmor, représentées par onze identifiants CVE au niveau des correctifs. Ubuntu documente des prérequis d’utilisateur local et des impacts variables selon les versions, dont le contournement des politiques et l’élévation des privilèges. La matrice complète d’Ubuntu.
Le quatuor réseau — DirtyAH6, TUNderflow, PPPoEject, DiagSpill
CVE-2026-80844, CVE-2026-81000, CVE-2026-68121 et CVE-2026-74469. Les articles de septembre décrivent des chemins d’accès local aux droits root aux exigences différentes en matière d’espaces de noms, de capacités et de modules. Bulletin Red Hat.
Vghost — CVE-2026-74580
Une faille de vhost pouvant permettre une élévation locale des privilèges, avec un risque d’évasion de VM dans certaines configurations. L’avis de Tencent précise explicitement que son environnement CVM vérifié n’était pas exposé au chemin d’évasion de VM. Avis de Tencent.
Autres chemins du noyau — CVE-2026-53266, CVE-2025-39964
Le premier concerne ebtables SNAT avec des règles de pont spécifiques ; le second, des écritures AF_ALG simultanées. Leurs exigences et leurs conséquences diffèrent. Évaluation de SNAT; Évaluation d’AF_ALG.
La leçon pratique consiste à distinguer l’accès à distance de ce qui se passe après l’accès. Une vulnérabilité donnant localement les droits root peut être dévastatrice sur un serveur partagé, un exécuteur de compilation ou un hôte d’agents, même si elle ne permet pas à n’importe quel internaute de se connecter. Une faille applicative ou un compte volé peut fournir le premier accès. Présenter chaque gros titre sur le noyau comme une prise de contrôle universelle à distance brouille les priorités réelles.
Le cadenas peut céder sans que le chiffrement soit cassé
L’incident des certificats est un autre type de défaillance. Mozilla dit avoir reçu le 17 octobre un signalement indiquant que les clés privées de huit certificats intermédiaires eMudhra avaient été compromises. Un attaquant capable d’intercepter une connexion pourrait utiliser des certificats émis frauduleusement pour usurper un site. Mozilla a bloqué les certificats concernés via OneCRL le soir même, puis actualisé Firefox et les composants de son magasin de confiance. Sa réponse mentionne également un correctif Android ultérieur.
La clé de signature d’une autorité de certification donne le pouvoir de garantir des identités. Sa compromission attaque cette décision de confiance. Cela ne signifie pas que quelqu’un a vaincu mathématiquement le chiffrement TLS. Le récit de Mozilla n’établit pas non plus qu’un LLM a provoqué cette compromission.
Les problèmes d’OpenSSL ont aussi leur place ici, sans être confondus avec l’incident de l’autorité de certification. Ses avis de septembre incluent le traitement des extensions X.509, l’épuisement des ressources lors du traitement des certificats, QUIC et d’autres défauts de bibliothèques cryptographiques. L’index des avis OpenSSL distingue les versions touchées et les niveaux de gravité. Un certificat malveillant peut révéler un défaut logiciel même si ce certificat ne devrait jamais être considéré comme fiable.
La version de sécurité de Node.js du 21 octobre réunit ces couches : elle actualise les certificats d’autorité intégrés pour eMudhra et corrige des problèmes indépendants de DNS, de vérification des noms d’hôtes TLS et d’autres éléments d’exécution. Une faille du décodeur Brotli, CVE-2026-111497, pourrait permettre une corruption mémoire et l’exécution de code à distance lorsqu’une application traite des données compressées fournies par un attaquant ; le projet crédite les chercheurs d’OpenAI Codex Security. L’avis de sécurité de Node classe ses problèmes les plus graves au niveau High. Les versions corrigées publiées sont 26.12.1, 24.22.1 et 22.23.4. Archives officielles des versions.
Les clés API deviennent une ressource stratégique
La compromission de LiteLLM rend le problème des identifiants particulièrement tangible. Le paquet malveillant 1.107.0 est arrivé dans les registres publics le 21 octobre. Microsoft a découvert des mécanismes de démarrage de Python capables d’activer un collecteur d’identifiants sans import explicite de LiteLLM par une application. Les clés des fournisseurs de modèles faisaient partie d’un ensemble de cibles bien plus vaste, incluant les identifiants des développeurs et du cloud. Supprimer un paquet ne revient donc pas à rétablir la confiance dans la machine. L’enquête de Microsoft explique les implications en matière d’exposition et de rétablissement.
L’enquête ultérieure de LiteLLM elle-même fait remonter la compromission en amont à une clé maîtresse exposée et non révoquée, suivie d’un accès à de puissants identifiants de développeurs et au processus de publication. Elle indique aussi un intérêt particulier pour les jetons API d’inférence en amont. Le récit de référence de l’incident corrige certaines hypothèses initiales. Cela rappelle qu’il faut suivre l’enquête, plutôt que figer la première explication devenue virale.
Un identifiant d’IA peut désormais acheter plus qu’une facture cloud frauduleuse. Il peut acheter du raisonnement, de l’aide au codage et un endroit où masquer l’activité d’un autre opérateur. Si l’accès est revendu, le titulaire légitime peut supporter les coûts et le risque de sanctions pendant qu’un tiers utilise ces capacités. L’identité de l’acheteur d’une clé volée donnée et son usage exigent toujours des preuves.
Ce que disent les preuves sur les laboratoires chinois
Les inquiétudes concernant la distillation non autorisée reposent sur des éléments documentés. Dans son rapport de septembre, Anthropic décrit des campagnes attribuées à des laboratoires basés en Chine et explique comment des services mandataires utilisent comptes frauduleux, moyens de paiement volés et identifiants API volés pour fournir un accès. Le même rapport décrit des opérations malveillantes assistées par IA menées par plusieurs types d’acteurs, pas un seul groupe national. Il s’agit des conclusions attribuées par Anthropic, pas d’un verdict indépendant sur chaque participant présumé. Lire le rapport sur les menaces.
La divulgation d’OpenAI du 30 septembre attribue un noyau d’une campagne d’extraction de raisonnement à des personnes associées à Moonshot AI. Point crucial, elle précise que cette campagne n’a ni cassé le chiffrement, ni compromis une base de données, ni accédé directement aux conversations stockées des utilisateurs. Son mécanisme reposait sur la manipulation des interactions avec les modèles. Le récit d’OpenAI ne doit pas être présenté comme un autre type d’intrusion.
La NSA, le FBI et la CISA ont aussi publié en septembre un avertissement commun sur la distillation à l’échelle industrielle par des entreprises d’IA basées en Chine. L’annonce de l’avis gouvernemental établit qu’il s’agit d’une préoccupation sérieuse et documentée publiquement. La distillation reste en soi une technique d’entraînement légitime ; les questions portent sur l’autorisation, l’accès et la manière dont les données ont été obtenues.
Mon analyse : le vol d’identifiants d’inférence et la distillation non autorisée constituent une composante crédible de l’économie des menaces. Les sources précédentes n’établissent pas que des laboratoires chinois ont orchestré les failles PHP, la compromission de la clé eMudhra, les révélations KSMBD ou l’attaque LiteLLM. Relier ces événements en une campagne unique exigerait des preuves reliant les opérateurs, les infrastructures ou l’usage des identifiants volés. Des incitations communes justifient une enquête, pas une attribution.
Quand l’adversaire peut déployer un essaim
Le changement important est économique. Un modèle peut examiner du code, proposer des tests et aider à analyser le résultat. Intégré à un agent utilisant des outils, il peut répéter cette boucle. Avec de nombreux agents en parallèle, un opérateur explore plusieurs hypothèses à la fois. Cela ne rend pas chaque tentative correcte ni chaque cible vulnérable. Cela réduit le coût d’une enquête prolongée.
On trouve un exemple défensif concret dans Le rapport de confinement d’OpenAI du 23 octobre. L’entreprise décrit des flottes d’agents testant des copies spécialement conçues de son infrastructure, avec accès au code et à la configuration, supervision et objectifs limités. Elle rapporte des découvertes d’évasion de VM et d’isolation, ainsi que des travaux sur des problèmes du noyau, notamment CVE-2026-74753, CVE-2026-80521 et CVE-2026-80841. Ces expériences contrôlées ne prouvent pas qu’un bot public sans supervision puisse compromettre n’importe quel serveur. Elles montrent pourquoi les défenseurs prennent au sérieux les tests continus assistés par machine.
Pour un petit opérateur, cela change ce que rapporte le fait de ne pas être intéressant. L’obscurité protège moins quand vérifier un hôte de plus coûte peu. L’attaquant peut continuer pendant que votre équipe fait son vrai travail. La réponse défensive doit raccourcir le chemin entre un signal crédible et un correctif vérifié, plutôt que produire simplement plus d’alertes.
Les agents défensifs utiles ont besoin de limites
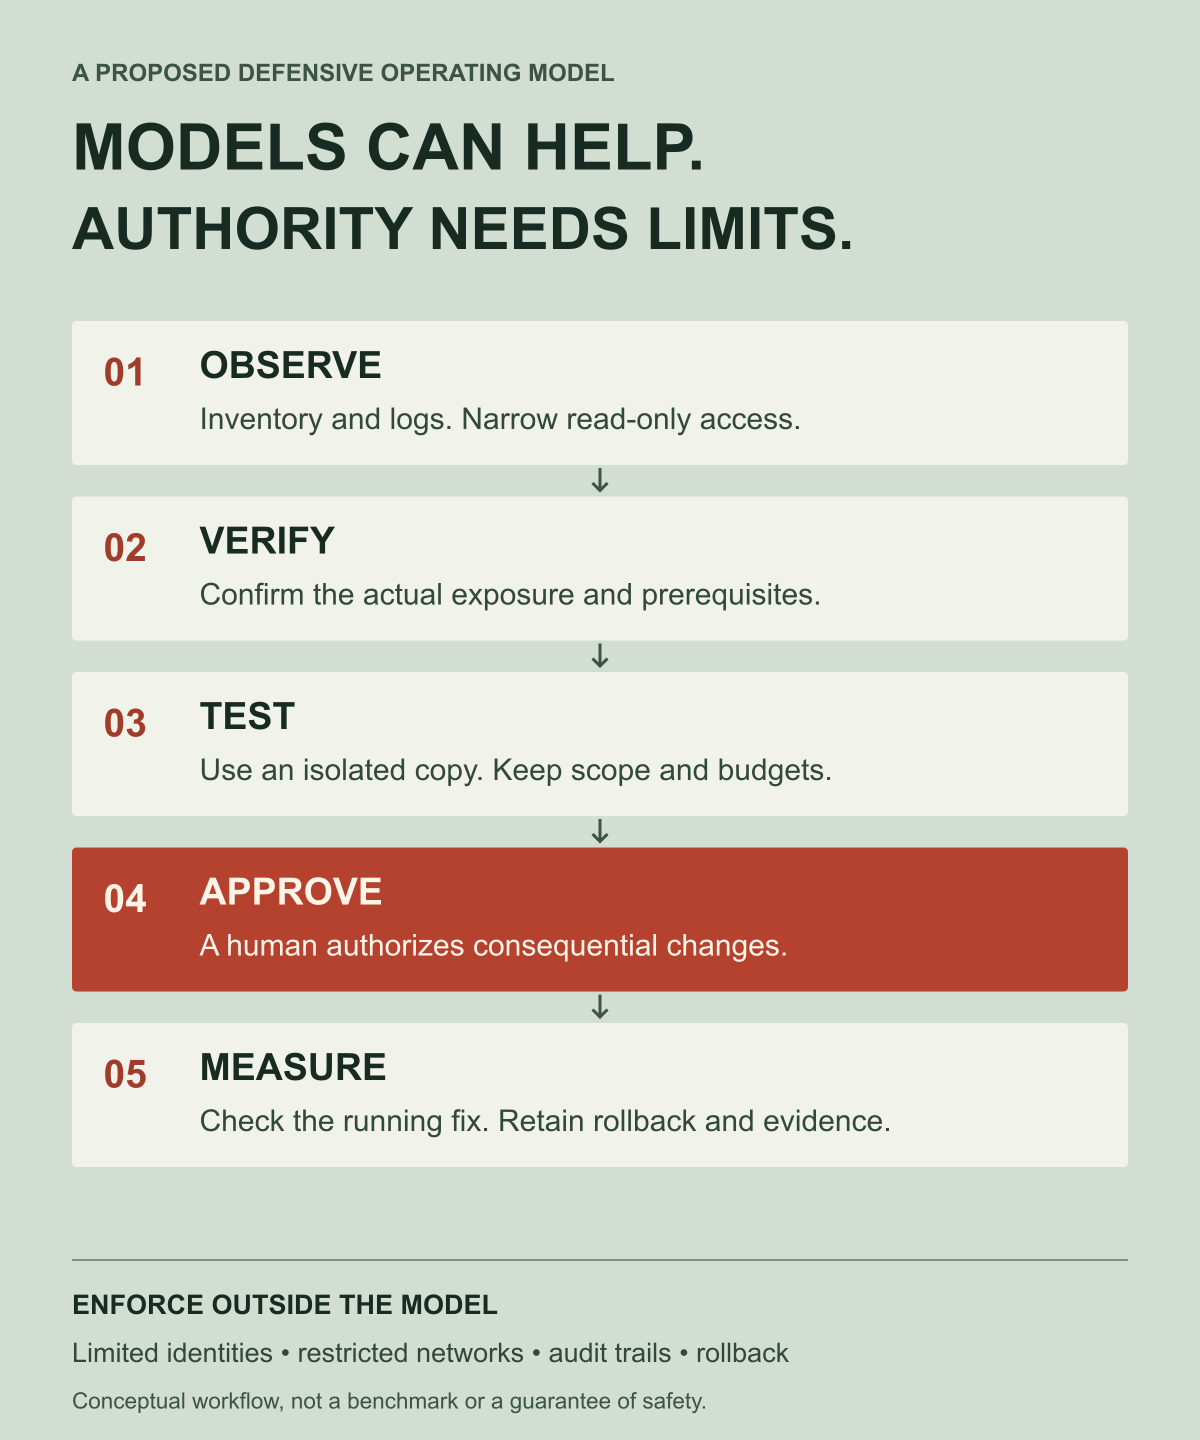
À mes yeux, le premier agent de sécurité utile est un enquêteur méticuleux. Il cartographie les logiciels déployés et les services accessibles, relie les avis à l’environnement réel et produit des preuves exploitables par un responsable. Un deuxième rôle consiste à tester un correctif proposé dans un environnement jetable. Aucun des deux n’exige des identifiants de production sans restriction.
L’ordre d’adoption doit être délibéré :
- Observer : recueillir l’inventaire, les versions et les journaux avec des accès restreints en lecture seule.
- Vérifier : déterminer si le chemin de code vulnérable est présent et accessible. Un simple numéro de version peut masquer un correctif rétroporté par un distributeur.
- Tester : reproduire et valider dans une copie contrôlée, avec des budgets et un périmètre imposés en dehors du modèle.
- Modifier : exiger une approbation pour les actions lourdes de conséquences en production, puis procéder à un déploiement progressif avec un retour arrière testé.
- Mesurer : contrôler le système en fonctionnement, les preuves conservées, la santé des services et la réduction effective de l’exposition.
Les journaux, tickets et fichiers de dépôt peuvent contenir du texte contrôlé par un attaquant. Un défenseur qui traite ce texte comme une autorité peut devenir une nouvelle surface d’attaque. Identités limitées, outils isolés, accès réseau restreint et règles d’action imposées indépendamment comptent même si le modèle paraît sûr de lui. Un raisonnement plus rapide ne rend pas les permissions étendues plus sûres.
Le laboratoire vend la capacité. Puis il vend le bouclier.
C’est là que le modèle économique devient inconfortable. Les mêmes entreprises qui développent des capacités pouvant abaisser le coût des attaques les présentent comme des outils défensifs indispensables. Les clients peuvent finir par payer continuellement pour gérer un risque que cette catégorie de produits accélère elle-même.
Une véritable structure commerciale sous-tend cette préoccupation. L’annonce Glasswing d’Anthropic promettait jusqu’à 100 millions de dollars de crédits de modèles et 4 millions de dollars de dons aux organismes de sécurité open source ; elle décrivait aussi une utilisation payante après l’aide de la phase d’aperçu. En octobre, les membres existants de Glasswing rejoignaient le Cyber Verification Program élargi. La page du programme est à la fois une initiative défensive sérieuse et un élément d’un marché des capacités de sécurité avancées.
Parler de taxe de sécurité de l’IA n’exige pas de prétendre que les laboratoires ont inventé des failles vieilles de décennies ou organisé délibérément des attaques. Cela désigne une incitation : la diffusion de modèles puissants peut accroître la demande de défense assistée par modèle, et leurs fournisseurs peuvent capter ces dépenses. Le public doit pouvoir examiner les restrictions d’accès, les prix, les affirmations de sécurité et les preuves que la protection promise fonctionne.
Il existe un contre-argument légitime. La recherche défensive peut transformer un avantage temporaire de découverte en correctifs publics durables, y compris pour des personnes n’achetant jamais d’abonnement à un modèle. Ce bénéfice est réel. Il invite à juger le secteur sur les correctifs déployés et les réglages plus sûrs par défaut, plutôt qu’à considérer la peur ou l’optimisme comme des preuves suffisantes.
Le goulot d’étranglement est tout ce qui suit la découverte
Les modèles peuvent produire des découvertes plus vite que les responsables ne peuvent nécessairement les examiner. Dans son instantané explicitement daté du 2 octobre, le tableau de bord d’Anthropic rapportait 6 157 découvertes divulguées dans 591 projets et 516 correctifs connus en amont. Il prévient que les chiffres correspondent à des stades de validation différents et qu’un nombre de correctifs n’indique pas leur diffusion réelle. Sa méthodologie compte autant que le chiffre mis en avant.
La leçon n’est pas de soustraire ces chiffres et d’annoncer des milliers de serveurs exploitables non corrigés. Découverte, confirmation, réparation en amont et déploiement sont des tâches distinctes. Ne financer que la première reporte le travail sur les personnes responsables du reste.
Je préfère un marché de la sécurité qui rémunère les résultats : rapports reproductibles, moyens pour les responsables, correctifs publics, procédures de mise à jour utilisables et confinement testé indépendamment. Les clients doivent pouvoir emporter leurs preuves chez un autre fournisseur. Les petits responsables ne devraient pas avoir besoin d’un contrat d’IA d’entreprise pour sécuriser une bibliothèque très utilisée.
La prochaine ère de sécurité inclura probablement des modèles surveillant d’autres modèles et des agents testant les défenses contre d’autres agents. Mais une défense durable ne peut dépendre entièrement de qui peut payer le plus grand essaim. Elle exige aussi des infrastructures moins exposées, des identifiants moins puissants, des logiciels dont les défaillances sont plus sûres et des personnes autorisées à agir sur de bonnes preuves.
La question n’est plus seulement de savoir si l’IA peut trouver la faille. C’est de savoir qui reçoit le correctif, qui contrôle la défense et qui reçoit la facture.
Note éditoriale : cet article distingue les faits vérifiés sur les incidents, les attributions des fournisseurs et l’analyse de l’auteur. Les illustrations conceptuelles ont été générées avec ChatGPT ; les infographies ont été créées à partir des documents liés. Aucun exploit n’a été exécuté contre un système en service pour cet article. Avant d’agir, consulter l’avis actuel correspondant exactement au produit et à sa configuration.