सॉफ़्टवेयर तोड़ना आसान बनाने वाली प्रयोगशालाएँ उसकी रक्षा के tools भी बेच रही हैं। इस महीने की सुरक्षा घटनाएँ दिखाती हैं कि इस कारोबारी मॉडल की जाँच क्यों होनी चाहिए—और जवाब बड़ा API बिल वाला एक और black box क्यों नहीं हो सकता।
AI उद्योग में एक असहज बिक्री-पिच आकार ले रही है: मॉडल इतने सक्षम हो रहे हैं कि आपके infrastructure की दरारें खोज सकें, इसलिए शायद आपको उन्हें सील करने के लिए भी मॉडल इस्तेमाल करने चाहिए।
इससे बनने वाले बिल को मैं कहता हूँ AI सुरक्षा कर. इसमें केवल सदस्यता शुल्क नहीं है। लगातार सॉफ़्टवेयर जाँचने वाली मशीनों के साथ बने रहने के लिए इंजीनियरिंग समय, inference खर्च, आपातकालीन पैचिंग और संचालन की जटिलता भी लगती है। छोटी टीमें रातों और सप्ताहांत में इसकी कीमत चुकाती हैं। बड़े संगठन सुरक्षा ढाँचे की एक और परत के रूप में भुगतान करते हैं।
अक्टूबर की घटनाएँ इस संभावना को ठोस बनाती हैं। वे एक बहुत सुघड़ कहानी सुनाना भी आसान करती हैं: एक वैश्विक AI हमला-लहर, एक विदेशी दोषी, इलाज वाला एक विक्रेता। साक्ष्य अधिक रोचक तर्क देते हैं। पुराने बग, समझौता हुआ भरोसा, चोरी के credentials और अधिक सक्षम agents परस्पर प्रभाव डाल रहे हैं। सबकी वजह एक नहीं है।
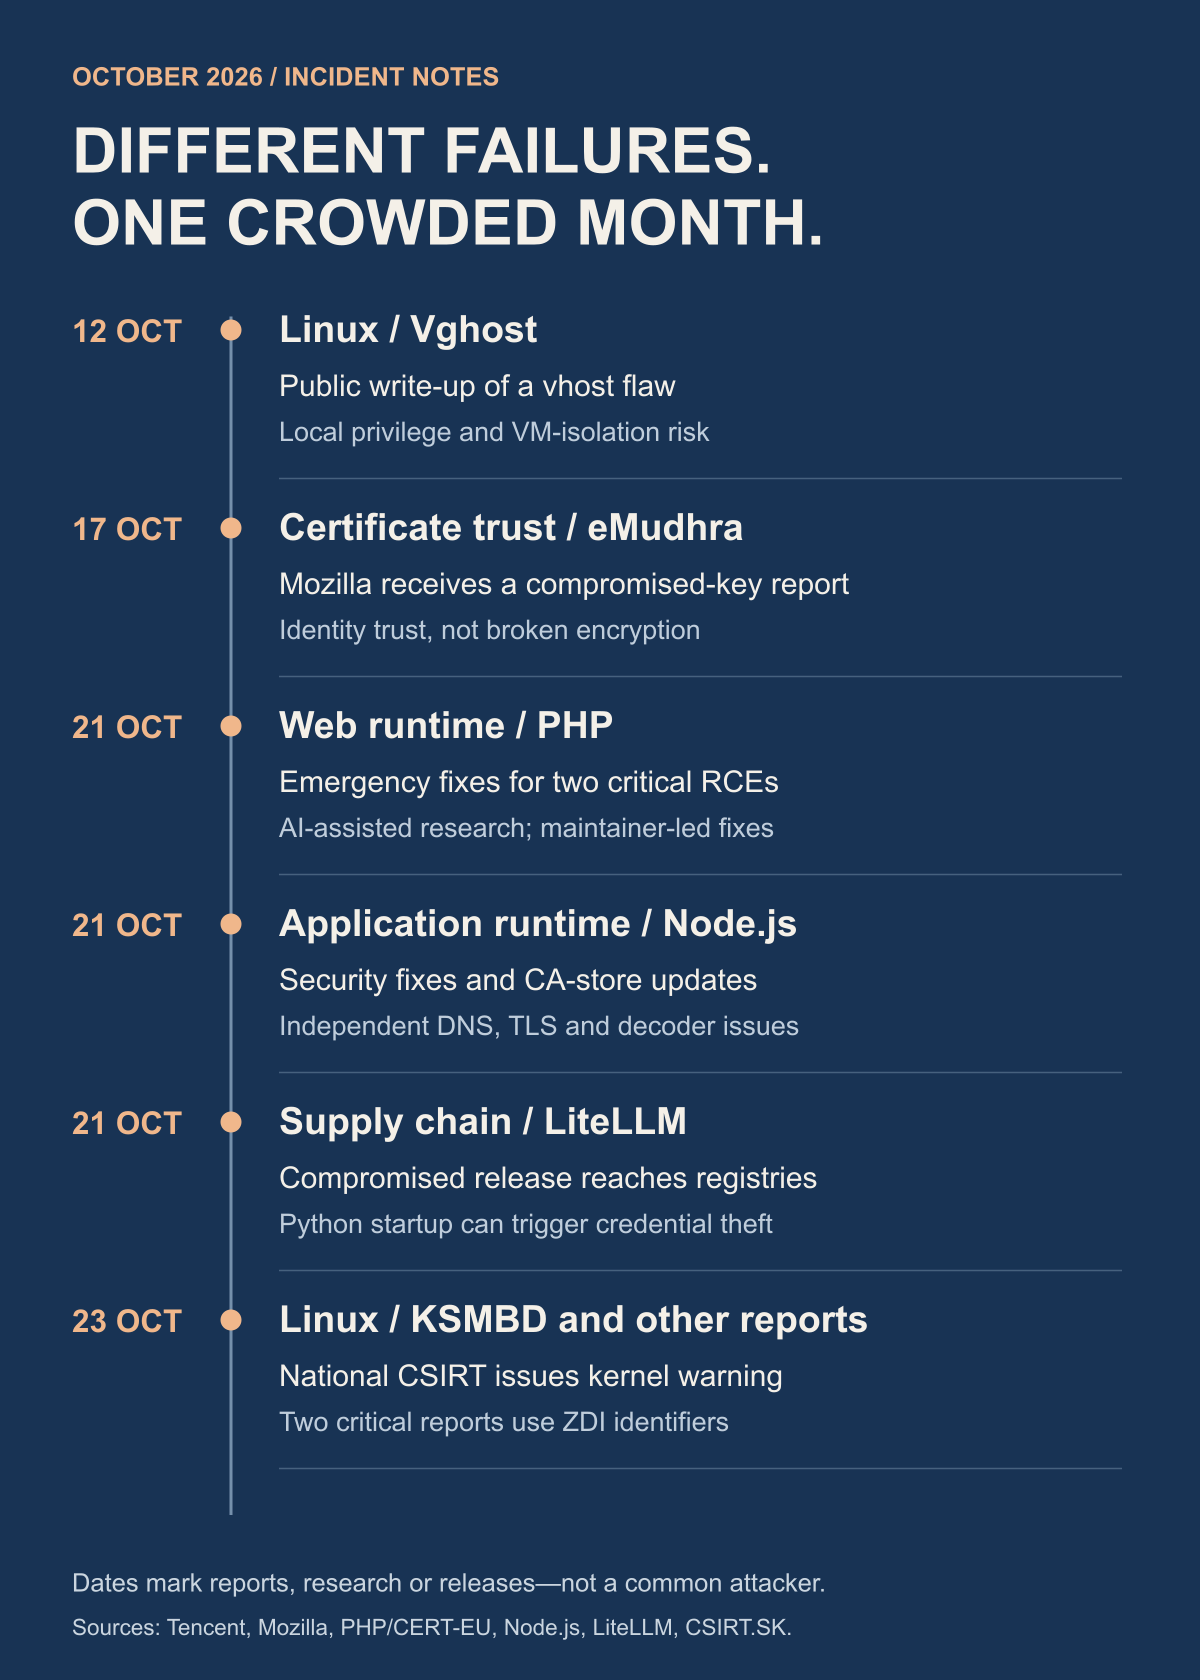
रिपोर्ट 24 अक्टूबर 2026 को जाँची गई। यह इस लहर से जुड़ी प्रमुख घटनाओं और Linux vulnerability परिवारों का विश्लेषण है, हर Linux CVE की संपूर्ण सूची नहीं। नीचे की तारीखें मूल disclosure और नए सिरे से मिले ध्यान में फर्क करती हैं। घटना विवरण और विक्रेता patch स्थिति बदल सकती है।
व्यस्त महीना, कई अलग-अलग विफलताएँ
21 अक्टूबर को PHP ने बिना प्रमाणीकरण वाली remote-code-execution की दो कमजोरियों के लिए आपातकालीन सुधार जारी किए: CVE-2026-109618 और CVE-2026-109619, दोनों को 9.2 रेटिंग मिली। एक में out-of-memory प्रबंधन के दौरान मेमोरी करप्शन है; दूसरी में पुरानी request स्थिति। ये runtime की समस्याएँ हैं, इसलिए केवल एप्लिकेशन कोड ठीक करना पर्याप्त नहीं। CERT-EU की सलाह प्रभावित शाखाएँ और तात्कालिकता बताता है।
यहाँ AI से जुड़ा दस्तावेज़ी संबंध है। OpenAI कहता है शोध में Calif ने GPT-5.6 Sol का उपयोग किया, जबकि Wiz ने स्वतंत्र रूप से दोनों खामियों की रिपोर्ट की। PHP के अनुरक्षकों ने सुधारों और रिलीज़ का नेतृत्व किया। श्रेय मनुष्यों और मॉडल के समन्वित प्रयास को जाता है, अकेले काम करने वाले चैटबॉट को नहीं।
पहली सुधार वाली रिलीज़ PHP 8.5.12, 8.4.27, 8.3.36 और 8.2.35 हैं। वितरण विक्रेता अलग package versions में backport सुधार दे सकते हैं। खास तौर पर CERT-EU ने 23 अक्टूबर को advisory अपडेट कर CVE-2026-115560, असामान्य कॉन्फ़िगरेशन से जुड़ी तीसरी RCE समस्या। PHP ने जोखिम को कम संभावित माना और आपातकालीन रिलीज़ तय नहीं की; सलाह में अंतरिम उपाय दिया गया है। बुधवार की पैच घोषणा पर रुकी कहानी पहले ही अधूरी होगी। आधिकारिक PHP रिलीज़ जाँचें और मौजूदा विक्रेता मार्गदर्शन।
Linux की कहानी एक डरावने शीर्षक से बड़ी है
हाल की गंभीर kernel रिपोर्टों पर ध्यान देना चाहिए। स्लोवाकिया का CSIRT ने 23 अक्टूबर को चेतावनी दी सार्वजनिक रूप से उजागर कमजोरियों की रिपोर्टों के बारे में, जिनमें KSMBD फ़ाइल-सर्वर की दो समस्याएँ शामिल हैं, जिन्हें 9.0 रेटिंग मिली: ZDI-CAN-33549 और ZDI-CAN-33774. उनकी पूर्वशर्तें अलग हैं: एक में SMB Direct/RDMA है; दूसरी protocol dispatch से जुड़ी है और share पहुँच पर निर्भर write-path रखती है। जोखिम वास्तविक सेवा और कॉन्फ़िगरेशन पर निर्भर है। ZDI की अपनी सूची पहचानकर्ताओं और स्कोर की पुष्टि करता है।
सलाह प्रकाशित होने के समय, वे दोनों रिपोर्टें नहीं CVE पहचानकर्ता हैं। यह अंतर महत्वपूर्ण है। CVE की प्रतीक्षा में कोई गंभीर समस्या हानिरहित नहीं हो जाती, और गंभीर स्कोर यह सिद्ध नहीं करता कि हर Linux मशीन जोखिम में है। प्रशासकों को प्रभावित सेवाओं की पहुँच सीमित करनी चाहिए और अपने वितरणकर्ता की वास्तविक सुधार स्थिति देखनी चाहिए।
एक गंभीर CVE सौंपा गया हाल की Linux चर्चा में: CVE-2025-39682, कर्नेल TLS के receive-path की खामी। NVD 9.8 स्कोर और CISA के ज्ञात-शोषित संदर्भ को सूचीबद्ध करता है. यह पहली बार इस अक्टूबर में खोजा नहीं गया था; मूल प्रकाशन सितंबर 2025 में हुआ था। Red Hat अपने उत्पादों का अलग आकलन करता है, इससे स्पष्ट होता है कि सार्वभौमिक स्कोर और विक्रेता का व्यावहारिक जोखिम आकलन अलग हो सकते हैं।
ये प्रासंगिक Linux तस्वीर का केवल एक हिस्सा हैं:
Copy Fail — CVE-2026-31431
29 अप्रैल को सार्वजनिक हुए कर्नेल page-cache दोष की AI-सहायित खोज। प्रभावित कर्नेल पर यह स्थानीय privilege escalation संभव करता है। दूरस्थ हमलावर को स्थानीय निष्पादन तक पहुँचने के लिए फिर भी शुरुआती रास्ता चाहिए। शोधकर्ता का खुलासा.
Dirty Frag / Fragnesia — CVE-2026-43284, CVE-2026-43500, CVE-2026-46300
Page-cache privilege-escalation से जुड़ी कमजोरियाँ मई में सामने आईं। नेटवर्क घटक और कॉन्फ़िगरेशन पहुँच को प्रभावित करते हैं; Microsoft की जाँच देखी गई गतिविधि और अलग-अलग variants के अपुष्ट शोषण में अंतर करती है। Microsoft की जाँच.
CrackArmor
AppArmor की नौ कमजोरियाँ, जिन्हें patch स्तर के ग्यारह CVE identifiers दर्शाते हैं। Ubuntu स्थानीय उपयोगकर्ता की पूर्वशर्तें और रिलीज़ के अनुसार अलग प्रभाव दर्ज करता है, जिनमें policy bypass और privilege escalation शामिल हैं। Ubuntu की पूरी matrix.
नेटवर्किंग चौकड़ी — DirtyAH6, TUNderflow, PPPoEject, DiagSpill
CVE-2026-80844, CVE-2026-81000, CVE-2026-68121 और CVE-2026-74469. सितंबर की रिपोर्टें अलग namespace, capability और module आवश्यकताओं वाले स्थानीय-root रास्तों का वर्णन करती हैं। Red Hat बुलेटिन.
Vghost — CVE-2026-74580
vhost की खामी कुछ कॉन्फ़िगरेशन में स्थानीय privilege escalation और VM-escape जोखिम पैदा कर सकती है। Tencent की सलाह स्पष्ट कहती है कि जाँचा गया CVM परिवेश VM-escape मार्ग के संपर्क में नहीं था। Tencent की सलाह.
कर्नेल के अन्य रास्ते — CVE-2026-53266, CVE-2025-39964
पहली समस्या विशिष्ट bridge नियमों में ebtables SNAT की है; दूसरी concurrent AF_ALG writes की। उनकी आवश्यकताएँ और परिणाम अलग हैं। SNAT आकलन; AF_ALG आकलन.
व्यावहारिक सीख है कि इनमें अंतर करें दूरस्थ प्रवेश से प्रवेश के बाद क्या होता है. साझा सर्वर, build runner या agent host पर स्थानीय root कमजोरी विनाशकारी हो सकती है, भले ही वह किसी भी इंटरनेट आगंतुक को लॉगिन न करने दे। एप्लिकेशन खामी या चोरी हुआ खाता शुरुआती पहुँच दे सकता है। हर कर्नेल खबर को सार्वभौमिक दूरस्थ कब्ज़ा बताने से वे प्रणालियाँ छिप जाती हैं जिन्हें पहले ध्यान चाहिए।
ताला विफल हो सकता है, बिना encryption टूटे
प्रमाणपत्र घटना अलग प्रकार की विफलता है। Mozilla कहता है कि उसे 17 अक्टूबर को सूचना मिली कि eMudhra के आठ intermediate certificates की private keys से समझौता हुआ। कनेक्शन रोक सकने वाला हमलावर धोखे से जारी certificates का उपयोग किसी site का रूप धरने के लिए कर सकता है। Mozilla ने उसी शाम OneCRL के माध्यम से प्रभावित प्रमाणपत्र block किए और बाद में Firefox तथा उसके trust-store घटकों को अद्यतन किया। उसकी प्रतिक्रिया में बाद का Android सुधार भी दर्ज है.
प्रमाणन प्राधिकरण की signing key पहचान की पुष्टि करने का अधिकार देती है। उससे समझौता उस भरोसे के निर्णय पर हमला है। इसका अर्थ यह नहीं कि किसी ने गणितीय रूप से TLS encryption तोड़ दी। Mozilla की रिपोर्ट भी यह स्थापित नहीं करती कि समझौते का कारण LLM था।
OpenSSL समस्याएँ भी इस तस्वीर में आती हैं, लेकिन उन्हें CA घटना से नहीं मिलाना चाहिए। सितंबर की advisories में X.509 extension handling, certificate processing में resource exhaustion, QUIC और अन्य cryptographic-library दोष शामिल हैं। OpenSSL advisory index प्रभावित संस्करणों और गंभीरता को अलग करता है। दुर्भावनापूर्ण प्रमाणपत्र सॉफ़्टवेयर बग उजागर कर सकता है, भले ही उस प्रमाणपत्र पर कभी भरोसा नहीं करना चाहिए।
Node.js की 21 अक्टूबर की सुरक्षा रिलीज़ इन परतों को जोड़ती है: यह eMudhra के लिए bundled CA सामग्री अद्यतन करती है और अलग-अलग DNS, TLS hostname verification तथा runtime समस्याएँ ठीक करती है। Brotli decoder की एक खामी, CVE-2026-111497, हमलावर द्वारा दिए संपीड़ित डेटा को एप्लिकेशन संसाधित करे तो मेमोरी करप्शन और दूरस्थ कोड निष्पादन संभव हो सकता है; परियोजना OpenAI Codex Security शोधकर्ताओं को श्रेय देती है। Node की सुरक्षा सूचना अपनी सबसे गंभीर समस्याओं को High रेट करता है। प्रकाशित सुधार वाली रिलीज़ 26.12.1, 24.22.1 और 22.23.4 हैं। आधिकारिक रिलीज़ संग्रह.
API keys रणनीतिक संसाधन बन रही हैं
LiteLLM समझौता credentials की समस्या को विशेष रूप से ठोस बनाता है। दुर्भावनापूर्ण 1.107.0 पैकेज 21 अक्टूबर को सार्वजनिक registries तक पहुँचा। Microsoft को Python startup hooks मिले जो application द्वारा LiteLLM को स्पष्ट रूप से import किए बिना credential collector चला सकते थे। Model-provider keys बहुत बड़े लक्ष्य-समूह का हिस्सा थीं, जिसमें developer और cloud credentials भी थे। इसलिए एक package हटाना मशीन पर भरोसा बहाल करने के बराबर नहीं। Microsoft की जाँच जोखिम और पुनर्प्राप्ति के निहितार्थ समझाता है।
LiteLLM की बाद की जाँच upstream समझौते का कारण एक उजागर master key बताती है जिसे revoke नहीं किया गया, जिसके बाद शक्तिशाली developer credentials और release प्रक्रिया तक पहुँच मिली। वह upstream inference API tokens हासिल करने पर ध्यान देने की भी रिपोर्ट करती है। आधिकारिक घटना विवरण शुरुआती कुछ धारणाओं को सुधारता है। यह जाँच के साथ आगे बढ़ने की याद दिलाता है, न कि वायरल हुए पहले स्पष्टीकरण को बनाए रखने की।
AI credential अब केवल धोखाधड़ी वाला cloud बिल नहीं खरीदता। यह reasoning, coding सहायता और किसी दूसरे संचालक की गतिविधि छिपाने की जगह खरीद सकता है। यदि पहुँच फिर बेची जाए, तो वैध खाताधारक लागत और प्रवर्तन जोखिम उठाए, जबकि क्षमता कोई और इस्तेमाल करे। किसने कोई विशिष्ट चोरी की key खरीदी और उसका क्या उपयोग किया, इसके लिए अभी भी साक्ष्य चाहिए।
चीनी प्रयोगशालाओं के बारे में साक्ष्य क्या कहते हैं
अनधिकृत distillation की चिंता का दस्तावेज़ी आधार है। सितंबर की रिपोर्ट में Anthropic चीन-आधारित प्रयोगशालाओं से जुड़े अभियानों का वर्णन करता है और बताता है कि proxy सेवाएँ पहुँच देने के लिए धोखाधड़ी वाले खाते, चोरी के भुगतान विवरण और चोरी की API credentials इस्तेमाल कर सकती हैं। वही रिपोर्ट कई प्रकार के actors के दुर्भावनापूर्ण AI-सहायित अभियानों का वर्णन करती है, किसी एक राष्ट्रीय समूह का नहीं। ये Anthropic के attribution वाले निष्कर्ष हैं, हर कथित प्रतिभागी पर स्वतंत्र फैसला नहीं। threat report पढ़ें.
OpenAI का 30 सितंबर का खुलासा reasoning-extraction अभियान के एक मुख्य समूह को Moonshot AI से जुड़े व्यक्तियों से जोड़ता है। अहम बात यह है कि वह कहता है कि अभियान ने encryption नहीं तोड़ी, database से समझौता नहीं किया और सहेजी हुई उपयोगकर्ता बातचीत तक सीधे नहीं पहुँचा। इसका तरीका मॉडल संवादों में हेरफेर था। OpenAI का विवरण को किसी अलग प्रकार के उल्लंघन के रूप में दोबारा नहीं सुनाना चाहिए।
NSA, FBI और CISA ने भी सितंबर में चीन-आधारित AI कंपनियों द्वारा औद्योगिक पैमाने के distillation पर संयुक्त चेतावनी जारी की। सरकारी सलाह की घोषणा यह स्थापित करता है कि यह गंभीर और सार्वजनिक रूप से दर्ज चिंता है। Distillation अब भी प्रशिक्षण की वैध तकनीक है; सवाल अनुमति, पहुँच और डेटा प्राप्त करने के तरीके के हैं।
मेरा आकलन: चोरी हुए inference credentials और अनधिकृत distillation खतरे की अर्थव्यवस्था का विश्वसनीय हिस्सा हैं। ऊपर के स्रोत यह सिद्ध नहीं करते कि चीनी प्रयोगशालाओं ने PHP बग, eMudhra कुंजी समझौता, KSMBD खुलासे या LiteLLM हमले की योजना बनाई। इन घटनाओं को एक अभियान से जोड़ने के लिए संचालकों, बुनियादी ढाँचे या चोरी हुए credentials के उपयोग को जोड़ने वाले साक्ष्य चाहिए। साझा प्रोत्साहन जाँच का कारण हैं, attribution का विकल्प नहीं।
जब दूसरी ओर swarm चल सकता है
महत्वपूर्ण बदलाव आर्थिक है। मॉडल कोड जाँच सकता है, tests सुझा सकता है और नतीजे की जाँच में मदद कर सकता है। उसे tools वाले agent में रखने पर वह चक्र दोहरा सकता है। कई agents समानांतर चलाने पर operator एक साथ कई hypotheses जाँच सकता है। इसका अर्थ यह नहीं कि हर प्रयास सही या हर लक्ष्य कमजोर है। इसका अर्थ है कि लगातार जाँच सस्ती होती है।
एक ठोस रक्षात्मक उदाहरण यहाँ है OpenAI की 23 अक्टूबर की containment रिपोर्ट. कंपनी अपने बुनियादी ढाँचे की विशेष रूप से बनाई प्रतियों को परखने वाले agents के समूह बताती है, जिन्हें स्रोत और कॉन्फ़िगरेशन पहुँच, निगरानी और सीमित उद्देश्य दिए गए हैं। वह VM से बाहर निकलने और isolation संबंधी निष्कर्षों के साथ कर्नेल समस्याओं पर काम का उल्लेख करती है, जिनमें CVE-2026-74753, CVE-2026-80521 और CVE-2026-80841. ये नियंत्रित प्रयोग इस बात का सबूत नहीं कि बिना निगरानी वाला सार्वजनिक bot कोई भी सर्वर तोड़ सकता है। ये बताते हैं कि रक्षक लगातार मशीन-सहायित परीक्षण को गंभीरता से क्यों लेते हैं।
छोटे संचालक के लिए इससे यह बदलता है कि कम दिखाई देने का लाभ कितना है। जब किसी और host की जाँच सस्ती हो, तो गुमनामी कमज़ोर पड़ती है। आपकी टीम अपना काम कर रही हो तब भी हमलावर कोशिश जारी रख सकता है। रक्षात्मक प्रतिक्रिया को केवल और alerts बनाने के बजाय विश्वसनीय संकेत से सत्यापित सुधार तक का रास्ता छोटा करना चाहिए।
उपयोगी रक्षात्मक agents को सीमाएँ चाहिए
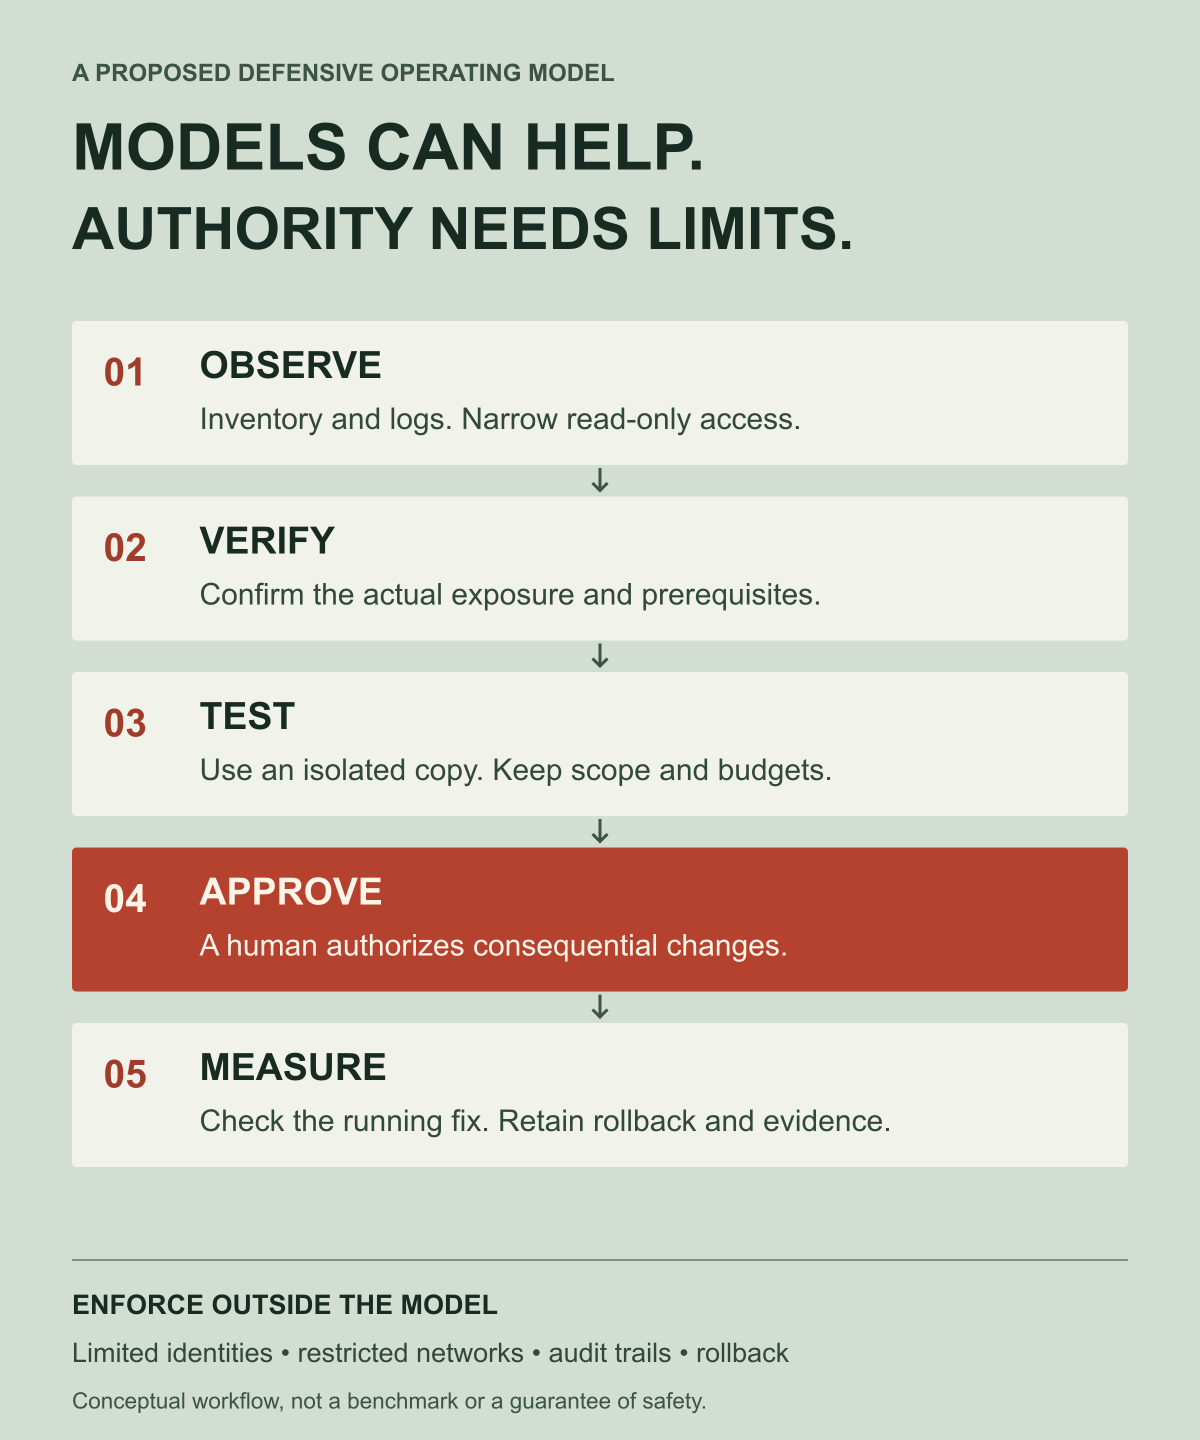
मेरे विचार में पहला उपयोगी सुरक्षा agent एक सावधान जाँचकर्ता है। वह तैनात सॉफ़्टवेयर और पहुँच योग्य सेवाओं का मानचित्र बनाता है, advisories को वास्तविक परिवेश से जोड़ता है और ऐसे साक्ष्य तैयार करता है जिन पर maintainer कार्रवाई कर सके। दूसरी भूमिका disposable परिवेश में प्रस्तावित सुधार जाँचना है। किसी को भी असीमित उत्पादन credentials की ज़रूरत नहीं।
अपनाने का क्रम सोच-समझकर होना चाहिए:
- देखें: सीमित, केवल-पढ़ने योग्य पहुँच से इन्वेंटरी, संस्करण और लॉग जुटाएँ।
- सत्यापित करें: पता करें कि कमजोर कोड-पथ मौजूद है और पहुँच योग्य है या नहीं। केवल संस्करण स्ट्रिंग से वितरणकर्ता का backport छूट सकता है।
- जाँचें: नियंत्रित प्रतिलिपि में पुनरुत्पादित और सत्यापित करें; बजट और दायरा मॉडल के बाहर लागू हों।
- बदलाव: महत्वपूर्ण उत्पादन कार्रवाइयों के लिए मंज़ूरी लें, फिर चरणबद्ध रोलआउट और जाँची हुई वापसी प्रक्रिया अपनाएँ।
- मापें: चल रही प्रणाली, सुरक्षित रखे गए साक्ष्य, सेवा की स्थिति और वास्तव में जोखिम घटा या नहीं—यह जाँचें।
लॉग, tickets और repository फ़ाइलों में हमलावर-नियंत्रित पाठ हो सकता है। जो रक्षक उस पाठ को अधिकार मानता है, वह स्वयं एक और attack surface बन सकता है। सीमित पहचान, अलग-थलग tools, सीमित नेटवर्क पहुँच और स्वतंत्र रूप से लागू action rules तब भी महत्वपूर्ण हैं जब मॉडल आत्मविश्वास से बोलता हो। तेज़ reasoning व्यापक permissions को सुरक्षित नहीं बनाती।
प्रयोगशाला क्षमता बेचती है। फिर सुरक्षा-कवच बेचती है।
यहाँ कारोबारी मॉडल असहज हो जाता है। हमले की लागत घटा सकने वाली क्षमताएँ विकसित करने वाली वही कंपनियाँ उन्हें आवश्यक रक्षात्मक tools के रूप में पेश कर रही हैं। ग्राहक ऐसे जोखिम को संभालने के लिए लगातार भुगतान कर सकते हैं जिसे उत्पाद श्रेणी स्वयं तेज़ कर रही है।
इस चिंता के नीचे वास्तविक व्यावसायिक ढाँचा है। Anthropic की Glasswing घोषणा में model credits के लिए अधिकतम $100 million और open-source सुरक्षा संगठनों को $4 million दान शामिल था; इसमें preview सहायता के बाद भुगतान वाला उपयोग भी बताया गया। अक्टूबर में मौजूदा Glasswing सदस्य विस्तारित Cyber Verification Program में जा रहे थे। कार्यक्रम पृष्ठ एक गंभीर रक्षात्मक पहल भी है और उन्नत सुरक्षा क्षमता के बाजार का हिस्सा भी।
इसे AI सुरक्षा कर कहने के लिए यह दावा करना ज़रूरी नहीं कि प्रयोगशालाओं ने दशकों पुराने बग बनाए या जानबूझकर हमले आयोजित किए। यह एक प्रोत्साहन की ओर संकेत करता है: शक्तिशाली मॉडल फैलने पर मॉडल-सहायित रक्षा की माँग बढ़ सकती है और क्षमता प्रदाता उस खर्च का लाभ उठा सकते हैं। जनता को पहुँच प्रतिबंध, कीमतें, सुरक्षा दावे और वादा की गई सुरक्षा के काम करने के साक्ष्य जाँचने में सक्षम होना चाहिए।
एक उचित प्रतितर्क भी है। रक्षात्मक शोध अस्थायी खोज लाभ को स्थायी सार्वजनिक patches में बदल सकता है, जिनसे वे लोग भी सुरक्षित होते हैं जो मॉडल subscription नहीं खरीदते। यह लाभ वास्तविक है। इससे उद्योग को स्थापित सुधारों और सुरक्षित defaults के आधार पर आँकना चाहिए, न कि डर या आशावाद को पर्याप्त साक्ष्य मानना चाहिए।
अड़चन खोज के बाद की हर चीज़ है
मॉडल निष्कर्ष maintainer की समीक्षा से तेज़ दे सकते हैं। Anthropic के disclosure डैशबोर्ड ने 2 अक्टूबर की स्पष्ट तारीख वाली snapshot में 591 परियोजनाओं पर 6,157 disclosed findings और 516 ज्ञात upstream patches बताए। डैशबोर्ड चेतावनी देता है कि गणनाएँ अलग-अलग validation चरणों में हैं और patch संख्या यह नहीं बताती कि सुधार कितनी जगह स्थापित हुए। इसकी पद्धति शीर्षक के आँकड़े जितनी ही महत्वपूर्ण है.
सीख यह नहीं कि इन संख्याओं को घटाकर हजारों शोषण-योग्य, बिना पैच वाले servers घोषित कर दें। सीख यह है कि खोज, पुष्टि, upstream मरम्मत और deployment अलग काम हैं। केवल पहले काम को वित्त देना बाकी काम के जिम्मेदार लोगों पर बोझ डालता है।
मेरी प्राथमिकता ऐसा सुरक्षा बाज़ार है जो नतीजों के लिए भुगतान करे: पुनरुत्पादित रिपोर्ट, maintainer क्षमता, सार्वजनिक सुधार, उपयोगी update रास्ते और स्वतंत्र रूप से जाँचा गया containment। ग्राहक अपने साक्ष्य दूसरे प्रदाता के पास ले जा सकें। व्यापक रूप से इस्तेमाल होने वाली library सुरक्षित रखने के लिए छोटे maintainers को enterprise AI अनुबंध की ज़रूरत नहीं होनी चाहिए।
सुरक्षा का अगला युग शायद ऐसे मॉडल लाएगा जो मॉडल पर नज़र रखें और agents दूसरे agents की रक्षा जाँचें। लेकिन टिकाऊ रक्षा इस पर निर्भर नहीं हो सकती कि सबसे बड़ा swarm कौन खरीद सकता है। उसे कम उजागर infrastructure, कम अधिकार वाले credentials, अधिक सुरक्षित ढंग से विफल होने वाला software और अच्छे साक्ष्य पर कार्रवाई करने के लिए अधिकृत लोगों की भी ज़रूरत है।
सवाल अब केवल यह नहीं कि AI खामी ढूँढ़ सकता है या नहीं। सवाल है कि सुधार किसे मिलता है, रक्षा कौन नियंत्रित करता है और बिल किसे मिलता है।
संपादकीय टिप्पणी: यह लेख सत्यापित घटना रिपोर्टिंग, विक्रेता attribution और लेखक के विश्लेषण को अलग रखता है। वैचारिक चित्र ChatGPT से बनाए गए; इन्फोग्राफिक्स लिंक किए गए अभिलेखों के आधार पर तैयार किए गए। इस लेख के लिए किसी live system पर exploit नहीं चलाया गया। कार्रवाई से पहले अपने सटीक उत्पाद और कॉन्फ़िगरेशन की मौजूदा सलाह देखें।