Laboratoria ułatwiające łamanie oprogramowania sprzedają również narzędzia do jego obrony. Tegomiesięczne incydenty bezpieczeństwa pokazują, dlaczego ten model biznesowy zasługuje na analizę — i dlaczego odpowiedzią nie może być kolejna czarna skrzynka z większym rachunkiem za API.
W branży AI kształtuje się niezręczna oferta sprzedażowa: modele stają się na tyle potężne, by znaleźć szczeliny w twojej infrastrukturze, więc prawdopodobnie warto użyć ich również do ich załatania.
Powstały rachunek nazywam Podatek od bezpieczeństwa AI. To więcej niż abonament. Wliczają się czas inżynierów, wydatki na inferencję, awaryjne poprawki i złożoność operacyjna potrzebna, by nadążyć za maszynami stale badającymi oprogramowanie. Małe zespoły płacą za to nocami i weekendami. Duże organizacje — kolejną warstwą infrastruktury bezpieczeństwa.
Październikowe incydenty konkretyzują tę perspektywę. Ułatwiają też opowiedzenie zbyt gładkiej historii: jedna globalna fala ataków AI, jeden zagraniczny winowajca, jeden dostawca z lekarstwem. Dowody wspierają ciekawszy argument. Stare błędy, naruszone zaufanie, skradzione dane uwierzytelniające i coraz sprawniejsi agenci wzajemnie na siebie oddziałują. Nie mają jednak jednej wspólnej przyczyny.
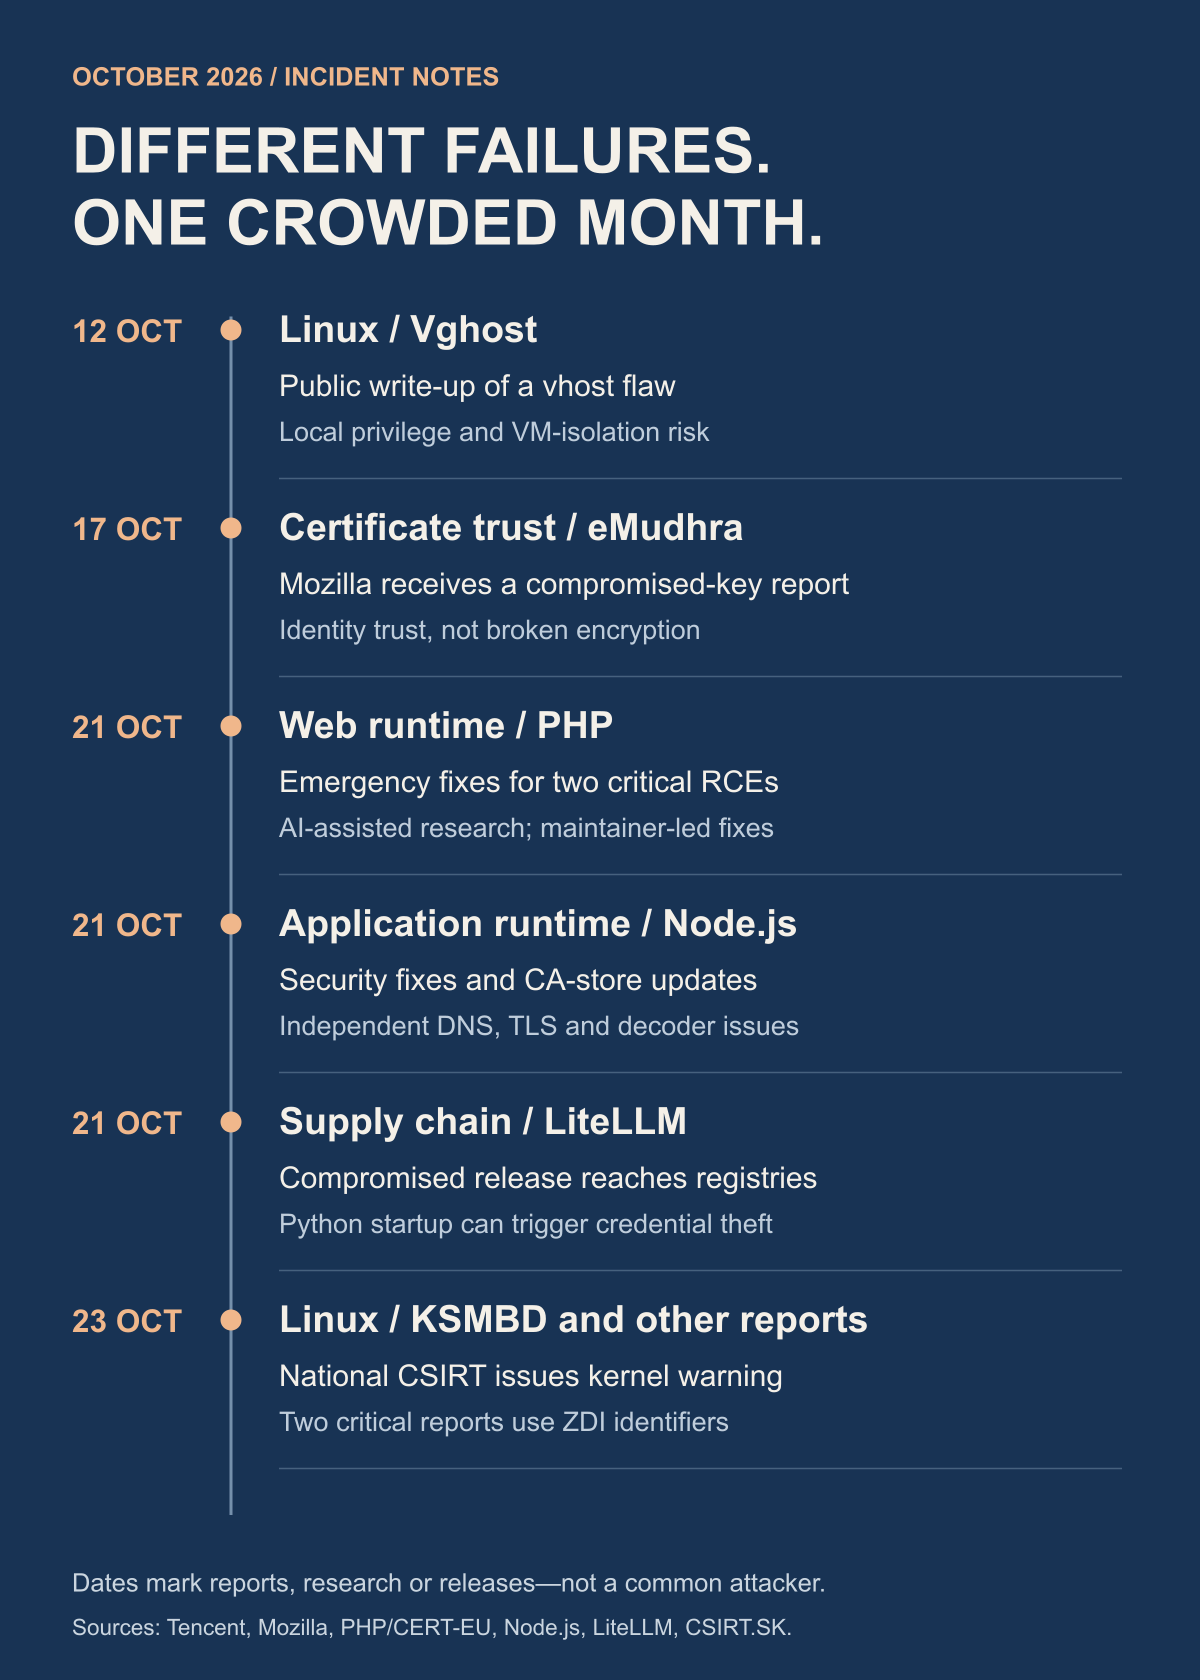
Informacje sprawdzone 24 października 2026 r. To analiza głównych incydentów i rodzin podatności Linuksa związanych z tą falą, a nie wyczerpujący katalog wszystkich CVE Linuksa. Podane niżej daty odróżniają pierwotne ujawnienie od ponownego zainteresowania. Szczegóły incydentów i status poprawek dostawców mogą się zmieniać.
Zatłoczony miesiąc, kilka różnych awarii
21 października PHP wydało awaryjne poprawki dwóch luk umożliwiających zdalne wykonanie kodu bez uwierzytelnienia: CVE-2026-109618 oraz CVE-2026-109619, oba ocenione na 9,2. Jeden dotyczy uszkodzenia pamięci podczas obsługi braku pamięci, drugi przestarzałego stanu żądania. To problemy środowiska uruchomieniowego, więc sama naprawa kodu aplikacji nie wystarczy. Zalecenie CERT-EU określa dotknięte gałęzie i pilność działania.
Związek z AI jest tu udokumentowany. OpenAI twierdzi Calif wykorzystał GPT-5.6 Sol w badaniach, a Wiz niezależnie zgłosił obie luki. Za poprawki i wydanie odpowiadali opiekunowie PHP. Uznanie należy się skoordynowanej pracy ludzi i modelu, a nie chatbotowi działającemu samodzielnie.
Pierwsze wydania z poprawkami to PHP 8.5.12, 8.4.27, 8.3.36 i 8.2.35. Dystrybutorzy mogą przenieść poprawki wstecz do pakietów o innych numerach wersji. Co istotne, 23 października CERT-EU zaktualizowało zalecenie, dodając CVE-2026-115560, trzeci problem RCE dotyczący nietypowej konfiguracji. PHP uznało to ryzyko za mało prawdopodobne i nie zaplanowało awaryjnego wydania; zalecenie opisuje tymczasowe ograniczenie ryzyka. Artykuł zamknięty na środowym ogłoszeniu poprawek byłby już niekompletny. Sprawdź oficjalne wydania PHP oraz aktualne zalecenia dostawców.
Historia Linuksa jest większa niż jeden przerażający nagłówek
Najnowsze doniesienia o krytycznych lukach jądra zasługują na uwagę. Słowacki CSIRT ostrzegał 23 października o publicznie ujawnionych raportach o podatnościach, w tym dwóch problemach serwera plików KSMBD ocenionych na 9,0: ZDI-CAN-33549 oraz ZDI-CAN-33774. Ich wymagania wstępne są różne: jeden dotyczy SMB Direct/RDMA, drugi obsługi protokołu i ścieżki zapisu powiązanej z dostępem do udziału. Ekspozycja zależy od faktycznie używanej usługi i konfiguracji. Własny wykaz ZDI potwierdza identyfikatory i oceny.
W chwili publikacji zalecenia te dwa raporty nie podały nie mają identyfikatory CVE. To rozróżnienie ma znaczenie. Krytyczny problem nie staje się nieszkodliwy, gdy czeka na CVE, a krytyczna ocena nie dowodzi, że zagrożone są wszystkie maszyny z Linuksem. Administratorzy powinni ograniczyć dostęp do dotkniętych usług i śledzić rzeczywisty status poprawek u swojego dystrybutora.
Istnieje też krytyczna przypisano CVE w niedawnej dyskusji o Linuksie: CVE-2025-39682, błąd ścieżki odbiorczej TLS w jądrze. NVD podaje ocenę 9,8 oraz odsyłacz CISA do znanego przypadku wykorzystania. Pierwotnie opublikowano ją we wrześniu 2025 r., a nie odkryto po raz pierwszy w październiku tego roku. Red Hat odmiennie ocenia swoje produkty, co pokazuje, dlaczego uniwersalna ocena i praktyczna ocena ekspozycji dostawcy mogą się różnić.
To tylko część istotnego obrazu Linuksa:
Copy Fail — CVE-2026-31431
Wspomagane przez AI odkrycie błędu w pamięci podręcznej stron jądra, ujawnione publicznie 29 kwietnia. Umożliwia lokalne podniesienie uprawnień w dotkniętych jądrach. Zdalny napastnik nadal potrzebuje początkowej drogi do lokalnego wykonania kodu. Ujawnienie badacza.
Dirty Frag / Fragnesia — CVE-2026-43284, CVE-2026-43500, CVE-2026-46300
Powiązane luki eskalacji uprawnień w pamięci podręcznej stron ujawnione w maju. Komponenty sieciowe i konfiguracja wpływają na osiągalność; dochodzenie Microsoftu odróżnia zaobserwowaną aktywność od niepotwierdzonego wykorzystania poszczególnych wariantów. Dochodzenie Microsoftu.
CrackArmor
Dziewięć podatności AppArmor reprezentowanych przez jedenaście identyfikatorów CVE na poziomie poprawek. Ubuntu dokumentuje wymagania dotyczące lokalnego użytkownika oraz różny wpływ w kolejnych wydaniach, w tym obejście zasad i eskalację uprawnień. Pełna macierz Ubuntu.
Czwórka problemów sieciowych — DirtyAH6, TUNderflow, PPPoEject, DiagSpill
CVE-2026-80844, CVE-2026-81000, CVE-2026-68121 oraz CVE-2026-74469. Wrześniowe doniesienia opisują ścieżki do lokalnego roota o różnych wymaganiach dotyczących przestrzeni nazw, uprawnień i modułów. Biuletyn Red Hat.
Vghost — CVE-2026-74580
Błąd vhost może umożliwić lokalne podniesienie uprawnień, a w określonych konfiguracjach także ucieczkę z VM. Zalecenie Tencent wyraźnie stwierdza, że sprawdzone środowisko CVM nie było narażone na ścieżkę ucieczki z VM. Zalecenie Tencent.
Inne ścieżki w jądrze — CVE-2026-53266, CVE-2025-39964
Pierwszy problem dotyczy SNAT w ebtables przy określonych regułach mostu, drugi — równoczesnych zapisów AF_ALG. Różnią się wymaganiami i skutkami. Ocena SNAT; Ocena AF_ALG.
Praktyczna lekcja polega na rozróżnianiu zdalne wejście od co dzieje się po wejściu. Luka umożliwiająca lokalne uzyskanie uprawnień roota może być katastrofalna na współdzielonym serwerze, runnerze kompilacji lub hoście agentów, nawet jeśli nie pozwala dowolnemu internaucie się zalogować. Początkowy przyczółek może zapewnić błąd aplikacji lub skradzione konto. Traktowanie każdego nagłówka o jądrze jako uniwersalnego zdalnego przejęcia zaciemnia obraz systemów, które naprawdę wymagają pilnej uwagi.
Kłódka może zawieść, choć szyfrowanie pozostaje nienaruszone
Incydent z certyfikatami to inny rodzaj awarii. Mozilla informuje, że 17 października otrzymała zgłoszenie o przejęciu kluczy prywatnych ośmiu certyfikatów pośrednich eMudhra. Napastnik zdolny przechwycić połączenie mógłby potencjalnie wykorzystać fałszywie wystawione certyfikaty do podszywania się pod witrynę. Tego samego wieczoru Mozilla zablokowała dotknięte certyfikaty przez OneCRL, a później zaktualizowała Firefoksa i komponenty magazynu zaufania. Jej odpowiedź odnotowuje również późniejszą poprawkę Androida.
Klucz podpisujący urzędu certyfikacji uprawnia do poświadczania tożsamości. Jego przejęcie podważa tę decyzję o zaufaniu. Nie oznacza, że ktoś matematycznie złamał szyfrowanie TLS. Relacja Mozilli nie dowodzi też, że za przejęciem stał LLM.
Do tego obrazu należą też problemy OpenSSL, ale nie należy ich mylić z incydentem urzędu certyfikacji. Wrześniowy zestaw zaleceń obejmuje obsługę rozszerzeń X.509, wyczerpanie zasobów podczas przetwarzania certyfikatów, QUIC i inne usterki biblioteki kryptograficznej. Indeks zaleceń OpenSSL rozróżnia dotknięte wersje i poziomy zagrożenia. Złośliwy certyfikat może ujawnić błąd oprogramowania, nawet jeśli nigdy nie powinien być zaufany.
Wydanie bezpieczeństwa Node.js z 21 października łączy te warstwy: aktualizuje dołączone materiały CA dla eMudhra i naprawia niezależne problemy z DNS, weryfikacją nazw hostów TLS i innymi elementami środowiska uruchomieniowego. Błąd dekodera Brotli, CVE-2026-111497, może umożliwić uszkodzenie pamięci i zdalne wykonanie kodu, gdy aplikacja przetwarza skompresowane dane dostarczone przez atakującego; projekt przypisuje zasługę badaczom OpenAI Codex Security. Komunikat bezpieczeństwa Node.js ocenia swoje najpoważniejsze problemy jako High. Opublikowane wydania z poprawkami to 26.12.1, 24.22.1 i 22.23.4. Oficjalne archiwum wydań.
Klucze API stają się zasobem strategicznym
Kompromitacja LiteLLM szczególnie konkretnie pokazuje problem danych uwierzytelniających. Złośliwy pakiet 1.107.0 trafił do publicznych rejestrów 21 października. Microsoft wykrył haki startowe Pythona, które mogły uruchomić moduł zbierający dane uwierzytelniające, nawet jeśli aplikacja jawnie nie importowała LiteLLM. Klucze dostawców modeli stanowiły część znacznie szerszego zbioru celów, obejmującego dane deweloperów i chmury. Usunięcie jednego pakietu nie jest więc równoznaczne z przywróceniem zaufania do maszyny. Dochodzenie Microsoftu wyjaśnia skutki narażenia i odzyskiwania sprawności.
Późniejsze własne dochodzenie LiteLLM wskazuje, że źródłem kompromitacji upstream był ujawniony klucz główny, którego nie unieważniono, a następnie dostęp do zaawansowanych danych uwierzytelniających deweloperów i procesu wydawniczego. Raport wspomina też o próbach pozyskania tokenów upstreamowych API do inferencji. Kanoniczna relacja o incydencie koryguje niektóre wczesne założenia. To przypomnienie, by śledzić dochodzenie, a nie zachowywać pierwsze wyjaśnienie, które stało się viralem.
Dane dostępowe do AI mogą dziś kupić więcej niż fałszywy rachunek za chmurę. Mogą zapewnić zdolność rozumowania, pomoc w programowaniu i miejsce do ukrycia działań innego operatora. Jeśli dostęp zostanie odsprzedany, koszty i ryzyko egzekwowania zasad mogą spaść na prawowitego właściciela konta, podczas gdy ktoś inny wykorzystuje te możliwości. Ustalenie, kto kupił konkretny skradziony klucz i do czego go użył, nadal wymaga dowodów.
Co mówią dowody o chińskich laboratoriach
Istnieją udokumentowane podstawy do obaw o nieautoryzowaną destylację. We wrześniowym raporcie Anthropic opisuje kampanie przypisywane chińskim laboratoriom i wyjaśnia, jak usługi proxy mogą zapewniać dostęp przy użyciu fałszywych kont, skradzionych danych płatniczych i skradzionych danych dostępowych API. Ten sam raport opisuje złośliwe operacje wspomagane przez AI prowadzone przez różne rodzaje aktorów, a nie jedną grupę narodową. Są to ustalenia przypisane przez Anthropic, a nie niezależny werdykt w sprawie każdego domniemanego uczestnika. Przeczytaj raport o zagrożeniach.
Ujawnienie OpenAI z 30 września przypisuje główny klaster kampanii wydobywania zdolności rozumowania osobom powiązanym z Moonshot AI. Co istotne, według raportu kampania nie złamała szyfrowania, nie skompromitowała bazy danych ani nie uzyskała bezpośredniego dostępu do zapisanych rozmów użytkowników. Jej mechanizmem była manipulacja interakcjami z modelem. Relacja OpenAI nie należy przedstawiać jako innego rodzaju naruszenia.
NSA, FBI i CISA wydały we wrześniu również wspólne ostrzeżenie o destylacji na skalę przemysłową przez chińskie firmy AI. Ogłoszenie rządowego zalecenia potwierdza, że jest to poważny, publicznie udokumentowany problem. Destylacja pozostaje legalną techniką trenowania; pytania dotyczą autoryzacji, dostępu i sposobu pozyskania danych.
Moja ocena: skradzione dane dostępowe do inferencji i nieautoryzowana destylacja stanowią wiarygodny element ekonomii zagrożeń. Powyższe źródła nie dowodzą, że chińskie laboratoria zorganizowały błędy PHP, kompromitację klucza eMudhra, ujawnienia KSMBD ani atak na LiteLLM. Połączenie tych wydarzeń w jedną kampanię wymagałoby dowodów łączących operatorów, infrastrukturę lub wykorzystanie skradzionych danych uwierzytelniających. Wspólne bodźce są powodem do zbadania sprawy, a nie substytutem przypisania odpowiedzialności.
Gdy druga strona może uruchomić rój agentów
Istotna zmiana ma charakter ekonomiczny. Model może analizować kod, proponować testy i pomagać badać wynik. Umieszczony w agencie korzystającym z narzędzi może powtarzać ten cykl. Wiele agentów działających równolegle pozwala operatorowi jednocześnie sprawdzać kilka hipotez. Nie oznacza to, że każda próba jest trafna ani że każdy cel jest podatny. Oznacza, że ciągłe prowadzenie dochodzeń staje się tańsze.
Konkretny przykład obrony znajdziemy w Raport OpenAI o opanowaniu sytuacji z 23 października. Firma opisuje floty agentów testujących specjalnie przygotowane kopie jej infrastruktury, z dostępem do źródeł i konfiguracji, monitorowaniem oraz ograniczonym zakresem celów. Raportuje ustalenia dotyczące ucieczki z VM i izolacji, a także prace nad problemami jądra, w tym CVE-2026-74753, CVE-2026-80521 oraz CVE-2026-80841. Te kontrolowane eksperymenty nie dowodzą, że publiczny bot bez nadzoru może włamać się na dowolny serwer. Pokazują, dlaczego obrońcy poważnie traktują długotrwałe testowanie wspomagane maszynowo.
Dla małego operatora zmienia to wartość bycia nieinteresującym celem. Nieznane systemy zapewniają słabszą ochronę, gdy sprawdzenie kolejnego hosta niewiele kosztuje. Napastnik może próbować dalej, gdy twój zespół wykonuje swoją właściwą pracę. Obrona powinna skracać drogę od wiarygodnego sygnału do potwierdzonej poprawki, zamiast jedynie generować więcej alertów.
Przydatni agenci obronni potrzebują granic
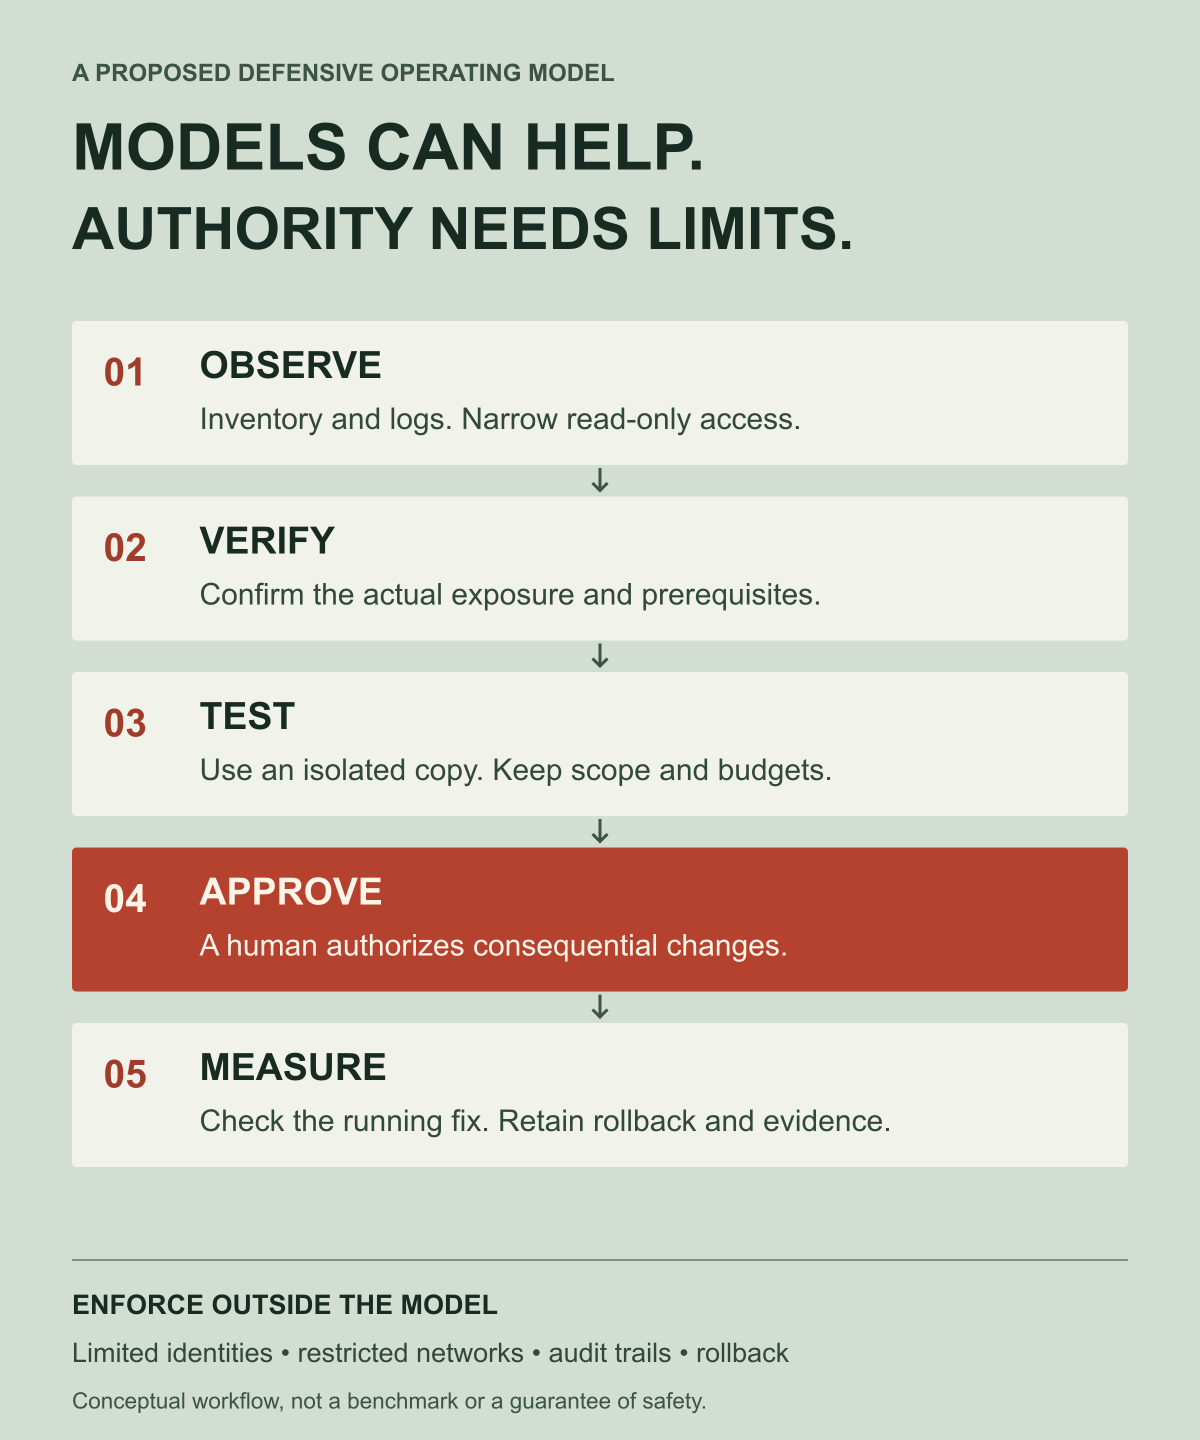
Moim zdaniem pierwszym użytecznym agentem bezpieczeństwa jest skrupulatny analityk. Mapuje wdrożone oprogramowanie i osiągalne usługi, łączy zalecenia z rzeczywistym środowiskiem i tworzy dowody, na które opiekun może zareagować. Drugą rolą jest testowanie proponowanej poprawki w jednorazowym środowisku. Żadna z nich nie wymaga nieograniczonych danych dostępowych do produkcji.
Kolejność wdrażania powinna być przemyślana:
- Obserwuj: zebrać inwentaryzację, wersje i dzienniki przy użyciu wąskiego dostępu tylko do odczytu.
- Zweryfikuj: ustalić, czy podatna ścieżka kodu jest obecna i osiągalna. Sam numer wersji może nie uwzględniać poprawki wstecznie przeniesionej przez dystrybutora.
- Przetestuj: odtworzyć i zweryfikować w kontrolowanej kopii, z budżetami i zakresem egzekwowanymi poza modelem.
- Zmiana: wymagać zatwierdzenia istotnych działań produkcyjnych, a następnie wdrażać etapami i z przetestowanym wycofaniem.
- Zmierz: sprawdzić działający system, zachowane dowody, stan usług oraz to, czy rzeczywiste narażenie spadło.
Dzienniki, zgłoszenia i pliki repozytorium mogą zawierać tekst kontrolowany przez napastnika. Obrońca, który potraktuje go jako wiążący, może stworzyć kolejną powierzchnię ataku. Ograniczone tożsamości, izolowane narzędzia, limitowany dostęp sieciowy i niezależnie egzekwowane reguły działań mają znaczenie nawet wtedy, gdy model brzmi pewnie. Szybsze rozumowanie nie czyni szerokich uprawnień bezpieczniejszymi.
Laboratorium sprzedaje możliwości. Potem sprzedaje tarczę.
W tym miejscu model biznesowy staje się niewygodny. Te same firmy, które rozwijają możliwości obniżające koszt ataku, przedstawiają je jako niezbędne narzędzia obronne. Klienci mogą płacić stały rachunek za zarządzanie ryzykiem przyspieszanym przez samą kategorię produktów.
U podstaw tej obawy leży rzeczywista struktura komercyjna. W ogłoszeniu Glasswing Anthropic zadeklarowało do 100 mln dolarów w kredytach na modele i 4 mln dolarów darowizn dla organizacji zajmujących się bezpieczeństwem otwartego oprogramowania; opisano też płatne korzystanie po zakończeniu wsparcia w ramach wersji zapoznawczej. W październiku dotychczasowi członkowie Glasswing przechodzili do rozszerzonego programu Cyber Verification Program. Strona programu jest zarówno poważną inicjatywą obronną, jak i częścią rynku zaawansowanych możliwości bezpieczeństwa.
Określenie „podatek od bezpieczeństwa AI” nie wymaga twierdzenia, że laboratoria wymyśliły błędy sprzed dziesięcioleci ani celowo organizowały ataki. Wskazuje ono bodziec: wraz z upowszechnianiem się potężnych modeli może rosnąć popyt na obronę wspomaganą modelami, a dostawcy tych możliwości mogą przejąć związane z tym wydatki. Opinia publiczna powinna móc analizować ograniczenia dostępu, ceny, deklaracje bezpieczeństwa i dowody, że obiecana ochrona działa.
Istnieje uczciwy kontrargument. Badania obronne mogą przekształcić tymczasową przewagę w odkrywaniu w trwałe publiczne poprawki, również te chroniące osoby, które nigdy nie kupią subskrypcji modelu. Ta korzyść jest realna. Przemawia za oceną branży na podstawie wdrożonych poprawek i bezpieczniejszych ustawień domyślnych, zamiast traktowania strachu lub optymizmu jako wystarczających dowodów.
Wąskim gardłem jest wszystko, co następuje po odkryciu
Modele mogą generować wyniki szybciej, niż opiekunowie są w stanie je zweryfikować. Panel ujawniania podatności Anthropic w datowanym na 2 października zestawieniu wskazywał 6157 ujawnionych ustaleń w 591 projektach oraz 516 znanych poprawek upstream. Panel ostrzega, że liczby obejmują różne etapy walidacji, a liczba poprawek nie pokazuje, jak szeroko je zainstalowano. Metodologia jest równie ważna jak liczba w nagłówku.
Wniosek nie polega na odejmowaniu tych liczb i ogłaszaniu, że istnieją tysiące podatnych, niezałatanych serwerów. Odkrycie, potwierdzenie, naprawa upstream i wdrożenie to oddzielne zadania. Finansowanie tylko pierwszego przerzuca pracę na osoby odpowiedzialne za pozostałe.
Opowiadam się za rynkiem bezpieczeństwa, który wynagradza rezultaty: odtwarzalne raporty, możliwości opiekunów, publiczne poprawki, użyteczne ścieżki aktualizacji i niezależnie testowane ograniczanie skutków. Klienci powinni móc przekazać swoje dowody innemu dostawcy. Mali opiekunowie nie powinni potrzebować korporacyjnego kontraktu AI, by zabezpieczać powszechnie używaną bibliotekę.
W następnej erze bezpieczeństwa modele będą prawdopodobnie obserwować modele, a agenci testować zabezpieczenia innych agentów. Trwała obrona nie może jednak całkowicie zależeć od tego, kogo stać na największy rój. Potrzebuje też mniej eksponowanej infrastruktury, danych dostępowych o mniejszych uprawnieniach, bezpieczniej zawodzącego oprogramowania i ludzi upoważnionych do działania na podstawie wiarygodnych dowodów.
Pytanie nie brzmi już tylko, czy AI potrafi znaleźć lukę. Chodzi o to, kto otrzyma poprawkę, kto kontroluje obronę i kto dostanie rachunek.
Nota redakcyjna: artykuł oddziela zweryfikowane relacje o incydentach, atrybucję dostawców i analizę autora. Ilustracje koncepcyjne wygenerowano w ChatGPT; infografiki opracowano na podstawie podlinkowanych zapisów. Na potrzeby artykułu nie uruchomiono żadnego exploita przeciw działającemu systemowi. Przed działaniem sprawdź aktualne zalecenia dla swojego produktu i konfiguracji.