Laboratorierna som gör programvara lättare att bryta sig in i säljer också verktygen för att försvara den. Månadens säkerhetsincidenter visar varför den affärsmodellen förtjänar granskning och varför svaret inte kan vara ännu en svart låda med en större API-räkning.
Ett obekvämt försäljningsargument tar form i AI-branschen: modellerna blir tillräckligt kraftfulla för att hitta sprickorna i din infrastruktur, så du bör nog använda modellerna för att täta dem.
Jag kallar den resulterande räkningen för AI-säkerhetsskatten. Den omfattar mer än en prenumeration: ingenjörstid, inferenskostnader, akuta patchar och den operativa komplexitet som krävs för att hålla jämna steg med maskiner som kan undersöka programvara kontinuerligt. Små team betalar med kvällar och helger. Stora organisationer betalar genom ytterligare ett lager säkerhetsinfrastruktur.
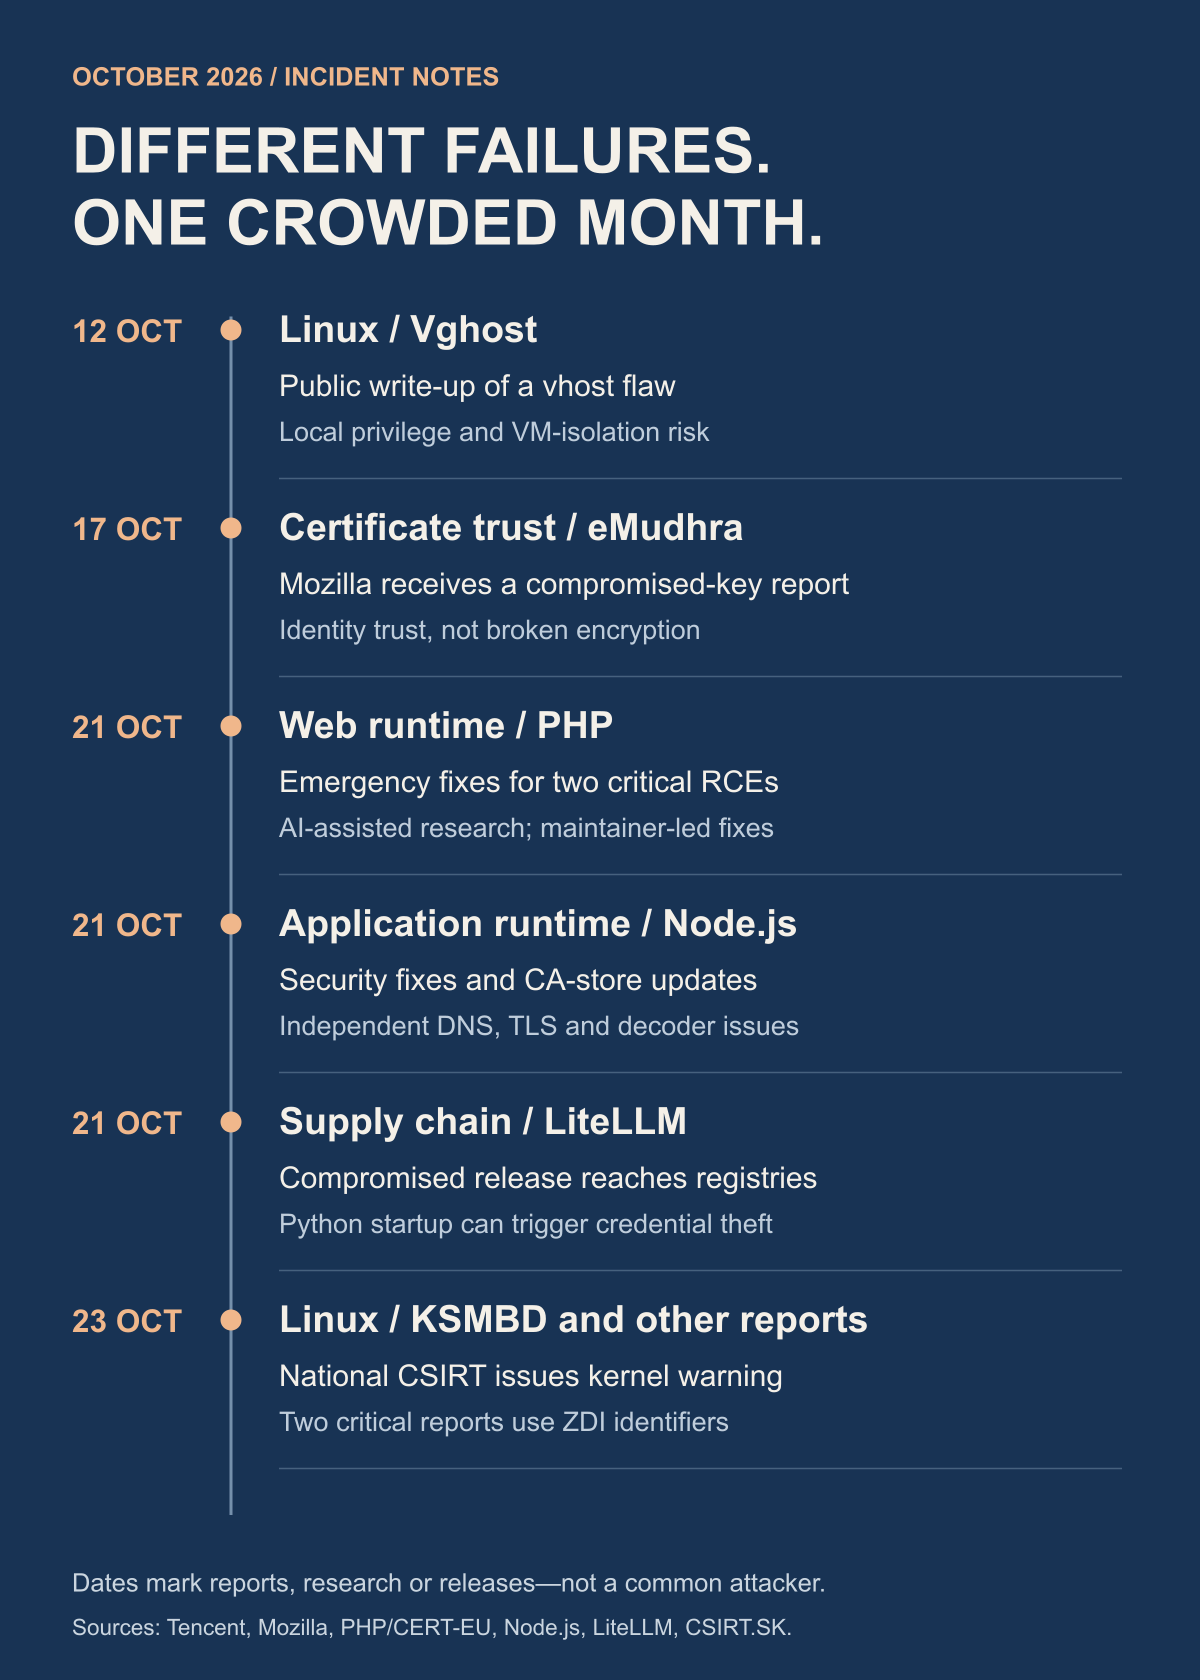
Oktobers incidenter gör utsikten konkret. De gör det också lätt att berätta en alltför prydlig historia: en global AI-angreppsvåg, en utländsk skyldig, en leverantör med botemedlet. Beläggen stöder ett mer intressant resonemang. Gamla fel, komprometterat förtroende, stulna uppgifter och allt skickligare agenter samverkar. De har inte alla samma orsak.
Rapporteringen kontrollerades den 24 oktober 2026. Detta är en analys av de större incidenterna och Linux-sårbarhetsfamiljerna som är relevanta för denna våg, inte en uttömmande katalog över alla Linux-CVE:er. Datumen nedan skiljer ursprunglig publicering från förnyad uppmärksamhet. Incidentdetaljer och leverantörernas patchstatus kan förändras.
En händelserik månad, flera olika fel
Den 21 oktober släppte PHP akuta rättningar för två brister som tillåter fjärrkörning av kod utan autentisering: CVE-2026-109618 och CVE-2026-109619, båda med betyget 9.2. Det ena gäller minneskorruption vid hantering av minnesbrist; det andra gäller inaktuellt begärandetillstånd. Det är problem i körmiljön, så det räcker inte att bara rätta applikationskoden. CERT-EU:s säkerhetsmeddelande anger de berörda grenarna och hur brådskande det är.
Här finns en dokumenterad koppling till AI. OpenAI säger Calif använde GPT-5.6 Sol i forskningen, medan Wiz rapporterade båda bristerna oberoende. PHP:s underhållare ledde rättningarna och publiceringen. Erkännandet tillhör detta samordnade arbete mellan människor och modell, inte en chattbot som agerar ensam.
De första rättade versionerna är PHP 8.5.12, 8.4.27, 8.3.36 och 8.2.35. Distributionsleverantörer kan bakåtportera rättningar under andra paketversioner. Viktigt är att CERT-EU uppdaterade sitt meddelande den 23 oktober för att lägga till CVE-2026-115560, ett tredje RCE-problem med en ovanlig konfiguration. PHP bedömde risken som osannolik och planerade ingen akutversion; meddelandet ger en tillfällig motåtgärd. En berättelse som stannade vid onsdagens patchbesked skulle redan vara ofullständig. Kontrollera de officiella PHP-versionerna och leverantörens aktuella vägledning.
Linux-historien är större än en skrämmande rubrik
De senaste kritiska kärnrapporterna förtjänar uppmärksamhet. Slovakiens CSIRT varnade den 23 oktober om offentligt exponerade sårbarhetsrapporter, däribland två KSMBD-filserverproblem med betyget 9.0: ZDI-CAN-33549 och ZDI-CAN-33774. Förutsättningarna skiljer sig: det ena gäller SMB Direct/RDMA; det andra gäller protokollfördelning och har en skrivväg kopplad till åtkomst till en resursdelning. Exponeringen beror på tjänsten och konfigurationen som faktiskt används. ZDI:s egen inventering bekräftar identifierarna och poängen.
När säkerhetsmeddelandet publicerades hade de två rapporterna inte CVE-identifierare. Den skillnaden spelar roll. Ett kritiskt problem blir inte ofarligt medan det väntar på en CVE, och en kritisk poäng visar inte att alla Linux-maskiner är exponerade. Administratörer bör begränsa åtkomst till berörda tjänster och följa distributörens faktiska rättningsstatus.
Det finns också en kritisk tilldelad CVE i den senaste Linux-diskussionen: CVE-2025-39682, en brist i kärnans mottagningsväg för TLS. NVD anger betyget 9.8 och en CISA-referens till känd exploatering. Den publicerades ursprungligen i september 2025 och upptäcktes inte först nu i oktober. Red Hat bedömer sina produkter annorlunda, vilket visar varför en generell poäng och en leverantörs praktiska exponeringsbedömning kan skilja sig åt.
Det är bara en del av den relevanta Linux-bilden:
Copy Fail — CVE-2026-31431
AI-assisterad upptäckt av en brist i kärnans sidcache, offentliggjord den 29 april. Den möjliggör lokal privilegieeskalering på berörda kärnor. En fjärrangripare behöver fortfarande en första väg till lokal kodkörning. Forskarens offentliggörande.
Dirty Frag / Fragnesia — CVE-2026-43284, CVE-2026-43500, CVE-2026-46300
Besläktade problem med privilegieeskalering via sidcachen, offentliggjorda i maj. Nätverkskomponenter och konfiguration påverkar nåbarheten; Microsofts utredning skiljer observerad aktivitet från obekräftad exploatering av enskilda varianter. Microsofts utredning.
CrackArmor
Nio AppArmor-sårbarheter, representerade av elva CVE-identifierare på patchnivå. Ubuntu dokumenterar krav på lokal användare och olika påverkan mellan versioner, däribland kringgående av policy och privilegieeskalering. Ubuntus fullständiga matris.
Nätverkskvartetten — DirtyAH6, TUNderflow, PPPoEject, DiagSpill
CVE-2026-80844, CVE-2026-81000, CVE-2026-68121 och CVE-2026-74469. Septemberrapporteringen beskriver vägar till lokal root-åtkomst med olika krav på namnrymder, capabilities och moduler. Red Hat-bulletin.
Vghost — CVE-2026-74580
En vhost-brist som kan tillåta lokal privilegieeskalering, med risk för VM-utbrytning i vissa konfigurationer. Tencents meddelande säger uttryckligen att den kontrollerade CVM-miljön inte var exponerad för VM-utbrytningsvägen. Tencents säkerhetsmeddelande.
Andra kärnvägar — CVE-2026-53266, CVE-2025-39964
Det första gäller ebtables SNAT under särskilda bryggregler; det andra gäller samtidiga AF_ALG-skrivningar. Kraven och konsekvenserna skiljer sig. SNAT-bedömning; AF_ALG-bedömning.
Den praktiska lärdomen är att skilja mellan fjärrinträde från vad som händer efter inträdet. En sårbarhet som ger lokala root-rättigheter kan vara förödande på en delad server, byggkörningsmaskin eller agentvärd, även när den inte låter en godtycklig internetbesökare logga in. Ett applikationsfel eller stulet konto kan ge det första fotfästet. Att behandla varje kärnrubrik som en universell fjärrövertagning skymmer vilka system som faktiskt behöver uppmärksamhet först.
Hänglåset kan fallera utan att krypteringen bryts
Certifikatincidenten är en annan sorts fel. Mozilla säger att företaget den 17 oktober fick en rapport om att privata nycklar till åtta mellanliggande eMudhra-certifikat hade komprometterats. En angripare som kan avlyssna en anslutning skulle potentiellt kunna använda bedrägligt utfärdade certifikat för att utge sig för att vara en webbplats. Mozilla blockerade de berörda certifikaten via OneCRL samma kväll och uppdaterade senare Firefox och komponenterna i sitt förtroendelager. Svaret dokumenterar också en efterföljande Android-rättning.
En certifikatutfärdares signeringsnyckel ger befogenhet att gå i god för identiteter. Att kompromettera den angriper det förtroendebeslutet. Det betyder inte att någon matematiskt besegrat TLS-krypteringen. Mozillas redogörelse visar inte heller att en LLM orsakade komprometteringen.
OpenSSL-problem hör också till bilden, men bör inte blandas ihop med CA-incidenten. Septembers säkerhetsmeddelanden omfattar hantering av X.509-tillägg, resursuttömning vid certifikatbehandling, QUIC och andra fel i kryptografiska bibliotek. OpenSSL:s index över säkerhetsmeddelanden skiljer på berörda versioner och allvarlighetsgrad. Ett skadligt certifikat kan blottlägga ett programfel även när certifikatet aldrig borde betros.
Node.js säkerhetsversion den 21 oktober förenar dessa lager: den uppdaterar det medföljande CA-materialet för eMudhra och rättar oberoende problem med DNS, TLS-värdnamnsverifiering och andra delar av körmiljön. En brist i Brotli-avkodaren, CVE-2026-111497, skulle kunna tillåta minneskorruption och fjärrkörning av kod när en applikation behandlar komprimerade data från en angripare; projektet tillskriver upptäckten forskare vid OpenAI Codex Security. Nodes säkerhetsmeddelande klassar sina allvarligaste problem som High. De publicerade rättade versionerna är 26.12.1, 24.22.1 och 22.23.4. Officiellt versionsarkiv.
API-nycklar blir en strategisk resurs
LiteLLM-komprometteringen gör problemet med åtkomstuppgifter särskilt konkret. Det skadliga paketet 1.107.0 nådde offentliga paketregister den 21 oktober. Microsoft hittade startkrokar i Python som kunde aktivera en uppgiftssamlare utan att en applikation uttryckligen importerade LiteLLM. Modellleverantörsnycklar var del av en mycket bredare målgrupp med utvecklar- och molnuppgifter. Att ta bort ett paket är därför inte detsamma som att återställa förtroendet för maskinen. Microsofts utredning förklarar följderna för exponering och återställning.
LiteLLM:s egen senare utredning spårar komprometteringen uppströms till en exponerad huvudnyckel som inte återkallats, följt av åtkomst till kraftfulla utvecklaruppgifter och publiceringsprocessen. Den rapporterar också ett fokus på att få tag på API-token för inferens uppströms. Den auktoritativa incidentredogörelsen korrigerar några tidiga antaganden. Det påminner om att följa utredningen, inte bevara den första förklaringen som blev viral.
En AI-åtkomstuppgift kan nu köpa mer än en bedräglig molnfaktura. Den kan köpa resonemang, programmeringshjälp och en plats att gömma en annan operatörs aktivitet. Om åtkomsten säljs vidare kan den rättmätiga kontoinnehavaren bära kostnader och risk för ingripanden medan någon annan använder förmågan. Exakt vem som köpte en viss stulen nyckel och vad den användes till kräver fortfarande belägg.
Vad beläggen säger om kinesiska laboratorier
Det finns dokumenterad grund för oro över otillåten destillering. I sin septemberrapport beskriver Anthropic kampanjer som företaget tillskriver Kina-baserade laboratorier och förklarar hur proxytjänster kan använda bedrägliga konton, stulna betalningsuppgifter och stulna API-uppgifter för att tillhandahålla åtkomst. Samma rapport beskriver skadliga AI-assisterade operationer av flera typer av aktörer, inte en enda nationell grupp. Det är Anthropics attribuerade fynd, inte en oberoende dom över varje påstådd deltagare. Läs hotrapporten.
OpenAI:s rapport den 30 september tillskriver en kärngrupp i en kampanj för att extrahera resonemang personer med koppling till Moonshot AI. Avgörande är att den säger att kampanjen varken bröt kryptering, komprometterade en databas eller direkt fick tillgång till lagrade användarsamtal. Mekanismen var manipulation av modellinteraktioner. OpenAI:s redogörelse bör inte återberättas som en annan sorts intrång.
NSA, FBI och CISA utfärdade också en gemensam varning i september om destillering i industriell skala av Kina-baserade AI-företag. Tillkännagivandet av myndigheternas säkerhetsmeddelande visar att detta är en allvarlig, offentligt dokumenterad oro. Destillering är i sig fortfarande en legitim träningsteknik; frågorna gäller tillstånd, åtkomst och hur data anskaffades.
Min bedömning: stulna inferensuppgifter och otillåten destillering är en trovärdig del av hotekonomin. Källorna ovan visar inte att kinesiska laboratorier organiserade PHP-felen, komprometteringen av eMudhra-nyckeln, KSMBD-avslöjandena eller LiteLLM-angreppet. Att knyta ihop dessa händelser till en kampanj skulle kräva belägg som kopplar samman operatörer, infrastruktur eller användning av stulna uppgifter. Gemensamma incitament är ett skäl att undersöka, inte ett substitut för attribution.
När motståndaren kan köra en svärm
Den viktiga förändringen är ekonomisk. En modell kan granska kod, föreslå tester och hjälpa till att undersöka resultatet. I en verktygsanvändande agent kan den upprepa loopen. Med många parallella agenter kan en operatör undersöka flera hypoteser samtidigt. Det gör inte varje försök rätt eller varje mål sårbart. Det gör ihållande undersökning billigare.
Det finns ett konkret defensivt exempel i OpenAI:s inneslutningsrapport den 23 oktober. Företaget beskriver flottor av agenter som testar specialbyggda kopior av infrastrukturen, med åtkomst till källkod och konfiguration, övervakning och avgränsade mål. Det rapporterar fynd kring VM-utbrytning och isolering samt arbete med kärnproblem, däribland CVE-2026-74753, CVE-2026-80521 och CVE-2026-80841. Dessa kontrollerade experiment visar inte att en oövervakad offentlig bot kan bryta sig in i vilken server som helst. De visar varför försvarare tar ihållande maskinassisterad testning på allvar.
För en liten operatör förändrar detta vad det ger att vara ointressant. Att vara okänd skyddar sämre när det kostar lite att kontrollera ännu en värd. Angriparen kan fortsätta försöka medan teamet gör sitt egentliga arbete. Försvaret behöver korta vägen från en trovärdig signal till en verifierad rättning, snarare än att bara skapa fler larm.
Användbara defensiva agenter behöver gränser
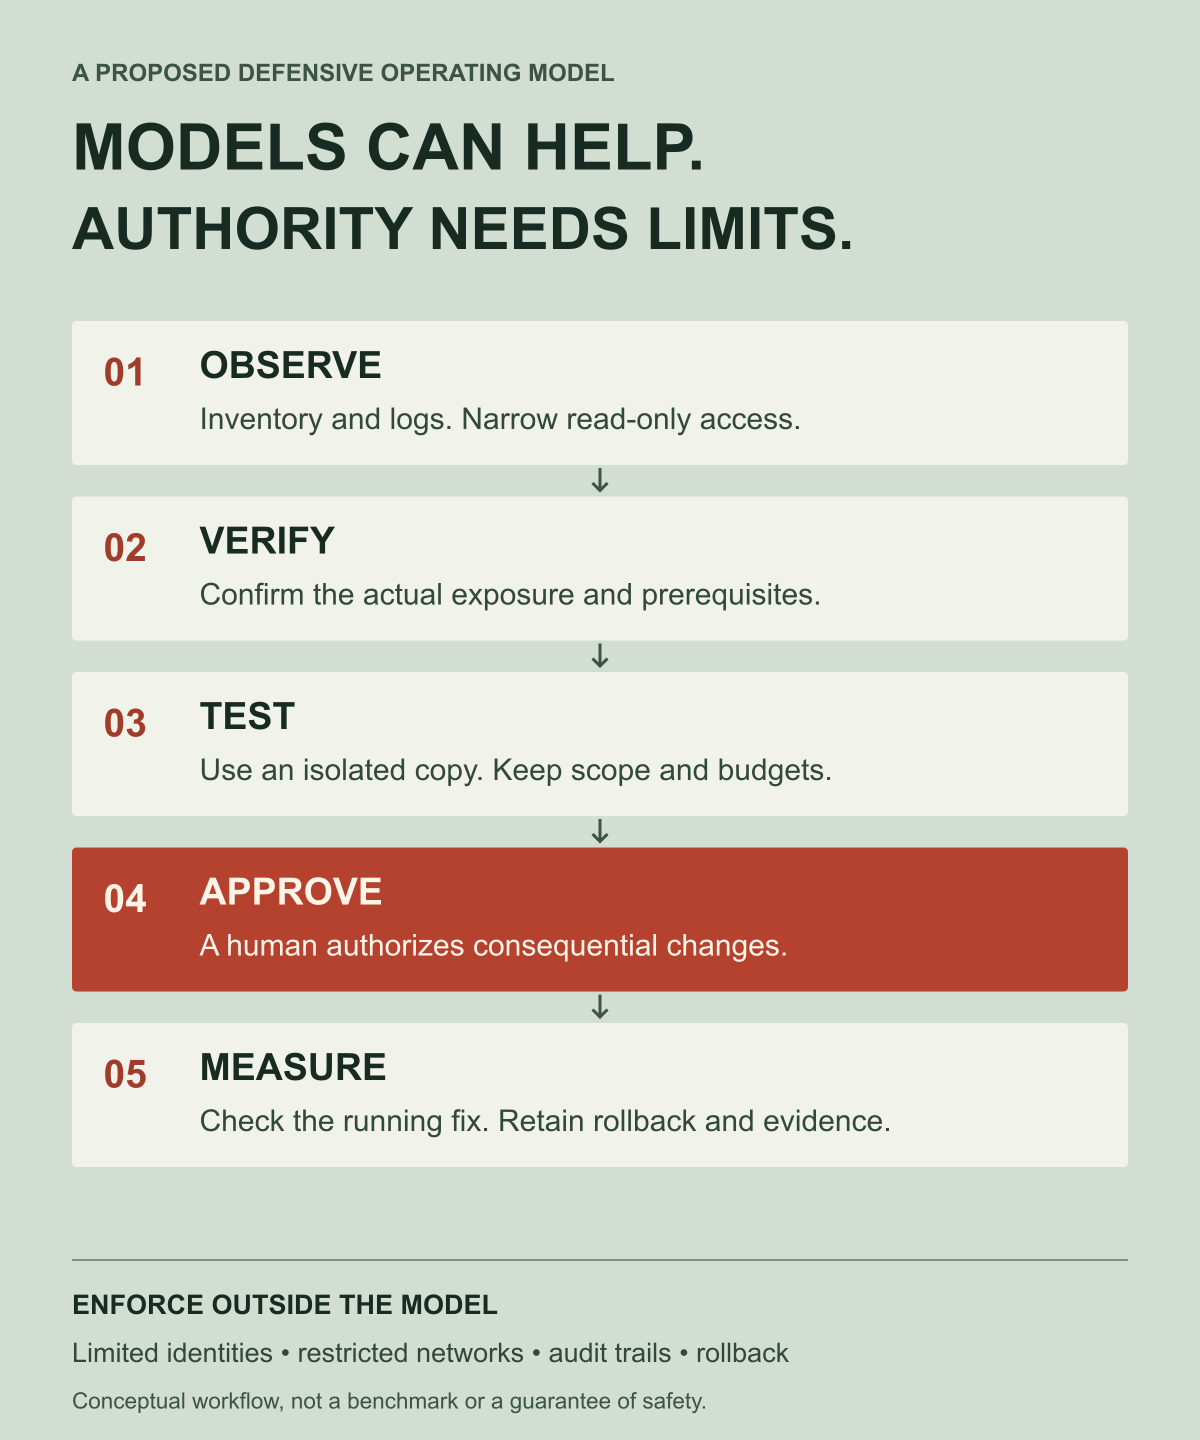
Enligt mig är den första användbara säkerhetsagenten en noggrann utredare. Den kartlägger driftsatt programvara och nåbara tjänster, kopplar säkerhetsmeddelanden till den faktiska miljön och producerar belägg som en underhållare kan agera på. En andra roll är att testa en föreslagen rättning i en tillfällig miljö. Ingen av dem behöver obegränsade produktionsuppgifter.
Införandeordningen bör vara medveten:
- Observera: samla inventering, versioner och loggar med snävt begränsad läsåtkomst.
- Verifiera: fastställ om den sårbara kodvägen finns och går att nå. Enbart en versionssträng kan missa en bakåtporterad rättning från distributören.
- Testa: återskapa och verifiera i en kontrollerad kopia, med budgetar och omfattning som upprätthålls utanför modellen.
- Ändra: kräv godkännande för produktionsåtgärder med stora konsekvenser och använd sedan stegvis utrullning och testad återställning.
- Mät: kontrollera det körande systemet, bevarade belägg, tjänsternas hälsa och om exponeringen faktiskt minskade.
Loggar, ärenden och filer i kodförråd kan innehålla angriparstyrd text. En försvarare som behandlar den texten som auktoritet kan bli ännu en angreppsyta. Begränsade identiteter, isolerade verktyg, begränsad nätverksåtkomst och oberoende upprätthållna handlingsregler spelar roll även när modellen låter självsäker. Snabbare resonemang gör inte breda behörigheter säkrare.
Laboratoriet säljer förmågan. Sedan säljer det skölden.
Här blir affärsmodellen obekväm. Samma företag som utvecklar förmågor som kan sänka kostnaden för angrepp positionerar dem som nödvändiga försvarsverktyg. Kunder kan få betala en löpande räkning för att hantera en risk som produktkategorin själv accelererar.
Det finns en konkret kommersiell struktur bakom oron. Anthropics Glasswing-besked utlovade upp till 100 miljoner dollar i modellkrediter och 4 miljoner dollar i donationer till säkerhetsorganisationer för öppen källkod; det beskrev också betald användning efter förhandsstödets slut. I oktober flyttade befintliga Glasswing-medlemmar till det utökade Cyber Verification Program. Programsidan är både en seriös försvarsinsats och en del av en marknad för avancerad säkerhetsförmåga.
Att kalla detta en AI-säkerhetsskatt kräver inte påståendet att laboratorierna uppfann decennier gamla fel eller medvetet organiserade angrepp. Det pekar ut ett incitament: när kraftfulla modeller sprids kan efterfrågan på modellassisterat försvar växa, och leverantörerna av förmågan kan ta del av dessa utgifter. Allmänheten bör kunna granska åtkomstbegränsningar, prissättning, säkerhetspåståenden och belägg för att det utlovade skyddet fungerar.
Det finns ett rimligt motargument. Defensiv forskning kan omvandla ett tillfälligt upptäcktsförsprång till permanenta offentliga patchar, även rättningar som skyddar människor som aldrig köper en modellprenumeration. Den nyttan är verklig. Den talar för att bedöma branschen efter driftsatta rättningar och säkrare standardinställningar, snarare än att se vare sig rädsla eller optimism som tillräckliga belägg.
Flaskhalsen är allt efter upptäckten
Modeller kan producera fynd snabbare än underhållare nödvändigtvis kan granska dem. Anthropics rapporteringspanel angav i sin uttryckligen daterade ögonblicksbild den 2 oktober 6 157 rapporterade fynd i 591 projekt och 516 kända patchar uppströms. Panelen varnar för att siffrorna avser olika valideringssteg och att antalet patchar inte visar hur brett rättningarna har installerats. Metodiken betyder lika mycket som siffran i rubriken.
Lärdomen är inte att subtrahera siffrorna och utropa tusentals exploaterbara, opatchade servrar. Upptäckt, bekräftelse, rättning uppströms och driftsättning är separata uppgifter. Att bara finansiera den första skjuter arbete på dem som ansvarar för resten.
Jag föredrar en säkerhetsmarknad som betalar för resultat: reproducerbara rapporter, underhållarkapacitet, offentliga rättningar, användbara uppdateringsvägar och oberoende testad inneslutning. Kunder bör kunna ta med sina belägg till en annan leverantör. Små underhållare bör inte behöva ett AI-företagsavtal för att hålla ett brett använt bibliotek säkert.
Nästa säkerhetsera kommer sannolikt att omfatta modeller som bevakar modeller och agenter som testar försvar mot andra agenter. Men ett hållbart försvar kan inte helt bero på vem som har råd med den största svärmen. Det kräver också mindre exponerad infrastruktur, mindre mäktiga åtkomstuppgifter, programvara som fallerar säkrare och människor med befogenhet att agera på goda belägg.
Frågan är inte längre bara om AI kan hitta hålet. Den gäller vem som får rättningen, vem som kontrollerar försvaret och vem som får fakturan.
Redaktionell not: artikeln skiljer mellan verifierad incidentrapportering, leverantörers attribution och författarens analys. De konceptuella illustrationerna skapades med ChatGPT; infografiken utformades utifrån de länkade underlagen. Inget exploit kördes mot ett aktivt system för denna artikel. Läs det aktuella säkerhetsmeddelandet för exakt produkt och konfiguration innan du agerar.