המעבדות שהופכות תוכנה לקלה יותר לשבירה מוכרות גם כלים להגנה עליה. תקריות האבטחה של החודש מראות מדוע המודל העסקי הזה ראוי לבחינה—ומדוע הפתרון אינו יכול להיות עוד קופסה שחורה עם חשבון API גדול יותר.
בתעשיית ה-AI מתגבשת הצעת מכירה מביכה: המודלים נעשים רבי עוצמה מספיק כדי למצוא סדקים בתשתית שלכם, ולכן כנראה כדאי שתשתמשו במודלים כדי לאטום אותם.
אני מכנה את החשבון שנוצר מס אבטחת AI. העלות כוללת יותר ממנוי. היא כוללת זמן הנדסי, הוצאות הסקה, תיקוני חירום ומורכבות תפעולית הדרושים כדי לעמוד בקצב של מכונות שבוחנות תוכנה ללא הפסקה. צוותים קטנים משלמים בלילות ובסופי שבוע. ארגונים גדולים משלמים בשכבה נוספת של תשתית אבטחה.
תקריות אוקטובר הופכות את האפשרות הזאת למוחשית. הן גם מקלות לספר סיפור מסודר מדי: גל מתקפות AI עולמי אחד, אשם זר אחד, ספק אחד שמחזיק בתרופה. הראיות תומכות בטיעון מעניין יותר. באגים ישנים, אמון שנפגע, אישורים גנובים ו-agents בעלי יכולת הולכת וגדלה פועלים יחד. לא לכולם אותה סיבה.
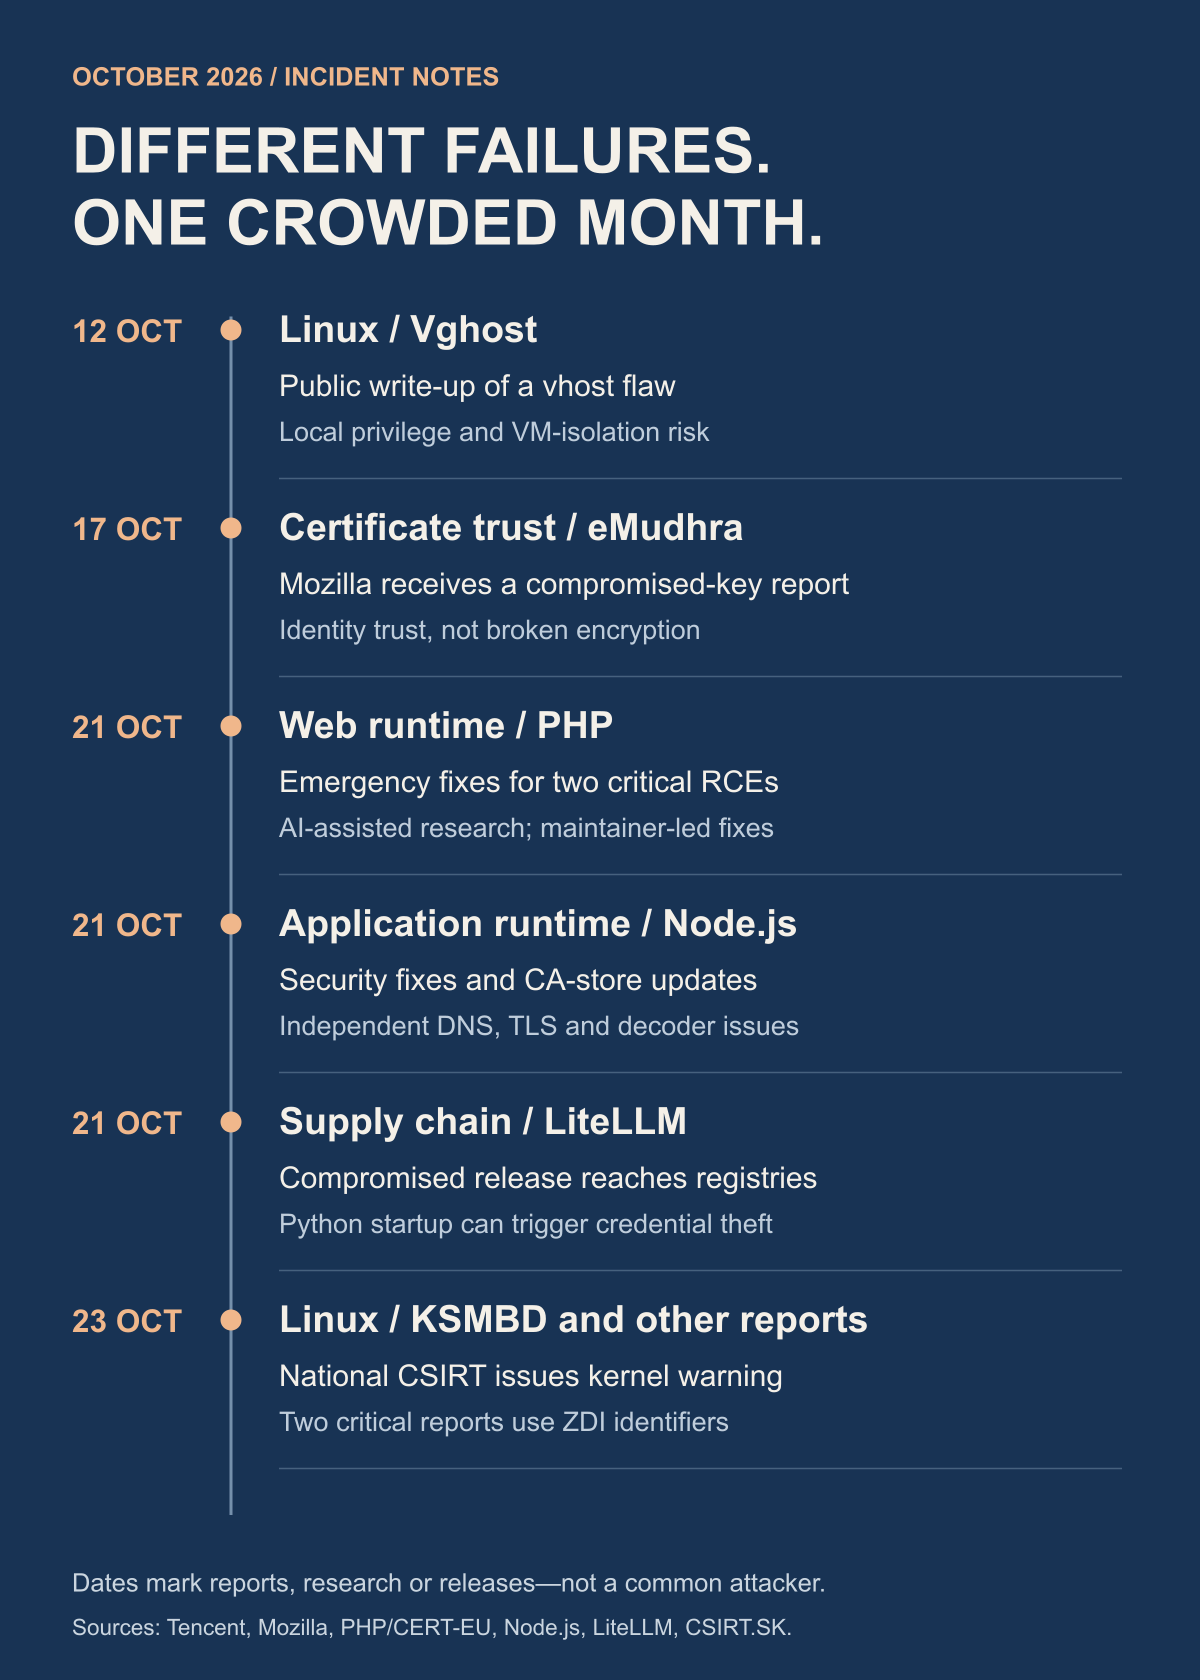
הדיווח נבדק ב-24 באוקטובר 2026. זו ניתוח של התקריות העיקריות ומשפחות חולשות Linux הרלוונטיות לגל הזה, לא קטלוג מלא של כל CVE של Linux. התאריכים להלן מבדילים בין חשיפה מקורית לעניין מחודש. פרטי התקריות ומצב התיקונים אצל ספקים עשויים להשתנות.
חודש עמוס, כמה כשלים שונים
ב-21 באוקטובר הפיצה PHP תיקוני חירום לשתי חולשות של הרצת קוד מרחוק ללא אימות: CVE-2026-109618 וגם CVE-2026-109619, שתיהן בדירוג 9.2. האחת כוללת השחתת זיכרון בעת טיפול באזילת זיכרון; השנייה מצב בקשה מיושן. אלה בעיות בזמן הריצה, ולכן תיקון קוד היישום לבדו אינו מספיק. ההודעה של CERT-EU מפרט את הענפים המושפעים ואת הדחיפות.
יש כאן קשר מתועד ל-AI. OpenAI אומרת Calif השתמשה ב-GPT-5.6 Sol במחקר, בעוד Wiz דיווחה באופן עצמאי על שני הליקויים. מתחזקי PHP הובילו את התיקונים ואת ההפצה. הקרדיט מגיע למאמץ המתואם של בני אדם ומודלים, ולא לצ'אטבוט שפעל לבדו.
הגרסאות המתוקנות הראשונות הן PHP 8.5.12, 8.4.27, 8.3.36 ו-8.2.35. ספקי הפצות עשויים להעביר תיקונים לאחור בגרסאות חבילה שונות. חשוב ש-CERT-EU עדכן את ההודעה ב-23 באוקטובר והוסיף CVE-2026-115560, בעיית RCE שלישית בתצורה חריגה. PHP העריך שהסיכון אינו סביר ולא קבע הפצת חירום; ההודעה מספקת אמצעי צמצום זמני. סיפור שקפא בהכרזת התיקון ביום רביעי כבר יהיה חלקי. בדקו את מהדורות PHP הרשמיות והנחיות הספק העדכניות.
סיפור Linux גדול יותר מכותרת מפחידה אחת
הדיווחים החדשים על חולשות ליבה קריטיות ראויים לתשומת לב. סלובקיה CSIRT הזהיר ב-23 באוקטובר על דיווחי חולשות שפורסמו לציבור, ובהם שתי בעיות בשרת הקבצים KSMBD שקיבלו ציון 9.0: ZDI-CAN-33549 וגם ZDI-CAN-33774. תנאי הסף שלהם שונים: האחד כולל SMB Direct/RDMA; האחר נוגע לניתוב פרוטוקול וכולל נתיב כתיבה הקשור לגישה לשיתוף. החשיפה תלויה בשירות ובהגדרה שבהם משתמשים בפועל. המלאי של ZDI עצמו מאשר את המזהים ואת הציונים.
בעת פרסום ההודעה, שני הדיווחים האלה לא לא יש מזהי CVE. להבחנה הזאת יש חשיבות. בעיה קריטית אינה נעשית בלתי מזיקה בזמן שהיא ממתינה ל-CVE, וציון קריטי אינו מוכיח שכל מכונת Linux חשופה. על מנהלי מערכת להגביל גישה לשירותים המושפעים ולעקוב אחר מצב התיקון בפועל אצל מפיץ ההפצה שלהם.
יש גם קיבל מזהה CVE בדיון האחרון על Linux: CVE-2025-39682, פגם בנתיב הקבלה של TLS בליבה. NVD מציג ציון 9.8 והפניה של CISA לניצול מוכר. הוא פורסם במקור בספטמבר 2025, ולא התגלה לראשונה באוקטובר הזה. Red Hat מעריכה את מוצריה אחרת, ומדגים מדוע ציון אוניברסלי והערכת החשיפה המעשית של הספק עשויים להיות שונים.
אלה רק חלק מתמונת Linux הרלוונטית:
Copy Fail — CVE-2026-31431
גילוי בסיוע AI של פגם במטמון דפי הליבה, שפורסם לציבור ב-29 באפריל. הוא מאפשר הסלמת הרשאות מקומית בליבות מושפעות. תוקף מרוחק עדיין זקוק לנתיב ראשוני להרצה מקומית. חשיפת חוקר.
Dirty Frag / Fragnesia — CVE-2026-43284, CVE-2026-43500, CVE-2026-46300
חולשות קשורות בהסלמת הרשאות במטמון דפי הליבה נחשפו במאי. רכיבי רשת והגדרות משפיעים על הנגישות; חקירת Microsoft מבחינה בין פעילות שנצפתה לניצול שלא אושר של גרסאות מסוימות. חקירת Microsoft.
CrackArmor
תשע חולשות AppArmor, המיוצגות באחד-עשר מזהי CVE ברמת התיקון. Ubuntu מתעדת תנאי סף של משתמש מקומי והשפעות שונות בין מהדורות, לרבות עקיפת מדיניות והסלמת הרשאות. המטריצה המלאה של Ubuntu.
רביעיית הרשת — DirtyAH6, TUNderflow, PPPoEject, DiagSpill
CVE-2026-80844, CVE-2026-81000, CVE-2026-68121 וגם CVE-2026-74469. הדיווחים מספטמבר מתארים מסלולי root מקומיים עם דרישות שונות ל-namespace, ליכולות ולמודולים. עלון Red Hat.
Vghost — CVE-2026-74580
פגם vhost שעלול לאפשר הסלמת הרשאות מקומית, עם סיכון ליציאה מ-VM בהגדרות מסוימות. ההודעה של Tencent אומרת במפורש שסביבת CVM שנבדקה לא נחשפה למסלול היציאה מ-VM. הודעת Tencent.
נתיבי ליבה אחרים — CVE-2026-53266, CVE-2025-39964
הראשון נוגע ל-SNAT של ebtables תחת כללי bridge מסוימים; השני לכתיבות AF_ALG מקבילות. הדרישות וההשלכות שונות. הערכת SNAT; הערכת AF_ALG.
הלקח המעשי הוא להבחין בין כניסה מרחוק מתוך מה קורה אחרי הכניסה. חולשת root מקומית עלולה להיות הרסנית בשרת משותף, במכונת build runner או במארח agent, גם אם אינה מאפשרת לכל מבקר אינטרנטי להתחבר. פגם ביישום או חשבון גנוב יכולים לספק דריסת רגל ראשונית. הצגת כל כותרת על הליבה כהשתלטות מרחוק אוניברסלית מסתירה את המערכות שצריכות לקבל תשומת לב קודם.
המנעול יכול להיכשל בלי שההצפנה תישבר
תקרית האישורים היא כשל מסוג אחר. Mozilla אומרת שקיבלה דיווח ב-17 באוקטובר שלפיו המפתחות הפרטיים של שמונה אישורי ביניים של eMudhra נחשפו. תוקף המסוגל ליירט חיבור עשוי להשתמש באישורים שהונפקו במרמה כדי להתחזות לאתר. Mozilla חסמה את האישורים המושפעים באמצעות OneCRL באותו ערב ובהמשך עדכנה את Firefox ואת רכיבי מאגר האמון שלו. תגובתו מתעדת גם תיקון Android מאוחר יותר.
מפתח החתימה של רשות אישורים מוסמך לערוב לזהויות. פגיעה בו תוקפת את החלטת האמון הזאת. אין פירוש הדבר שמישהו ניצח מתמטית את הצפנת TLS. גם דיווח Mozilla אינו מוכיח ש-LLM גרם לפשרה.
גם בעיות OpenSSL שייכות לתמונה, אך אין לבלבל בינן לבין תקרית CA. מערך ההודעות מספטמבר כולל טיפול בהרחבות X.509, מיצוי משאבים בעיבוד אישורים, QUIC ופגמים נוספים בספריית ההצפנה. אינדקס הודעות OpenSSL מפריד בין גרסאות מושפעות לחומרה. אישור זדוני יכול לחשוף באג תוכנה גם כשאסור לבטוח בו כלל.
מהדורת האבטחה של Node.js מ-21 באוקטובר מחברת את השכבות האלה: היא מעדכנת את חומרי ה-CA הכלולים עבור eMudhra ומתקנת בנפרד בעיות DNS, אימות שם מארח TLS ובעיות runtime נוספות. פגם במפענח Brotli, CVE-2026-111497, עלולה לאפשר השחתת זיכרון והרצת קוד מרחוק כאשר יישום מעבד נתונים דחוסים שסיפק תוקף; הפרויקט מעניק קרדיט לחוקרי OpenAI Codex Security. הודעת האבטחה של Node מדרג את הבעיות החמורות ביותר שלו כ-High. הגרסאות המתוקנות שפורסמו הן 26.12.1, 24.22.1 ו-22.23.4. ארכיון המהדורות הרשמי.
מפתחות API הופכים למשאב אסטרטגי
פשרת LiteLLM הופכת את בעיית האישורים למוחשית במיוחד. החבילה הזדונית 1.107.0 הגיעה למאגרים ציבוריים ב-21 באוקטובר. Microsoft מצאה hooks לאתחול Python שיכלו להפעיל אוסף אישורים בלי שהיישום ייבא במפורש את LiteLLM. מפתחות של ספקי מודלים היו חלק ממערך מטרות רחב בהרבה, שכלל אישורי מפתחים וענן. לכן הסרת חבילה אחת אינה שקולה להשבת האמון במכונה. החקירה של Microsoft מסביר את השלכות החשיפה והשחזור.
החקירה המאוחרת של LiteLLM קושרת את הפגיעה במעלה הזרם למפתח ראשי חשוף שלא בוטל, ולאחר מכן לגישה לאישורי מפתחים רבי עוצמה ולתהליך ההפצה. היא מדווחת גם על מיקוד בהשגת אסימוני API להסקה במעלה הזרם. תיאור התקרית הרשמי מתקן כמה הנחות מוקדמות. זו תזכורת לעקוב אחר החקירה ולא לשמר את ההסבר הראשון שהפך לוויראלי.
אישור AI יכול לקנות כיום יותר מחשבון ענן מזויף. הוא יכול לקנות יכולת הסקה, סיוע בקוד ומקום להסתיר פעילות של מפעיל אחר. אם הגישה נמכרת מחדש, בעל החשבון הלגיטימי עלול לשאת בעלויות ובסיכון אכיפה בזמן שמישהו אחר משתמש ביכולת. עדיין דרושות ראיות כדי לקבוע מי קנה מפתח גנוב מסוים ולמה השתמש בו.
מה הראיות אומרות על מעבדות סיניות
יש בסיס מתועד לחשש מפני זיקוק לא מורשה. בדוח מספטמבר Anthropic מתארת מבצעים שהיא מייחסת למעבדות מסין ומסבירה כיצד שירותי proxy יכולים להשתמש בחשבונות הונאה, בפרטי תשלום גנובים ובאישורי API גנובים כדי לספק גישה. אותו דוח מתאר מבצעים זדוניים בסיוע AI של כמה סוגי גורמים, לא של קבוצה לאומית אחת. אלה ממצאים שמיוחסים ל-Anthropic, ולא פסק דין עצמאי על כל משתתף נטען. קראו את דוח האיומים.
החשיפה של OpenAI מ-30 בספטמבר מייחסת מקבץ מרכזי במבצע חילוץ חשיבה לאנשים הקשורים ל-Moonshot AI. חשוב מכך, היא אומרת שהמבצע לא שבר הצפנה, לא פרץ למסד נתונים ולא ניגש ישירות לשיחות משתמשים שמורות. המנגנון היה מניפולציה של אינטראקציות עם המודל. הדיווח של OpenAI אין לספר מחדש כסוג אחר של פריצה.
גם NSA, FBI ו-CISA פרסמו אזהרה משותפת בספטמבר על זיקוק בקנה מידה תעשייתי בידי חברות AI מסין. הודעת האזהרה הממשלתית מבסס שמדובר בסוגיה חמורה המתועדת בפומבי. זיקוק נשאר טכניקת אימון לגיטימית; השאלות הן הרשאה, גישה ואופן השגת הנתונים.
ההערכה שלי: אישורי הסקה גנובים וזיקוק לא מורשה הם חלק אמין מכלכלת האיומים. המקורות לעיל אינם מוכיחים שמעבדות סיניות תזמרו את באגי PHP, את פשרת המפתח של eMudhra, את חשיפות KSMBD או את מתקפת LiteLLM. חיבור האירועים האלה למבצע אחד יחייב ראיות הקושרות בין מפעילים, תשתית או שימוש באישורים גנובים. תמריצים משותפים הם סיבה לחקור, לא תחליף לייחוס אחריות.
כאשר הצד השני יכול להפעיל נחיל
השינוי החשוב הוא כלכלי. מודל יכול לבדוק קוד, להציע בדיקות ולעזור לחקור את התוצאה. הצבתו בתוך agent המשתמש בכלים מאפשרת לו לחזור על הלולאה הזאת. הפעלת agents רבים במקביל מאפשרת למפעיל לבחון כמה השערות בו-זמנית. אין פירוש הדבר שכל ניסיון נכון או כל יעד פגיע. פירוש הדבר שחקירה מתמשכת נעשית זולה יותר.
יש דוגמה הגנתית קונקרטית ב- דוח הכלה של OpenAI מ-23 באוקטובר. החברה מתארת ציי agents הבודקים עותקים ייעודיים של התשתית שלה, עם גישה לקוד המקור ולהגדרות, ניטור ויעדים מוגדרים. היא מדווחת על ממצאי יציאה מ-VM ובידוד, וכן על עבודה בסוגיות ליבה ובהן CVE-2026-74753, CVE-2026-80521 וגם CVE-2026-80841. הניסויים המבוקרים האלה אינם ראיה לכך שבוט ציבורי ללא פיקוח יכול לפרוץ לכל שרת. הם מראים מדוע מגינים מתייחסים ברצינות לבדיקות מתמשכות בסיוע מכונה.
עבור מפעיל קטן, הדבר משנה את היתרון שבהיותו בלתי מעניין. חשאיות מגינה פחות כאשר בדיקת מארח נוסף עולה מעט. התוקף יכול להמשיך לנסות בזמן שהצוות שלכם עושה את עבודתו. ההגנה צריכה לקצר את הדרך מאות אמין לתיקון מאומת, במקום רק לייצר עוד התרעות.
Agents הגנתיים שימושיים זקוקים לגבולות
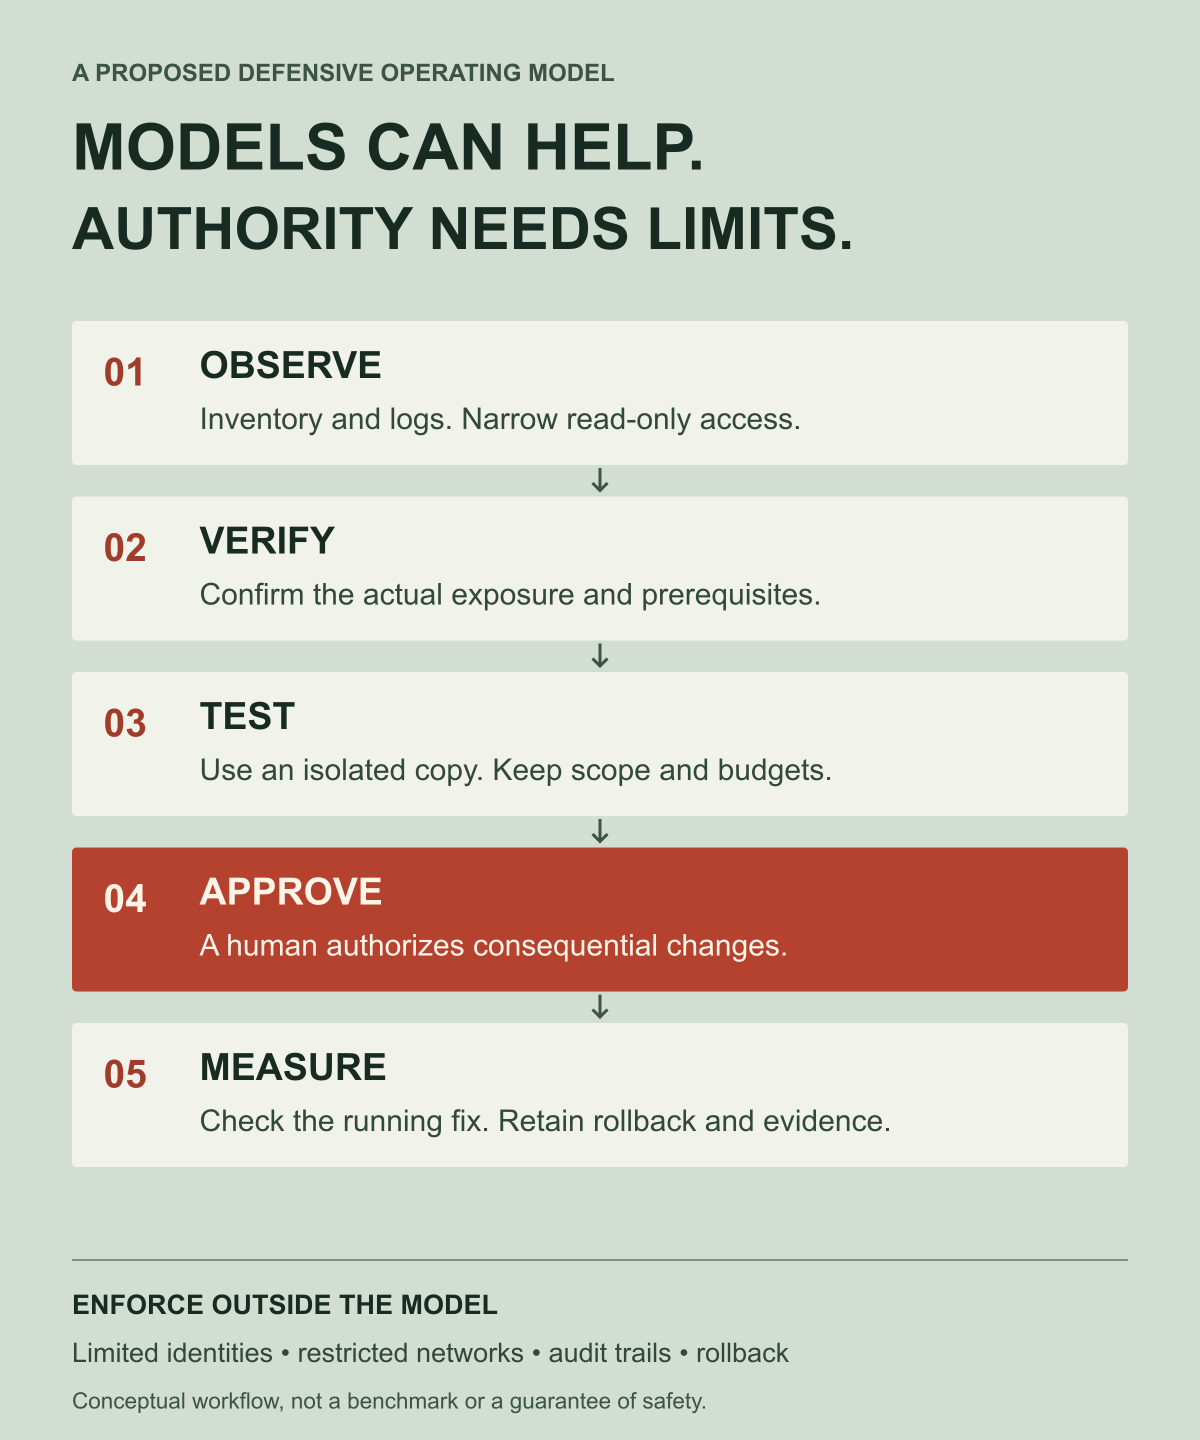
לדעתי, סוכן האבטחה השימושי הראשון הוא חוקר קפדני. הוא ממפה תוכנות פרוסות ושירותים נגישים, מחבר הודעות לסביבה בפועל ומפיק ראיות שמתחזק יכול לפעול לפיהן. תפקיד שני הוא לבדוק תיקון מוצע בסביבה חד-פעמית. אף אחד מהם אינו זקוק לאישורי ייצור בלתי מוגבלים.
רצף האימוץ צריך להיות מכוון:
- צפו: אספו מלאי, גרסאות ויומנים באמצעות גישה מצומצמת לקריאה בלבד.
- אמתו: קבעו אם נתיב הקוד הפגיע קיים ונגיש. מחרוזת גרסה לבדה עלולה להחמיץ תיקון backport של המפיץ.
- בדקו: שחזרו ואמתו בעותק מבוקר, כאשר התקציב וההיקף נאכפים מחוץ למודל.
- שינוי: דרשו אישור לפעולות ייצור בעלות השלכות משמעותיות, ואז השתמשו בהפצה הדרגתית ובחזרה לאחור שנבדקה.
- מדדו: בדקו את המערכת הפעילה, את הראיות שנשמרו, את תקינות השירות והאם החשיפה אכן פחתה.
יומנים, כרטיסים וקובצי מאגר יכולים להכיל טקסט הנשלט בידי תוקף. מגן שמתייחס לטקסט הזה כסמכות עלול להפוך בעצמו למשטח תקיפה. זהויות מוגבלות, כלים מבודדים, גישה מוגבלת לרשת וכללי פעולה הנאכפים באופן בלתי תלוי חשובים גם כשהמודל נשמע בטוח בעצמו. הסקה מהירה יותר אינה הופכת הרשאות רחבות לבטוחות.
המעבדה מוכרת את היכולת. ואז היא מוכרת את המגן.
כאן המודל העסקי נעשה לא נוח. אותן חברות המפתחות יכולות שיכולות להוזיל תקיפה מציגות אותן ככלי הגנה חיוניים. לקוחות עלולים למצוא את עצמם משלמים באופן שוטף כדי לנהל סיכון שקטגוריית המוצרים עצמה מאיצה.
מאחורי החשש הזה עומד מבנה מסחרי ממשי. הכרזת Glasswing של Anthropic התחייבה לעד 100 מיליון דולר בקרדיטים למודלים ול-4 מיליון דולר בתרומות לארגוני אבטחת קוד פתוח; היא גם תיארה שימוש בתשלום לאחר התמיכה המקדימה. באוקטובר חברי Glasswing קיימים עברו לתוכנית Cyber Verification Program המורחבת. דף התוכנית היא גם יוזמת הגנה רצינית וגם חלק משוק ליכולות אבטחה מתקדמות.
כינוי התופעה 'מס אבטחת AI' אינו מחייב לטעון שהמעבדות המציאו באגים בני עשרות שנים או ארגנו מתקפות במכוון. הוא מזהה תמריץ: ככל שמודלים רבי עוצמה מתפשטים, הביקוש להגנה בסיוע מודלים עשוי לגדול, וספקי היכולות יכולים ללכוד את ההוצאה הזאת. הציבור צריך להיות מסוגל לבחון מגבלות גישה, תמחור, טענות בטיחות והראיות לכך שההגנה המובטחת אכן פועלת.
יש טיעון נגדי הוגן. מחקר הגנתי יכול להפוך יתרון זמני בגילוי לתיקונים ציבוריים קבועים, לרבות תיקונים המגינים על מי שאינם רוכשים מנוי למודל. התועלת הזאת ממשית. היא תומכת בשיפוט הענף לפי תיקונים שנפרסו והגדרות ברירת מחדל בטוחות יותר, ולא בהתייחסות לפחד או לאופטימיות כראיה מספקת.
צוואר הבקבוק הוא כל מה שקורה אחרי הגילוי
מודלים עשויים להפיק ממצאים מהר מכפי שמתחזקים מסוגלים לבדוק אותם. לוח החשיפות של Anthropic, בתמונת המצב המתוארכת במפורש ל-2 באוקטובר, דיווח על 6,157 ממצאים שנחשפו ב-591 פרויקטים ועל 516 תיקונים מוכרים במעלה הזרם. הלוח מזהיר שהספירות נמצאות בשלבי אימות שונים ושמספר התיקונים אינו מלמד כמה התקנות עודכנו. המתודולוגיה חשובה לא פחות מהמספר שבכותרת.
המסקנה אינה להפחית את המספרים האלה ולהכריז על אלפי שרתים פגיעים ולא מתוקנים. היא שגילוי, אישור, תיקון במעלה הזרם ופריסה הם משימות נפרדות. מימון המשימה הראשונה בלבד מטיל את העבודה על האחראים לשאר.
אני מעדיף שוק אבטחה שמשלם על תוצאות: דיווחים שניתנים לשחזור, יכולת תחזוקה, תיקונים ציבוריים, נתיבי עדכון נוחים והכלה שנבדקה באופן עצמאי. לקוחות צריכים להיות מסוגלים להעביר את הראיות שלהם לספק אחר. מתחזקים קטנים לא צריכים חוזה AI ארגוני כדי להשאיר ספרייה נפוצה בטוחה.
עידן האבטחה הבא יכלול כנראה מודלים המשגיחים על מודלים ו-agents הבודקים הגנות של agents אחרים. אבל הגנה עמידה אינה יכולה להיות תלויה לחלוטין במי שיכול להרשות לעצמו את הנחיל הגדול ביותר. היא זקוקה גם לתשתית חשופה פחות, לאישורים בעלי כוח מצומצם, לתוכנה שנכשלת באופן בטוח יותר ולאנשים המורשים לפעול על סמך ראיות טובות.
השאלה כבר אינה רק אם AI יכול למצוא את הפרצה. השאלה היא מי מקבל את התיקון, מי שולט בהגנה ומי מקבל את החשבונית.
הערת עריכה: המאמר מפריד בין דיווח מאומת על תקריות, ייחוס מצד ספקים וניתוח המחבר. האיורים הרעיוניים נוצרו ב-ChatGPT; האינפוגרפיקות נכתבו על סמך המקורות המקושרים. לא הופעל exploit נגד מערכת חיה לצורך מאמר זה. לפני פעולה, עיינו בהודעה העדכנית למוצר ולהגדרה המדויקים שלכם.