I laboratori che rendono il software più facile da violare vendono anche gli strumenti per difenderlo. Gli incidenti di sicurezza di questo mese mostrano perché quel modello commerciale merita attenzione e perché la risposta non può essere un’altra scatola nera con una fattura API più alta.
Nel settore dell’IA prende forma un’offerta commerciale imbarazzante: i modelli diventano abbastanza potenti da trovare le crepe nella vostra infrastruttura, quindi probabilmente dovreste usare i modelli per aiutarvi a chiuderle.
Chiamo il conto che ne deriva la tassa sulla sicurezza dell’IA. Comprende più di un abbonamento: tempo di ingegneria, spesa per l’inferenza, patch d’emergenza e complessità operativa necessarie per tenere il passo con macchine capaci di esaminare il software continuamente. I piccoli team la pagano con notti e fine settimana. Le grandi organizzazioni con un altro strato di infrastruttura di sicurezza.
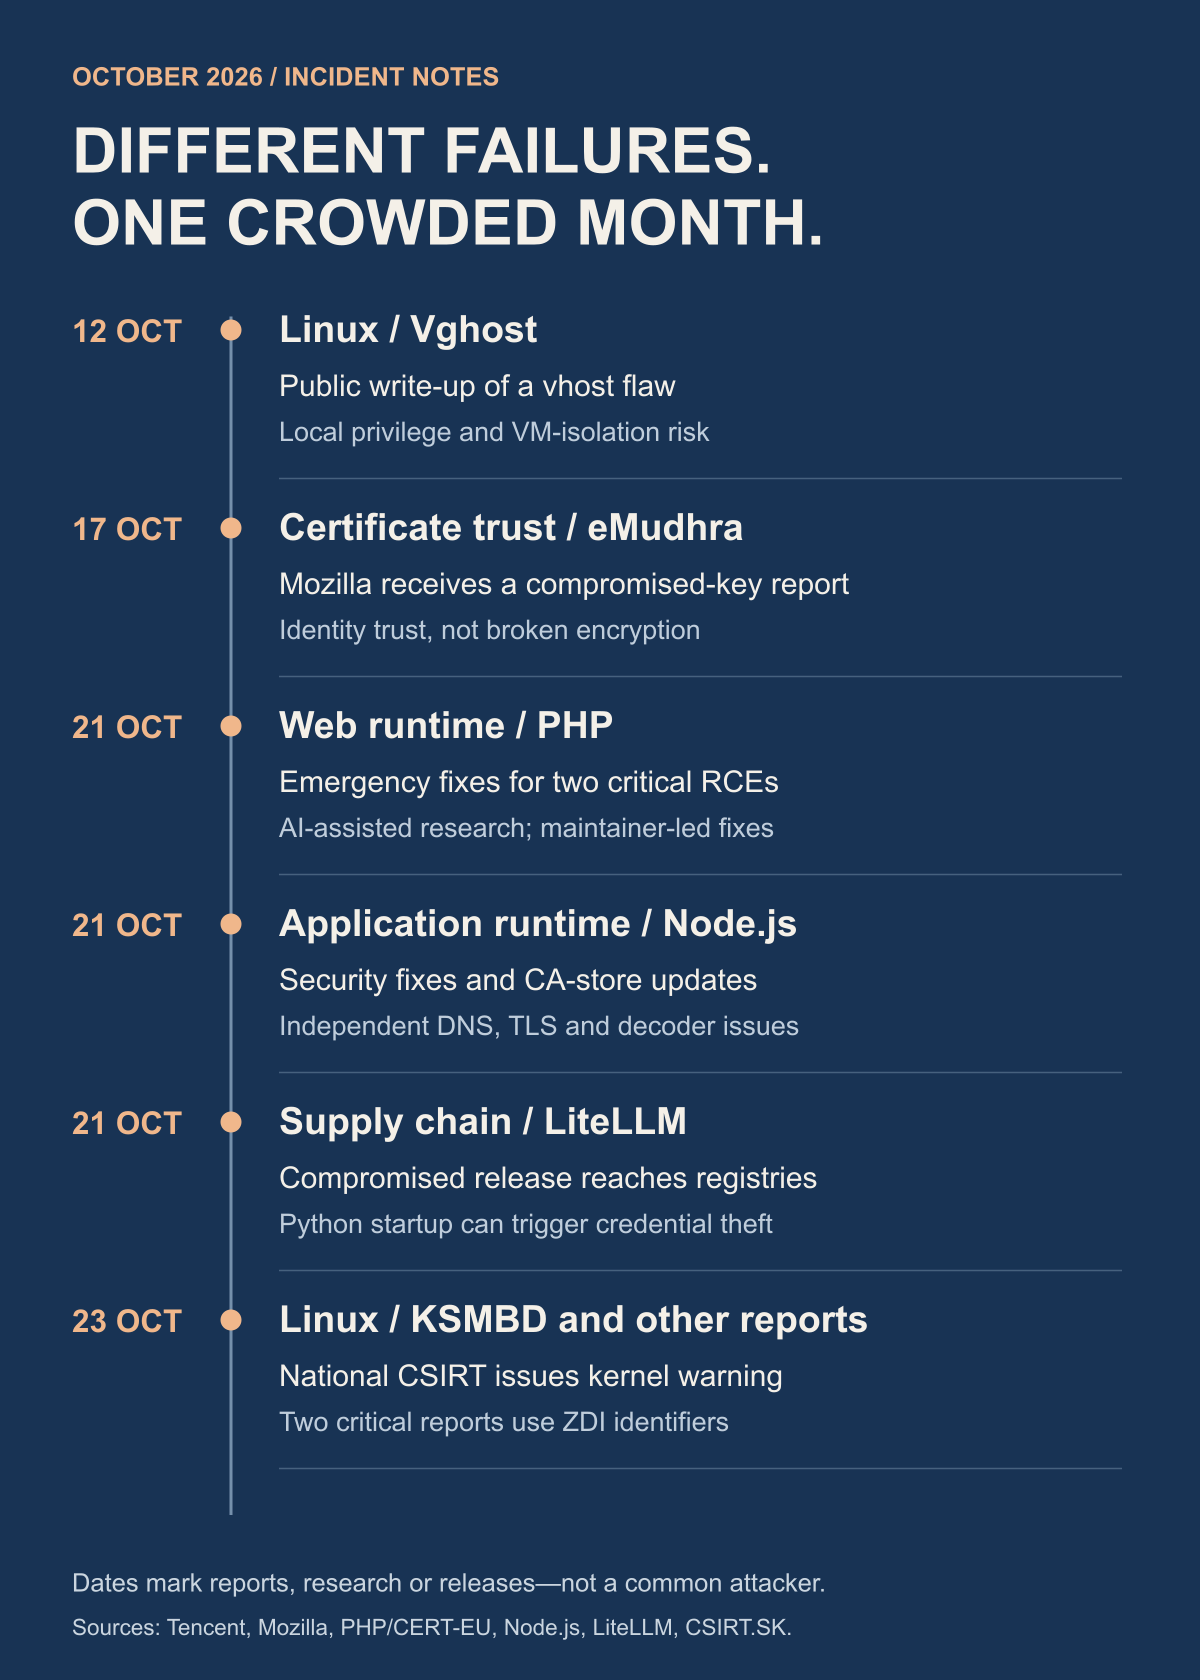
Gli incidenti di ottobre rendono concreta questa prospettiva. Rendono anche facile raccontare una storia troppo ordinata: un’unica ondata globale di attacchi IA, un colpevole straniero, un fornitore con la cura. Le prove sostengono un’argomentazione più interessante. Vecchi bug, fiducia compromessa, credenziali rubate e agenti sempre più capaci interagiscono. Non hanno tutti la stessa causa.
Fonti verificate il 24 ottobre 2026. Questa è un’analisi dei principali incidenti e delle famiglie di vulnerabilità Linux rilevanti per questa ondata, non un catalogo esaustivo di ogni CVE Linux. Le date distinguono la divulgazione originale dalla rinnovata attenzione. Dettagli degli incidenti e stato delle patch dei fornitori possono cambiare.
Un mese intenso, diversi guasti differenti
Il 21 ottobre PHP ha distribuito correzioni d’emergenza per due falle di esecuzione di codice remoto senza autenticazione: CVE-2026-109618 e CVE-2026-109619, entrambi valutati 9.2. Uno riguarda la corruzione della memoria durante la gestione della memoria esaurita; l’altro uno stato della richiesta obsoleto. Sono problemi dell’ambiente di esecuzione, quindi correggere soltanto il codice applicativo non basta. L’avviso di CERT-EU indica i rami interessati e l’urgenza.
Qui esiste un legame documentato con l’IA. OpenAI afferma Calif ha usato GPT-5.6 Sol nella ricerca, mentre Wiz ha segnalato entrambe le falle in modo indipendente. I manutentori di PHP hanno guidato le correzioni e il rilascio. Il merito appartiene a questo sforzo coordinato tra persone e modello, non a un chatbot che agisce da solo.
Le prime versioni corrette sono PHP 8.5.12, 8.4.27, 8.3.36 e 8.2.35. I distributori possono retroportare le correzioni con versioni di pacchetto diverse. È importante che CERT-EU abbia aggiornato il proprio avviso il 23 ottobre aggiungendo CVE-2026-115560, un terzo problema RCE relativo a una configurazione insolita. PHP ha ritenuto tale rischio improbabile e non ha programmato un rilascio d’emergenza; l’avviso fornisce una mitigazione provvisoria. Un racconto fermo all’annuncio delle patch di mercoledì sarebbe già incompleto. Controllare i rilasci ufficiali di PHP e le indicazioni attuali del fornitore.
La storia di Linux è più grande di un titolo allarmante
I più recenti rapporti critici sul kernel meritano attenzione. L’organismo slovacco Il CSIRT ha avvertito il 23 ottobre sui rapporti di vulnerabilità esposti pubblicamente, tra cui due problemi del file server KSMBD valutati 9.0: ZDI-CAN-33549 e ZDI-CAN-33774. I prerequisiti differiscono: uno coinvolge SMB Direct/RDMA; l’altro riguarda lo smistamento dei protocolli e ha un percorso di scrittura legato all’accesso a una condivisione. L’esposizione dipende dal servizio e dalla configurazione effettivamente usati. L’inventario di ZDI stesso conferma gli identificativi e i punteggi.
Alla pubblicazione dell’avviso, quei due rapporti non avevano identificativi CVE. Questa distinzione conta. Un problema critico non diventa innocuo mentre aspetta un CVE, e un punteggio critico non dimostra che tutte le macchine Linux siano esposte. Gli amministratori dovrebbero limitare l’accesso ai servizi interessati e seguire lo stato effettivo delle correzioni del proprio distributore.
Esiste anche una falla critica CVE assegnato nel recente dibattito su Linux: CVE-2025-39682, una falla nel percorso di ricezione TLS del kernel. NVD indica un punteggio di 9.8 e un riferimento CISA a uno sfruttamento noto. È stata pubblicata originariamente a settembre 2025, non scoperta per la prima volta questo ottobre. Red Hat valuta i propri prodotti diversamente, mostrando perché un punteggio universale e la valutazione pratica dell’esposizione di un fornitore possano divergere.
Questi sono soltanto una parte del quadro Linux pertinente:
Copy Fail — CVE-2026-31431
Scoperta assistita dall’IA di una falla nella cache delle pagine del kernel, divulgata pubblicamente il 29 aprile. Consente l’escalation locale dei privilegi sui kernel interessati. Un aggressore remoto necessita comunque di una prima via verso l’esecuzione locale. Divulgazione del ricercatore.
Dirty Frag / Fragnesia — CVE-2026-43284, CVE-2026-43500, CVE-2026-46300
Problemi correlati di escalation dei privilegi tramite la cache delle pagine divulgati a maggio. Componenti di rete e configurazione influenzano la raggiungibilità; l’indagine Microsoft distingue l’attività osservata dallo sfruttamento non confermato di singole varianti. Indagine di Microsoft.
CrackArmor
Nove vulnerabilità AppArmor, rappresentate da undici identificativi CVE a livello di patch. Ubuntu documenta prerequisiti da utente locale e impatti diversi tra versioni, inclusi aggiramento delle policy ed escalation dei privilegi. La matrice completa di Ubuntu.
Il quartetto di rete — DirtyAH6, TUNderflow, PPPoEject, DiagSpill
CVE-2026-80844, CVE-2026-81000, CVE-2026-68121 e CVE-2026-74469. I resoconti di settembre descrivono percorsi verso privilegi root locali con requisiti differenti per namespace, capability e moduli. Bollettino Red Hat.
Vghost — CVE-2026-74580
Una falla di vhost che può permettere un’escalation locale dei privilegi, con rischio di evasione dalla VM in configurazioni particolari. L’avviso di Tencent afferma esplicitamente che il suo ambiente CVM controllato non era esposto al percorso di evasione dalla VM. Avviso di Tencent.
Altri percorsi del kernel — CVE-2026-53266, CVE-2025-39964
Il primo riguarda ebtables SNAT con regole di bridge specifiche; il secondo scritture AF_ALG concorrenti. Requisiti e conseguenze sono differenti. Valutazione di SNAT; Valutazione di AF_ALG.
La lezione pratica è distinguere l’accesso remoto da ciò che accade dopo l’accesso. Una vulnerabilità che concede privilegi root locali può essere devastante su un server condiviso, un esecutore di build o un host per agenti, anche se non permette a un visitatore qualsiasi di Internet di accedere. Una falla applicativa o un account rubato può fornire il primo punto d’appoggio. Trattare ogni titolo sul kernel come una presa di controllo remota universale nasconde quali sistemi richiedono davvero attenzione per primi.
Il lucchetto può cedere senza che la cifratura venga violata
L’incidente dei certificati è un tipo diverso di fallimento. Mozilla afferma di aver ricevuto il 17 ottobre una segnalazione sulla compromissione delle chiavi private di otto certificati intermedi eMudhra. Un aggressore capace di intercettare una connessione potrebbe usare certificati emessi fraudolentemente per impersonare un sito. Mozilla ha bloccato i certificati interessati tramite OneCRL quella sera e successivamente ha aggiornato Firefox e i componenti dell’archivio di fiducia. La risposta registra anche una successiva correzione per Android.
La chiave di firma di un’autorità di certificazione conferisce il potere di garantire le identità. Comprometterla attacca quella decisione di fiducia. Non significa che qualcuno abbia sconfitto matematicamente la cifratura TLS. Nemmeno il resoconto di Mozilla dimostra che la compromissione sia stata causata da un LLM.
Anche i problemi OpenSSL fanno parte del quadro, ma non vanno confusi con l’incidente della CA. Gli avvisi di settembre includono gestione delle estensioni X.509, esaurimento delle risorse nell’elaborazione dei certificati, QUIC e altri difetti delle librerie crittografiche. L’indice degli avvisi OpenSSL distingue le versioni interessate e la gravità. Un certificato malevolo può esporre un difetto software anche quando quel certificato non dovrebbe mai essere considerato attendibile.
Il rilascio di sicurezza di Node.js del 21 ottobre riunisce questi strati: aggiorna il materiale CA incluso per eMudhra e corregge problemi indipendenti di DNS, verifica dei nomi host TLS e altri componenti runtime. Una falla del decoder Brotli, CVE-2026-111497, potrebbe consentire corruzione della memoria ed esecuzione di codice da remoto quando un’applicazione elabora dati compressi forniti da un aggressore; il progetto attribuisce la scoperta ai ricercatori di OpenAI Codex Security. L’avviso di sicurezza di Node classifica i problemi più gravi come High. Le versioni corrette pubblicate sono 26.12.1, 24.22.1 e 22.23.4. Archivio ufficiale dei rilasci.
Le chiavi API stanno diventando una risorsa strategica
La compromissione di LiteLLM rende particolarmente concreto il problema delle credenziali. Il pacchetto malevolo 1.107.0 è arrivato nei registri pubblici il 21 ottobre. Microsoft ha individuato hook di avvio di Python capaci di attivare un raccoglitore di credenziali senza un’importazione esplicita di LiteLLM da parte di un’applicazione. Le chiavi dei fornitori di modelli erano parte di un insieme di obiettivi molto più ampio, comprendente credenziali degli sviluppatori e del cloud. Rimuovere un singolo pacchetto non equivale quindi a ripristinare la fiducia nella macchina. L’indagine di Microsoft spiega le implicazioni per l’esposizione e il ripristino.
La successiva indagine di LiteLLM stessa fa risalire la compromissione a monte a una chiave principale esposta e non revocata, seguita dall’accesso a potenti credenziali degli sviluppatori e al processo di rilascio. Segnala inoltre un interesse specifico per l’acquisizione di token API di inferenza a monte. Il resoconto di riferimento dell’incidente corregge alcune ipotesi iniziali. Ricorda che bisogna seguire l’indagine, non conservare la prima spiegazione diventata virale.
Una credenziale di IA può ora comprare più di una fattura cloud fraudolenta. Può comprare ragionamento, assistenza alla programmazione e un luogo in cui nascondere l’attività di un altro operatore. Se l’accesso viene rivenduto, il titolare legittimo può sostenere costi e rischi di sanzioni mentre qualcun altro usa quelle capacità. Chi abbia acquistato una specifica chiave rubata e per cosa l’abbia usata richiede ancora prove.
Cosa dicono le prove sui laboratori cinesi
Esiste una base documentata per la preoccupazione sulla distillazione non autorizzata. Nel rapporto di settembre, Anthropic descrive campagne attribuite a laboratori con sede in Cina e spiega come i servizi proxy possano usare account fraudolenti, dati di pagamento rubati e credenziali API rubate per fornire accesso. Lo stesso rapporto descrive operazioni malevole assistite dall’IA di diversi tipi di attori, non di un unico gruppo nazionale. Sono risultati attribuiti da Anthropic, non un verdetto indipendente su ogni presunto partecipante. Leggere il rapporto sulle minacce.
La divulgazione di OpenAI del 30 settembre attribuisce un nucleo di una campagna di estrazione del ragionamento a persone associate a Moonshot AI. Soprattutto, precisa che la campagna non ha violato la cifratura, compromesso un database né avuto accesso diretto alle conversazioni degli utenti archiviate. Il meccanismo era la manipolazione delle interazioni con il modello. Il resoconto di OpenAI non dovrebbe essere raccontato come un diverso tipo di violazione.
Anche NSA, FBI e CISA hanno diffuso a settembre un avvertimento congiunto sulla distillazione su scala industriale da parte di aziende di IA con sede in Cina. L’annuncio dell’avviso governativo dimostra che si tratta di una preoccupazione seria e documentata pubblicamente. La distillazione resta di per sé una tecnica di addestramento legittima; le questioni riguardano autorizzazione, accesso e modalità di acquisizione dei dati.
La mia valutazione: le credenziali di inferenza rubate e la distillazione non autorizzata sono una parte credibile dell’economia delle minacce. Le fonti precedenti non dimostrano che laboratori cinesi abbiano orchestrato i bug di PHP, la compromissione della chiave eMudhra, le divulgazioni KSMBD o l’attacco LiteLLM. Collegare questi eventi in un’unica campagna richiederebbe prove che uniscano operatori, infrastrutture o uso delle credenziali rubate. Incentivi condivisi giustificano un’indagine, non sostituiscono l’attribuzione.
Quando l’altra parte può usare uno sciame
Il cambiamento importante è economico. Un modello può esaminare codice, proporre test e aiutare a studiarne i risultati. Inserito in un agente che usa strumenti può ripetere quel ciclo. Con molti agenti in parallelo un operatore può esplorare più ipotesi contemporaneamente. Questo non rende ogni tentativo corretto o ogni obiettivo vulnerabile. Rende più economica l’indagine continuativa.
Un esempio difensivo concreto si trova in Il rapporto di contenimento di OpenAI del 23 ottobre. L’azienda descrive flotte di agenti che testano copie apposite della sua infrastruttura, con accesso a sorgenti e configurazione, monitoraggio e obiettivi delimitati. Riporta scoperte di evasione dalle VM e problemi di isolamento, oltre a lavori su problemi del kernel tra cui CVE-2026-74753, CVE-2026-80521 e CVE-2026-80841. Questi esperimenti controllati non provano che un bot pubblico senza supervisione possa violare qualsiasi server. Mostrano perché i difensori prendono sul serio i test continuativi assistiti dalle macchine.
Per un piccolo operatore cambia il vantaggio di non essere interessante. L’anonimato protegge meno quando controllare un altro host costa poco. L’aggressore può continuare a tentare mentre il team svolge il proprio lavoro effettivo. La risposta difensiva deve accorciare il percorso da un segnale credibile a una correzione verificata, invece di generare soltanto più avvisi.
Gli agenti difensivi utili hanno bisogno di confini
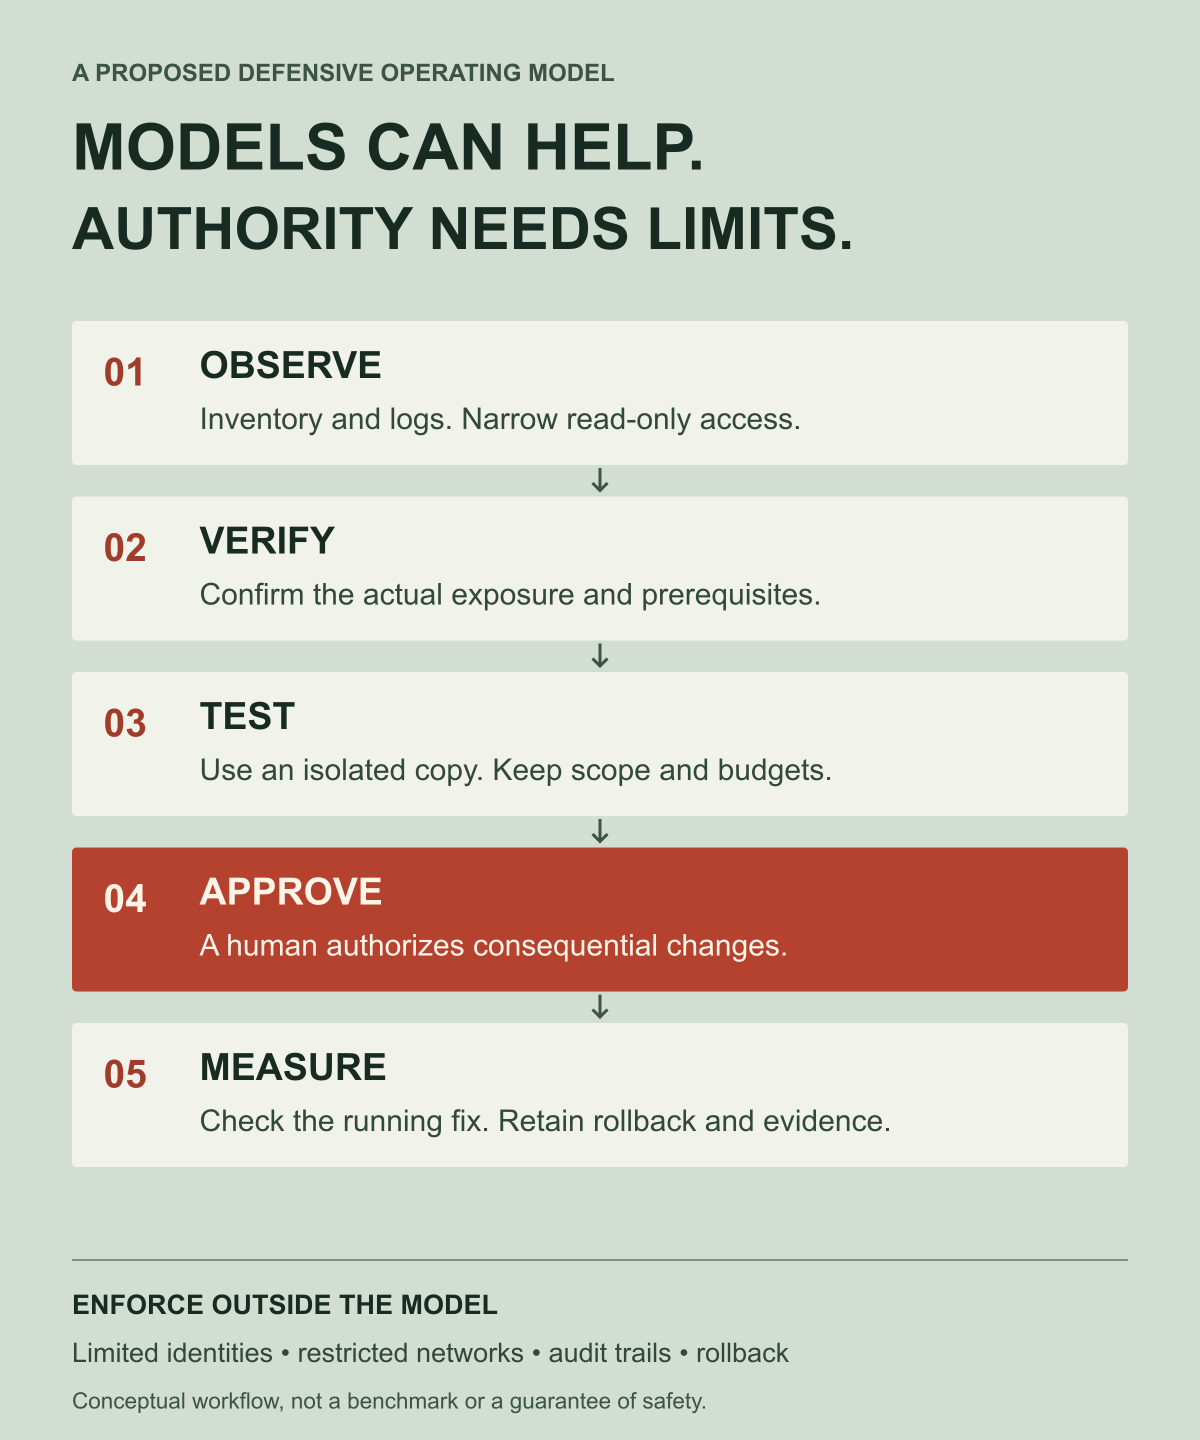
A mio avviso, il primo agente di sicurezza utile è un investigatore meticoloso. Mappa software distribuito e servizi raggiungibili, collega gli avvisi all’ambiente effettivo e produce prove su cui un manutentore può agire. Un secondo ruolo consiste nel testare una correzione proposta in un ambiente usa e getta. Nessuno dei due richiede credenziali di produzione senza limiti.
La sequenza di adozione dovrebbe essere deliberata:
- Osservare: raccogliere inventario, versioni e log usando accessi limitati in sola lettura.
- Verificare: stabilire se il percorso di codice vulnerabile sia presente e raggiungibile. Una sola stringa di versione può non rivelare una correzione retroportata dal distributore.
- Testare: riprodurre e convalidare in una copia controllata, con budget e ambito imposti al di fuori del modello.
- Modificare: richiedere l’approvazione per azioni di produzione rilevanti, quindi procedere con un rilascio graduale e un ripristino collaudato.
- Misurare: controllare il sistema in esecuzione, le prove conservate, lo stato dei servizi e se l’esposizione sia realmente diminuita.
Log, ticket e file dei repository possono contenere testo controllato da aggressori. Un difensore che tratta quel testo come autorità può diventare un’ulteriore superficie d’attacco. Identità limitate, strumenti isolati, accesso di rete ristretto e regole operative imposte indipendentemente contano anche quando il modello appare sicuro di sé. Ragionare più velocemente non rende più sicuri permessi estesi.
Il laboratorio vende la capacità. Poi vende lo scudo.
È qui che il modello commerciale diventa scomodo. Le stesse aziende che sviluppano capacità in grado di ridurre il costo degli attacchi le presentano come strumenti difensivi essenziali. I clienti possono ritrovarsi a pagare un conto continuo per gestire un rischio che la categoria di prodotto stessa sta accelerando.
Dietro questa preoccupazione c’è una struttura commerciale concreta. L’annuncio Glasswing di Anthropic impegnava fino a 100 milioni di dollari in crediti per i modelli e 4 milioni di dollari in donazioni a organizzazioni di sicurezza open source; descriveva anche l’uso a pagamento dopo il sostegno dell’anteprima. A ottobre, i membri Glasswing esistenti stavano passando al Cyber Verification Program ampliato. La pagina del programma è sia una seria iniziativa difensiva sia parte di un mercato delle capacità di sicurezza avanzate.
Chiamarla tassa sulla sicurezza dell’IA non richiede di sostenere che i laboratori abbiano inventato bug vecchi di decenni o organizzato deliberatamente attacchi. Identifica un incentivo: la diffusione di modelli potenti può aumentare la domanda di difesa assistita dai modelli, e i fornitori di quelle capacità possono intercettare tale spesa. Il pubblico dovrebbe poter esaminare restrizioni di accesso, prezzi, affermazioni sulla sicurezza e prove dell’efficacia della protezione promessa.
Esiste una controargomentazione ragionevole. La ricerca difensiva può trasformare un vantaggio temporaneo nella scoperta in patch pubbliche permanenti, comprese correzioni che proteggono chi non acquista mai un abbonamento a un modello. Questo beneficio è reale. Suggerisce di giudicare il settore in base alle correzioni distribuite e alle impostazioni predefinite più sicure, anziché considerare paura o ottimismo prove sufficienti.
Il collo di bottiglia è tutto ciò che segue la scoperta
I modelli possono produrre risultati più velocemente di quanto i manutentori riescano necessariamente a esaminarli. La dashboard di Anthropic, nella fotografia esplicitamente datata 2 ottobre, riportava 6.157 risultati divulgati in 591 progetti e 516 patch note a monte. Avverte che i conteggi corrispondono a fasi di convalida differenti e che il numero di patch non mostra quanto diffusamente le correzioni siano installate. La metodologia conta quanto il numero nel titolo.
La lezione non è sottrarre quei numeri e annunciare migliaia di server sfruttabili e privi di patch. Scoperta, conferma, riparazione a monte e distribuzione sono lavori distinti. Finanziare soltanto il primo trasferisce il lavoro alle persone responsabili del resto.
Preferisco un mercato della sicurezza che paghi i risultati: rapporti riproducibili, capacità dei manutentori, correzioni pubbliche, percorsi di aggiornamento utilizzabili e contenimento testato indipendentemente. I clienti dovrebbero poter portare le proprie prove a un altro fornitore. I piccoli manutentori non dovrebbero aver bisogno di un contratto aziendale di IA per mantenere sicura una libreria molto usata.
La prossima era della sicurezza comprenderà probabilmente modelli che osservano altri modelli e agenti che testano le difese contro altri agenti. Ma una difesa duratura non può dipendere interamente da chi può permettersi lo sciame più grande. Servono anche infrastrutture meno esposte, credenziali meno potenti, software che fallisca in modo più sicuro e persone autorizzate ad agire su prove solide.
La domanda non è più soltanto se l’IA possa trovare la falla. È chi riceve la correzione, chi controlla la difesa e chi riceve la fattura.
Nota editoriale: questo articolo distingue resoconti verificati degli incidenti, attribuzioni dei fornitori e analisi dell’autore. Le illustrazioni concettuali sono state generate con ChatGPT; le infografiche sono state realizzate dai documenti collegati. Per questo articolo non è stato eseguito alcun exploit contro un sistema attivo. Prima di agire, consultare l’avviso aggiornato per il prodotto e la configurazione esatti.