Die Labore, die Software leichter angreifbar machen, verkaufen auch die Werkzeuge zu ihrer Verteidigung. Die Sicherheitsvorfälle dieses Monats zeigen, weshalb dieses Geschäftsmodell genauer geprüft werden muss – und weshalb die Antwort keine weitere Blackbox mit einer höheren API-Rechnung sein kann.
In der KI-Branche zeichnet sich ein unangenehmes Verkaufsargument ab: Die Modelle werden leistungsfähig genug, um Risse in Ihrer Infrastruktur zu finden; deshalb sollten Sie wohl die Modelle nutzen, um sie zu schließen.
Die daraus entstehende Rechnung nenne ich KI-Sicherheitssteuer. Sie umfasst mehr als ein Abonnement: Entwicklungszeit, Inferenzkosten, Notfall-Patches und betriebliche Komplexität, um mit Maschinen Schritt zu halten, die Software ununterbrochen untersuchen können. Kleine Teams bezahlen mit Nächten und Wochenenden. Große Organisationen bezahlen mit einer weiteren Schicht Sicherheitsinfrastruktur.
Die Vorfälle im Oktober machen diese Aussicht konkret. Sie verführen auch zu einer allzu glatten Geschichte: eine globale KI-Angriffswelle, ein ausländiger Schuldiger, ein Anbieter mit der Heilung. Die Belege stützen ein interessanteres Argument. Alte Fehler, kompromittiertes Vertrauen, gestohlene Zugangsdaten und immer leistungsfähigere Agenten wirken zusammen. Sie haben nicht alle dieselbe Ursache.
Berichterstattung geprüft am 24. Oktober 2026. Dies ist eine Analyse der wichtigsten Vorfälle und Linux-Schwachstellenfamilien dieser Welle, kein vollständiger Katalog aller Linux-CVEs. Die folgenden Daten unterscheiden ursprüngliche Offenlegung und erneute Aufmerksamkeit. Vorfalldetails und Patch-Status der Anbieter können sich ändern.
Ein ereignisreicher Monat, mehrere unterschiedliche Fehler
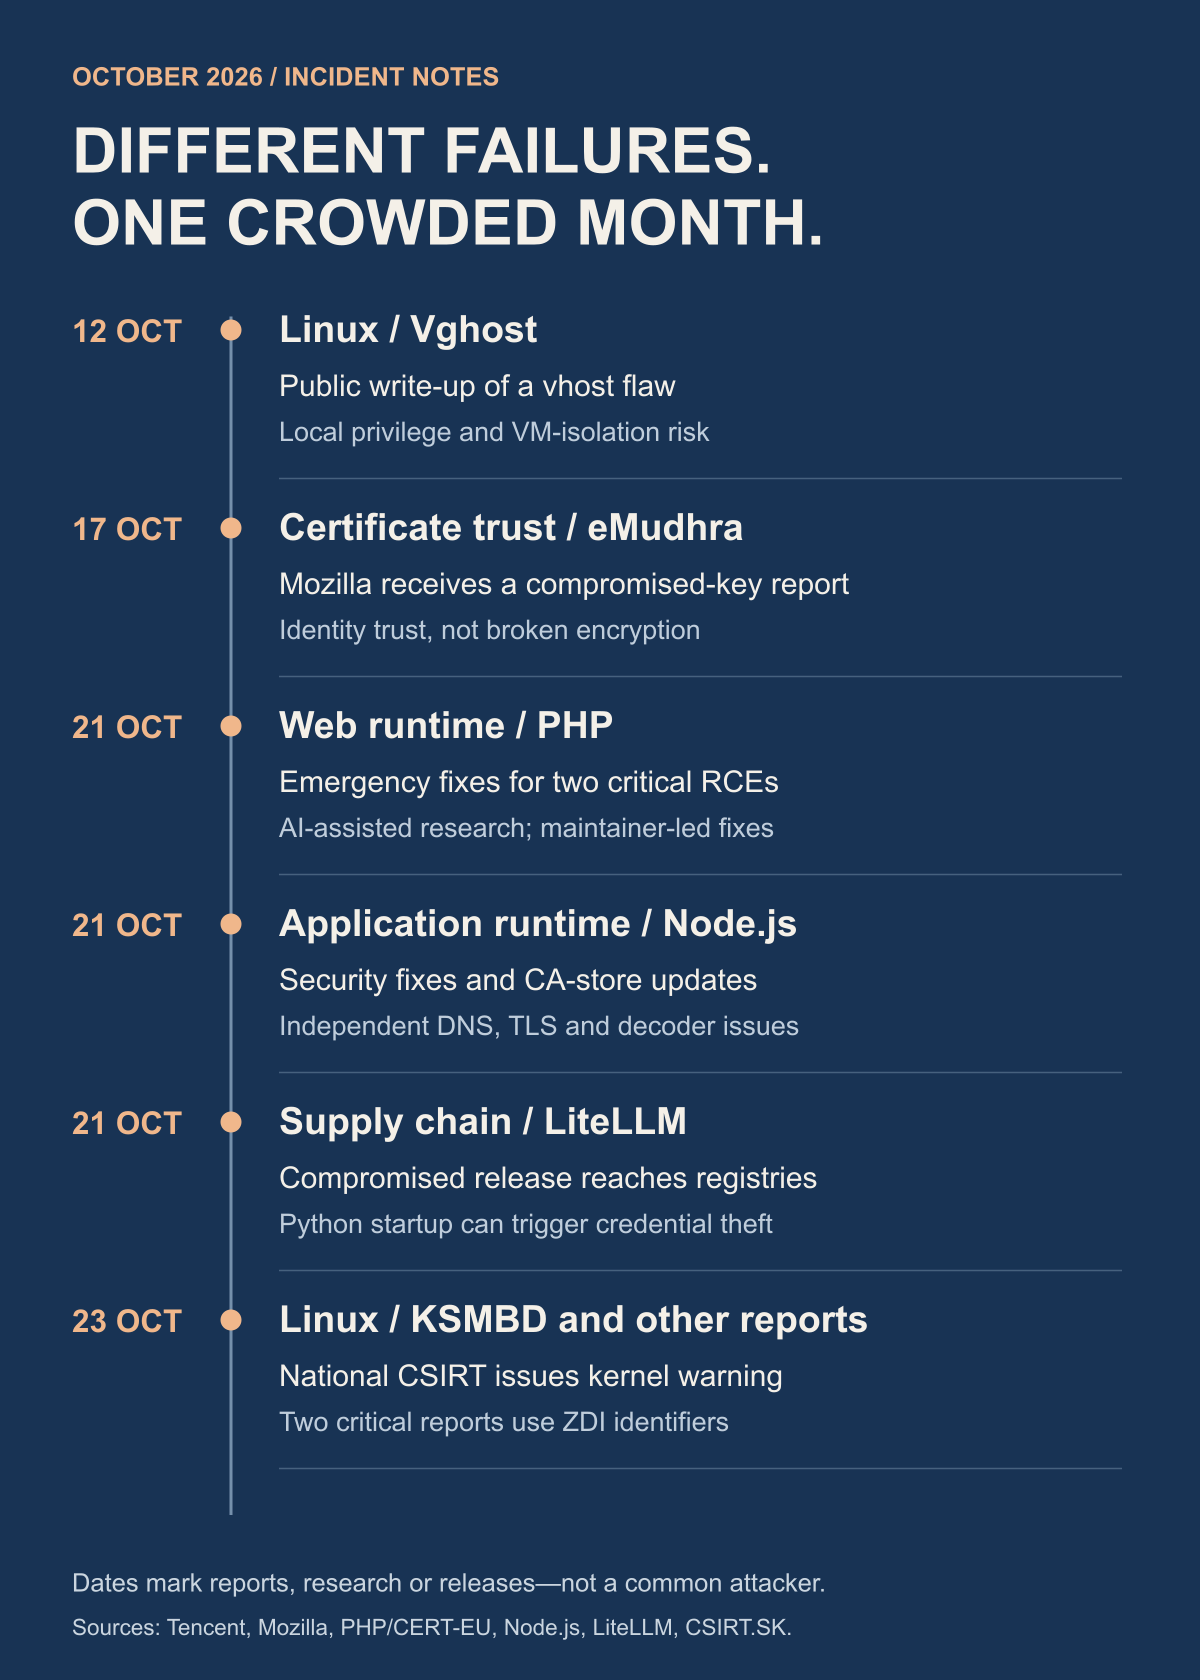
Am 21. Oktober veröffentlichte PHP Notfallkorrekturen für zwei Schwachstellen zur nicht authentifizierten Ausführung fremden Codes: CVE-2026-109618 und CVE-2026-109619, beide mit 9.2 bewertet. Bei einem geht es um Speicherbeschädigung während der Behandlung von Speichermangel, beim anderen um veralteten Anfragezustand. Das sind Laufzeitprobleme; allein Anwendungscode zu korrigieren reicht deshalb nicht. Der Sicherheitshinweis von CERT-EU beschreibt die betroffenen Entwicklungszweige und die Dringlichkeit.
Hier besteht ein dokumentierter KI-Bezug. OpenAI erklärt Calif setzte bei der Forschung GPT-5.6 Sol ein, während Wiz beide Schwachstellen unabhängig meldete. Die PHP-Verantwortlichen leiteten die Korrekturen und die Veröffentlichung. Die Anerkennung gebührt dieser koordinierten Zusammenarbeit von Menschen und Modell, keinem allein handelnden Chatbot.
Die ersten korrigierten Versionen sind PHP 8.5.12, 8.4.27, 8.3.36 und 8.2.35. Distributionsanbieter können Korrekturen unter anderen Paketversionen zurückportieren. Wichtig ist, dass CERT-EU seinen Hinweis am 23. Oktober um CVE-2026-115560, ein drittes RCE-Problem bei einer ungewöhnlichen Konfiguration. PHP hielt dieses Risiko für unwahrscheinlich und plante keine Notfallveröffentlichung; der Hinweis nennt eine vorläufige Gegenmaßnahme. Eine auf der Patch-Ankündigung vom Mittwoch eingefrorene Darstellung wäre bereits unvollständig. Die offiziellen PHP-Veröffentlichungen prüfen und die aktuellen Empfehlungen des Anbieters.
Die Linux-Geschichte ist größer als eine beängstigende Schlagzeile
Die neuesten kritischen Kernel-Meldungen verdienen Aufmerksamkeit. Die slowakische CSIRT warnte am 23. Oktober vor öffentlich zugänglichen Schwachstellenberichten, darunter zwei mit 9.0 bewertete Probleme im KSMBD-Dateiserver: ZDI-CAN-33549 und ZDI-CAN-33774. Ihre Voraussetzungen unterscheiden sich: Bei einem geht es um SMB Direct/RDMA, beim anderen um die Protokollverteilung mit einem an Freigabezugriff gebundenen Schreibpfad. Die Gefährdung hängt vom tatsächlich verwendeten Dienst und dessen Konfiguration ab. ZDI-eigene Bestandsliste bestätigt die Kennungen und Bewertungen.
Zum Zeitpunkt der Veröffentlichung des Hinweises verfügten diese beiden Meldungen nicht über CVE-Kennungen. Diese Unterscheidung zählt. Ein kritisches Problem wird während des Wartens auf eine CVE nicht harmlos, und eine kritische Bewertung belegt nicht, dass jeder Linux-Rechner betroffen ist. Administratoren sollten den Zugang zu betroffenen Diensten einschränken und den tatsächlichen Korrekturstatus ihres Distributors verfolgen.
Außerdem gibt es eine kritische zugewiesene CVE in der jüngsten Linux-Diskussion: CVE-2025-39682, eine Schwachstelle im TLS-Empfangspfad des Kernels. NVD nennt eine Bewertung von 9.8 und einen CISA-Verweis auf bekannte Ausnutzung. Sie wurde ursprünglich im September 2025 veröffentlicht und nicht erst diesen Oktober entdeckt. Red Hat bewertet seine Produkte anders, was zeigt, weshalb eine allgemeine Bewertung und die praktische Gefährdungsanalyse eines Anbieters voneinander abweichen können.
Das ist nur ein Teil des relevanten Linux-Bildes:
Copy Fail — CVE-2026-31431
KI-gestützte Entdeckung einer Kernel-Page-Cache-Schwachstelle, öffentlich offengelegt am 29. April. Sie ermöglicht lokale Rechteausweitung auf betroffenen Kerneln. Ein entfernter Angreifer braucht weiterhin einen ersten Weg zur lokalen Codeausführung. Offenlegung durch Forschende.
Dirty Frag / Fragnesia — CVE-2026-43284, CVE-2026-43500, CVE-2026-46300
Verwandte Page-Cache-Rechteausweitungen, die im Mai offengelegt wurden. Netzwerkkomponenten und Konfiguration beeinflussen die Erreichbarkeit; Microsofts Untersuchung trennt beobachtete Aktivität von unbestätigter Ausnutzung einzelner Varianten. Microsoft-Untersuchung.
CrackArmor
Neun AppArmor-Schwachstellen, abgebildet durch elf CVE-Kennungen auf Patch-Ebene. Ubuntu dokumentiert Voraussetzungen für lokale Benutzer und unterschiedliche Auswirkungen je Version, darunter Richtlinienumgehung und Rechteausweitung. Ubuntus vollständige Matrix.
Das Netzwerkquartett — DirtyAH6, TUNderflow, PPPoEject, DiagSpill
CVE-2026-80844, CVE-2026-81000, CVE-2026-68121 und CVE-2026-74469. Die Berichterstattung vom September beschreibt Wege zu lokalen Root-Rechten mit unterschiedlichen Voraussetzungen bei Namensräumen, Capabilities und Modulen. Red-Hat-Bulletin.
Vghost — CVE-2026-74580
Eine vhost-Schwachstelle, die lokale Rechteausweitung ermöglichen kann, mit einem VM-Ausbruchsrisiko bei bestimmten Konfigurationen. Tencents Sicherheitshinweis sagt ausdrücklich, dass die geprüfte CVM-Umgebung dem VM-Ausbruchspfad nicht ausgesetzt war. Tencent-Sicherheitshinweis.
Andere Kernel-Pfade — CVE-2026-53266, CVE-2025-39964
Beim ersten geht es um ebtables SNAT unter bestimmten Bridge-Regeln, beim zweiten um gleichzeitige AF_ALG-Schreibvorgänge. Voraussetzungen und Folgen unterscheiden sich. SNAT-Bewertung; AF_ALG-Bewertung.
Die praktische Lehre ist die Unterscheidung zwischen Fernzugang aus den Vorgängen nach dem Zugang. Eine lokale Root-Schwachstelle kann auf einem gemeinsam genutzten Server, Build-Runner oder Agentenhost verheerend sein, auch wenn sie keinem beliebigen Internetbesucher die Anmeldung ermöglicht. Eine Anwendungslücke oder ein gestohlenes Konto kann den ersten Zugang liefern. Wer jede Kernel-Schlagzeile als universelle Fernübernahme behandelt, verdeckt, welche Systeme zuerst Aufmerksamkeit brauchen.
Das Vorhängeschloss kann versagen, ohne dass die Verschlüsselung bricht
Der Zertifikatsvorfall ist eine andere Art von Versagen. Mozilla berichtet, am 17. Oktober eine Meldung erhalten zu haben, dass private Schlüssel für acht eMudhra-Zwischenzertifikate kompromittiert worden seien. Ein Angreifer, der eine Verbindung abfangen kann, könnte mit betrügerisch ausgestellten Zertifikaten möglicherweise eine Website imitieren. Mozilla sperrte die betroffenen Zertifikate noch am selben Abend über OneCRL und aktualisierte später Firefox und seine Trust-Store-Komponenten. Seine Reaktion dokumentiert außerdem eine nachfolgende Android-Korrektur.
Der Signaturschlüssel einer Zertifizierungsstelle verleiht die Befugnis, für Identitäten zu bürgen. Seine Kompromittierung greift diese Vertrauensentscheidung an. Sie bedeutet nicht, dass jemand die TLS-Verschlüsselung mathematisch gebrochen hat. Mozillas Darstellung belegt auch nicht, dass ein LLM die Kompromittierung verursachte.
Auch OpenSSL-Probleme gehören in dieses Bild, dürfen aber nicht mit dem CA-Vorfall verwechselt werden. Die Sicherheitshinweise vom September umfassen X.509-Erweiterungsverarbeitung, Ressourcenerschöpfung bei der Zertifikatsverarbeitung, QUIC und weitere Fehler in Kryptografiebibliotheken. Der OpenSSL-Index der Sicherheitshinweise unterscheidet betroffene Versionen und Schweregrade. Ein bösartiges Zertifikat kann einen Softwarefehler auslösen, selbst wenn diesem Zertifikat niemals vertraut werden sollte.
Die Node.js-Sicherheitsveröffentlichung vom 21. Oktober führt diese Schichten zusammen: Sie aktualisiert das gebündelte CA-Material für eMudhra und behebt unabhängige Probleme bei DNS, TLS-Hostnamenprüfung und der Laufzeit. Eine Schwachstelle im Brotli-Decoder, CVE-2026-111497, könnte Speicherbeschädigung und die Ausführung fremden Codes ermöglichen, wenn eine Anwendung vom Angreifer gelieferte komprimierte Daten verarbeitet; das Projekt nennt Forschende von OpenAI Codex Security als Entdecker. Nodes Sicherheitshinweis stuft seine schwerwiegendsten Probleme als High ein. Die veröffentlichten korrigierten Versionen sind 26.12.1, 24.22.1 und 22.23.4. Offizielles Veröffentlichungsarchiv.
API-Schlüssel werden zur strategischen Ressource
Die LiteLLM-Kompromittierung macht das Zugangsdatenproblem besonders greifbar. Das bösartige Paket 1.107.0 erreichte am 21. Oktober öffentliche Registries. Microsoft fand Python-Start-Hooks, die einen Zugangsdaten-Sammler aktivieren konnten, ohne dass eine Anwendung LiteLLM ausdrücklich importierte. Modellanbieter-Schlüssel gehörten zu einem viel breiteren Zielspektrum mit Entwickler- und Cloud-Zugangsdaten. Ein einzelnes Paket zu entfernen ist deshalb nicht gleichbedeutend mit der Wiederherstellung des Vertrauens in den Rechner. Microsofts Untersuchung erläutert die Auswirkungen auf Gefährdung und Wiederherstellung.
Die spätere Untersuchung von LiteLLM selbst führt die vorgelagerte Kompromittierung auf einen offengelegten, nicht widerrufenen Hauptschlüssel zurück. Danach folgten Zugriff auf mächtige Entwicklerzugangsdaten und den Veröffentlichungsprozess. Sie berichtet auch von einem Fokus auf Inferenz-API-Tokens vorgelagerter Anbieter. Die maßgebliche Vorfalldarstellung korrigiert einige frühe Annahmen. Das erinnert daran, der Untersuchung zu folgen, statt die erste viral verbreitete Erklärung festzuschreiben.
KI-Zugangsdaten können inzwischen mehr kaufen als eine betrügerische Cloud-Rechnung. Sie ermöglichen Schlussfolgern, Programmierhilfe und einen Ort, an dem ein anderer Akteur seine Aktivitäten verbirgt. Wird der Zugang weiterverkauft, trägt womöglich der rechtmäßige Kontoinhaber Kosten und Sanktionsrisiken, während jemand anderes die Fähigkeiten nutzt. Wer einen bestimmten gestohlenen Schlüssel gekauft und wofür verwendet hat, muss weiterhin belegt werden.
Was die Belege über chinesische Labore aussagen
Es gibt eine dokumentierte Grundlage für die Sorge vor nicht autorisierter Destillation. In seinem Septemberbericht beschreibt Anthropic Kampagnen, die es Laboren mit Sitz in China zuschreibt, und erläutert, wie Proxy-Dienste mit betrügerischen Konten, gestohlenen Zahlungsdaten und gestohlenen API-Zugangsdaten Zugriff vermitteln können. Derselbe Bericht beschreibt bösartige KI-gestützte Operationen unterschiedlicher Akteure, keiner einzelnen nationalen Gruppe. Das sind Anthropics zugeschriebene Befunde, kein unabhängiges Urteil über alle angeblichen Beteiligten. Den Bedrohungsbericht lesen.
OpenAIs Offenlegung vom 30. September schreibt eine Kerngruppe einer Kampagne zur Extraktion von Schlussfolgerungen Personen mit Verbindungen zu Moonshot AI zu. Entscheidend ist die Aussage, dass die Kampagne weder Verschlüsselung brach noch eine Datenbank kompromittierte oder direkt auf gespeicherte Benutzergespräche zugriff. Ihr Mechanismus war die Manipulation von Modellinteraktionen. OpenAIs Darstellung sollte nicht als eine andere Art von Sicherheitsvorfall nacherzählt werden.
NSA, FBI und CISA warnten im September zudem gemeinsam vor Destillation im industriellen Maßstab durch KI-Unternehmen mit Sitz in China. Die Bekanntgabe des behördlichen Sicherheitshinweises belegt, dass es sich um eine ernsthafte, öffentlich dokumentierte Sorge handelt. Destillation selbst bleibt eine legitime Trainingsmethode; entscheidend sind Autorisierung, Zugang und die Beschaffung der Daten.
Meine Einschätzung: Gestohlene Zugangsdaten für Inferenz und nicht autorisierte Destillation sind ein glaubwürdiger Bestandteil der Bedrohungsökonomie. Die genannten Quellen belegen nicht, dass chinesische Labore die PHP-Fehler, die Kompromittierung des eMudhra-Schlüssels, die KSMBD-Offenlegungen oder den LiteLLM-Angriff organisiert haben. Um diese Ereignisse einer einzigen Kampagne zuzuordnen, bräuchte es Nachweise, die Akteure, Infrastruktur oder die Nutzung gestohlener Zugangsdaten verbinden. Gemeinsame Anreize sind ein Grund zur Untersuchung, kein Ersatz für Attribution.
Wenn die Gegenseite einen Schwarm einsetzen kann
Der wesentliche Wandel ist wirtschaftlich. Ein Modell kann Code untersuchen, Tests vorschlagen und bei der Untersuchung der Ergebnisse helfen. In einem Agenten mit Werkzeugzugriff kann es diesen Ablauf wiederholen. Mit vielen parallelen Agenten kann ein Betreiber mehrere Hypothesen zugleich untersuchen. Das macht nicht jeden Versuch richtig oder jedes Ziel verwundbar. Es senkt die Kosten dauerhafter Untersuchung.
Ein konkretes defensives Beispiel findet sich in OpenAIs Eindämmungsbericht vom 23. Oktober. Das Unternehmen beschreibt Agentenflotten, die eigens eingerichtete Kopien seiner Infrastruktur mit Zugriff auf Quellcode und Konfiguration, Überwachung und begrenzten Zielen testen. Es berichtet über VM-Ausbrüche und Isolationsprobleme sowie Arbeit an Kernel-Problemen wie CVE-2026-74753, CVE-2026-80521 und CVE-2026-80841. Diese kontrollierten Experimente beweisen nicht, dass ein unbeaufsichtigter öffentlicher Bot jeden Server kompromittieren kann. Sie zeigen, weshalb Verteidiger dauerhaftes maschinengestütztes Testen ernst nehmen.
Für kleine Betreiber verändert das den Nutzen davon, uninteressant zu sein. Unauffälligkeit schützt weniger, wenn die Prüfung eines weiteren Hosts kaum etwas kostet. Der Angreifer kann weitermachen, während das Team seiner eigentlichen Arbeit nachgeht. Die Verteidigung muss den Weg vom glaubwürdigen Hinweis zur überprüften Korrektur verkürzen, statt bloß mehr Warnungen zu erzeugen.
Nützliche defensive Agenten brauchen Grenzen
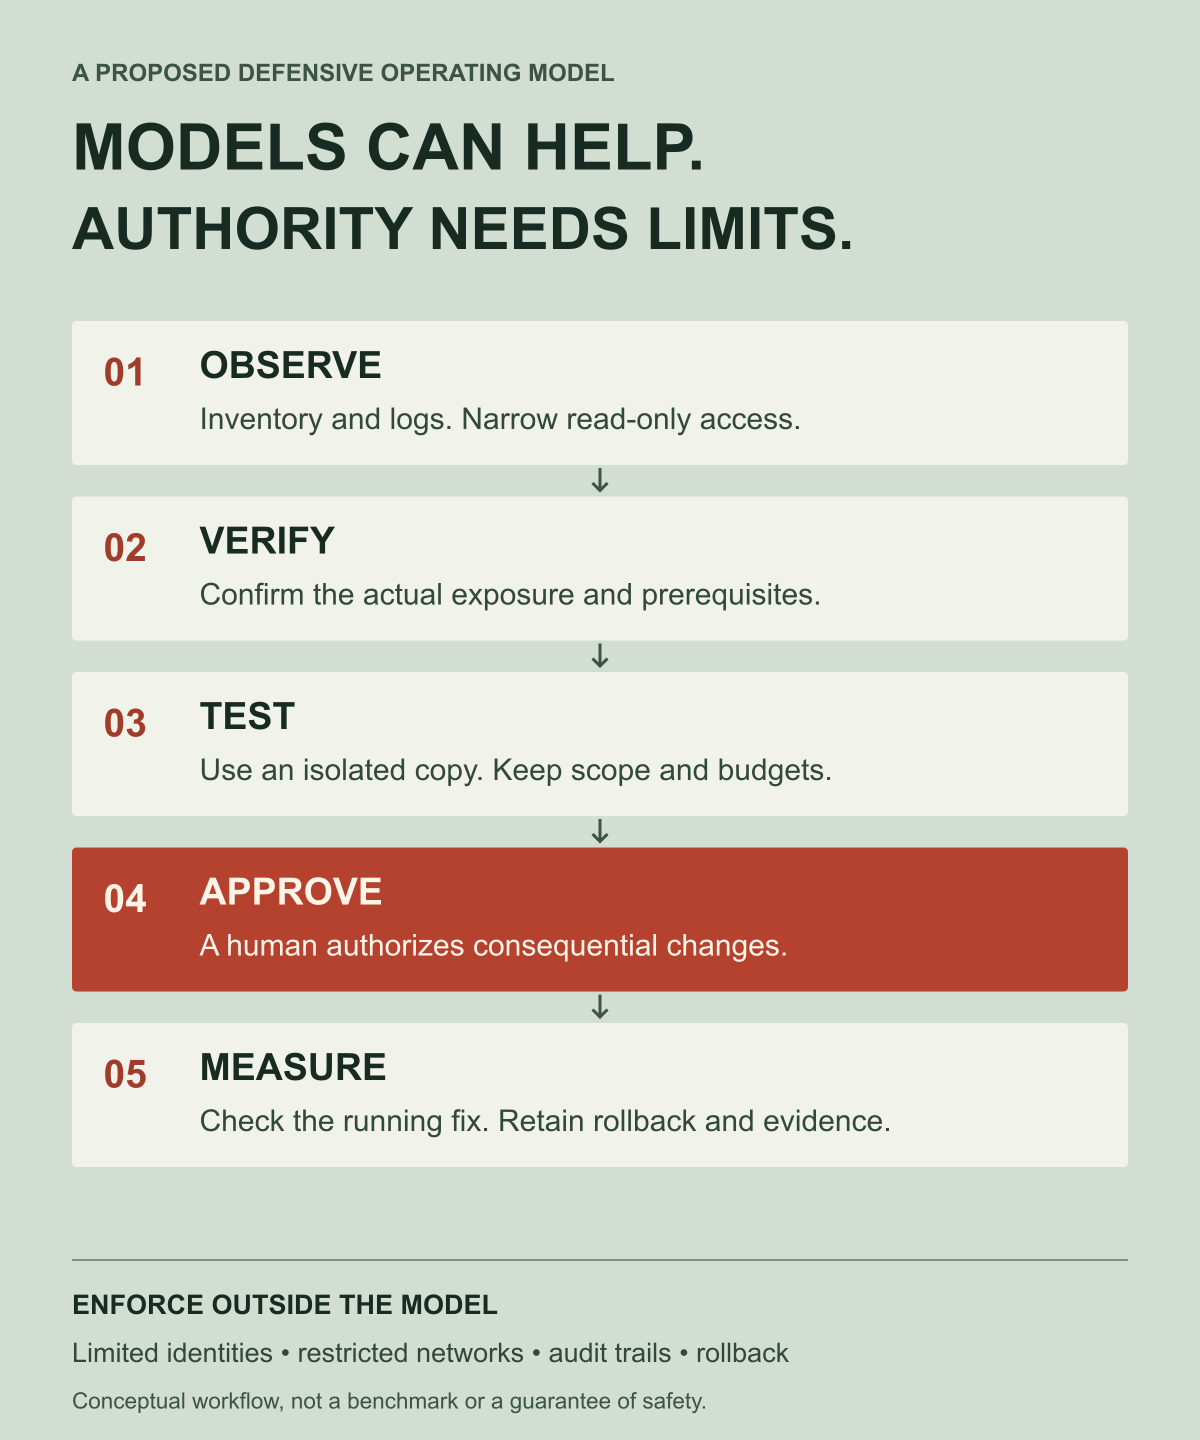
Meiner Ansicht nach ist der erste nützliche Sicherheitsagent ein sorgfältiger Ermittler. Er erfasst eingesetzte Software und erreichbare Dienste, verbindet Sicherheitshinweise mit der tatsächlichen Umgebung und liefert Belege, mit denen Verantwortliche handeln können. Eine zweite Aufgabe ist das Testen einer vorgeschlagenen Korrektur in einer Wegwerfumgebung. Keine von beiden benötigt uneingeschränkte Produktionszugangsdaten.
Die Einführungsreihenfolge sollte bewusst gewählt werden:
- Beobachten: Bestand, Versionen und Protokolle mit eng begrenztem Lesezugriff erfassen.
- Überprüfen: feststellen, ob der verwundbare Codepfad vorhanden und erreichbar ist. Eine Versionszeichenfolge allein kann eine zurückportierte Korrektur des Distributors übersehen.
- Testen: in einer kontrollierten Kopie reproduzieren und validieren, wobei Budgets und Umfang außerhalb des Modells durchgesetzt werden.
- Ändern: für folgenreiche Produktionsmaßnahmen eine Freigabe verlangen und anschließend schrittweise mit getesteter Rückfallmöglichkeit ausrollen.
- Messen: das laufende System, die aufbewahrten Nachweise, den Zustand der Dienste und die tatsächliche Verringerung der Angriffsfläche prüfen.
Protokolle, Tickets und Repository-Dateien können vom Angreifer kontrollierten Text enthalten. Ein Verteidiger, der diesen Text als Autorität behandelt, kann selbst zur Angriffsfläche werden. Begrenzte Identitäten, isolierte Werkzeuge, eingeschränkter Netzwerkzugriff und unabhängig durchgesetzte Handlungsregeln sind wichtig, selbst wenn das Modell sicher klingt. Schnelleres Denken macht weitreichende Berechtigungen nicht sicherer.
Das Labor verkauft die Fähigkeit. Danach verkauft es den Schutzschild.
Hier wird das Geschäftsmodell unangenehm. Dieselben Unternehmen, deren Fähigkeiten die Angriffskosten senken können, positionieren diese Fähigkeiten als unverzichtbare Verteidigungswerkzeuge. Kunden können am Ende laufend dafür bezahlen, ein Risiko zu bewältigen, das die Produktkategorie selbst beschleunigt.
Hinter dieser Sorge steht eine konkrete kommerzielle Struktur. Anthropics Glasswing-Ankündigung sagte bis zu 100 Millionen US-Dollar an Modellguthaben und 4 Millionen US-Dollar an Spenden für Open-Source-Sicherheitsorganisationen zu; sie beschrieb auch kostenpflichtige Nutzung nach der Unterstützung während der Vorschauphase. Im Oktober wechselten bestehende Glasswing-Mitglieder in das erweiterte Cyber Verification Program. Die Programmseite ist sowohl eine ernsthafte Verteidigungsinitiative als auch Teil eines Marktes für fortgeschrittene Sicherheitsfähigkeiten.
Von einer KI-Sicherheitssteuer zu sprechen erfordert nicht die Behauptung, die Labore hätten jahrzehntealte Fehler erfunden oder absichtlich Angriffe organisiert. Es benennt einen Anreiz: Mit der Verbreitung leistungsfähiger Modelle kann die Nachfrage nach modellgestützter Verteidigung wachsen, und die Anbieter dieser Fähigkeiten können die Ausgaben abschöpfen. Die Öffentlichkeit sollte Zugangsbeschränkungen, Preise, Sicherheitsbehauptungen und Nachweise für die Wirksamkeit des versprochenen Schutzes prüfen können.
Es gibt ein berechtigtes Gegenargument. Defensive Forschung kann einen vorübergehenden Entdeckungsvorsprung in dauerhafte öffentliche Patches verwandeln, auch in Korrekturen für Menschen ohne Modellabonnement. Dieser Nutzen ist real. Er spricht dafür, die Branche an bereitgestellten Korrekturen und sichereren Voreinstellungen zu messen, statt Angst oder Optimismus allein als Beleg gelten zu lassen.
Der Engpass ist alles nach der Entdeckung
Modelle können Befunde schneller erzeugen, als Verantwortliche sie unbedingt prüfen können. Anthropics Offenlegungsdashboard meldete mit ausdrücklich datiertem Stand vom 2. Oktober 6.157 offengelegte Befunde in 591 Projekten und 516 bekannte vorgelagerte Patches. Das Dashboard warnt vor unterschiedlichen Validierungsstufen der Zahlen und davor, aus der Patch-Zahl auf die Verbreitung installierter Korrekturen zu schließen. Seine Methodik zählt ebenso wie die Schlagzeilenzahl.
Die Lehre ist nicht, diese Zahlen zu subtrahieren und Tausende ausnutzbare, ungepatchte Server auszurufen. Entdeckung, Bestätigung, vorgelagerte Korrektur und Bereitstellung sind getrennte Aufgaben. Wer nur die erste finanziert, verlagert Arbeit auf die Verantwortlichen für den Rest.
Ich bevorzuge einen Sicherheitsmarkt, der Ergebnisse bezahlt: reproduzierbare Berichte, Kapazitäten für Verantwortliche, öffentliche Korrekturen, brauchbare Aktualisierungspfade und unabhängig getestete Eindämmung. Kunden sollten ihre Nachweise zu einem anderen Anbieter mitnehmen können. Kleine Verantwortliche sollten keinen KI-Unternehmensvertrag brauchen, um eine weitverbreitete Bibliothek sicher zu halten.
Die nächste Sicherheitsära wird vermutlich Modelle umfassen, die andere Modelle beobachten, und Agenten, die Verteidigungen gegen andere Agenten testen. Dauerhafte Verteidigung darf aber nicht vollständig davon abhängen, wer sich den größten Schwarm leisten kann. Sie braucht auch weniger exponierte Infrastruktur, weniger mächtige Zugangsdaten, sicherer versagende Software und Menschen mit der Befugnis, auf gute Belege zu reagieren.
Die Frage ist nicht mehr nur, ob KI die Lücke findet. Entscheidend ist, wer die Korrektur erhält, wer die Verteidigung kontrolliert und wer die Rechnung bekommt.
Redaktioneller Hinweis: Dieser Artikel trennt verifizierte Vorfallberichte, Anbieterzuschreibungen und die Analyse des Autors. Die konzeptionellen Illustrationen wurden mit ChatGPT erzeugt; die Infografiken wurden anhand der verlinkten Unterlagen erstellt. Für diesen Artikel wurde kein Exploit gegen ein laufendes System ausgeführt. Vor Maßnahmen den aktuellen Sicherheitshinweis für das genaue Produkt und die genaue Konfiguration prüfen.