Laboratoriene som gjør programvare enklere å bryte, selger også verktøyene som skal forsvare den. Denne månedens sikkerhetshendelser viser hvorfor forretningsmodellen bør granskes — og hvorfor svaret ikke kan være enda en svart boks med en større API-regning.
Et klønete salgsargument er i ferd med å ta form i KI-bransjen: Modellene blir kraftige nok til å finne sprekkene i infrastrukturen din, så du bør nok bruke modellene til å hjelpe med å tette dem.
Jeg kaller regningen dette fører til for KI-sikkerhetsskatt. Det omfatter mer enn et abonnement. Det er ingeniørtid, inferensutgifter, nødrettinger og driftsmessig kompleksitet som kreves for å holde tritt med maskiner som kan undersøke programvare kontinuerlig. Små team betaler med netter og helger. Store organisasjoner betaler med enda et lag sikkerhetsinfrastruktur.
Oktoberhendelsene gjør denne muligheten konkret. De gjør det også lett å fortelle en altfor ryddig historie: én global bølge av KI-angrep, én utenlandsk skyldig og én leverandør med kuren. Bevisene støtter et mer interessant argument. Gamle feil, kompromittert tillit, stjålne legitimasjoner og stadig mer kapable agenter påvirker hverandre. De har ikke alle samme årsak.
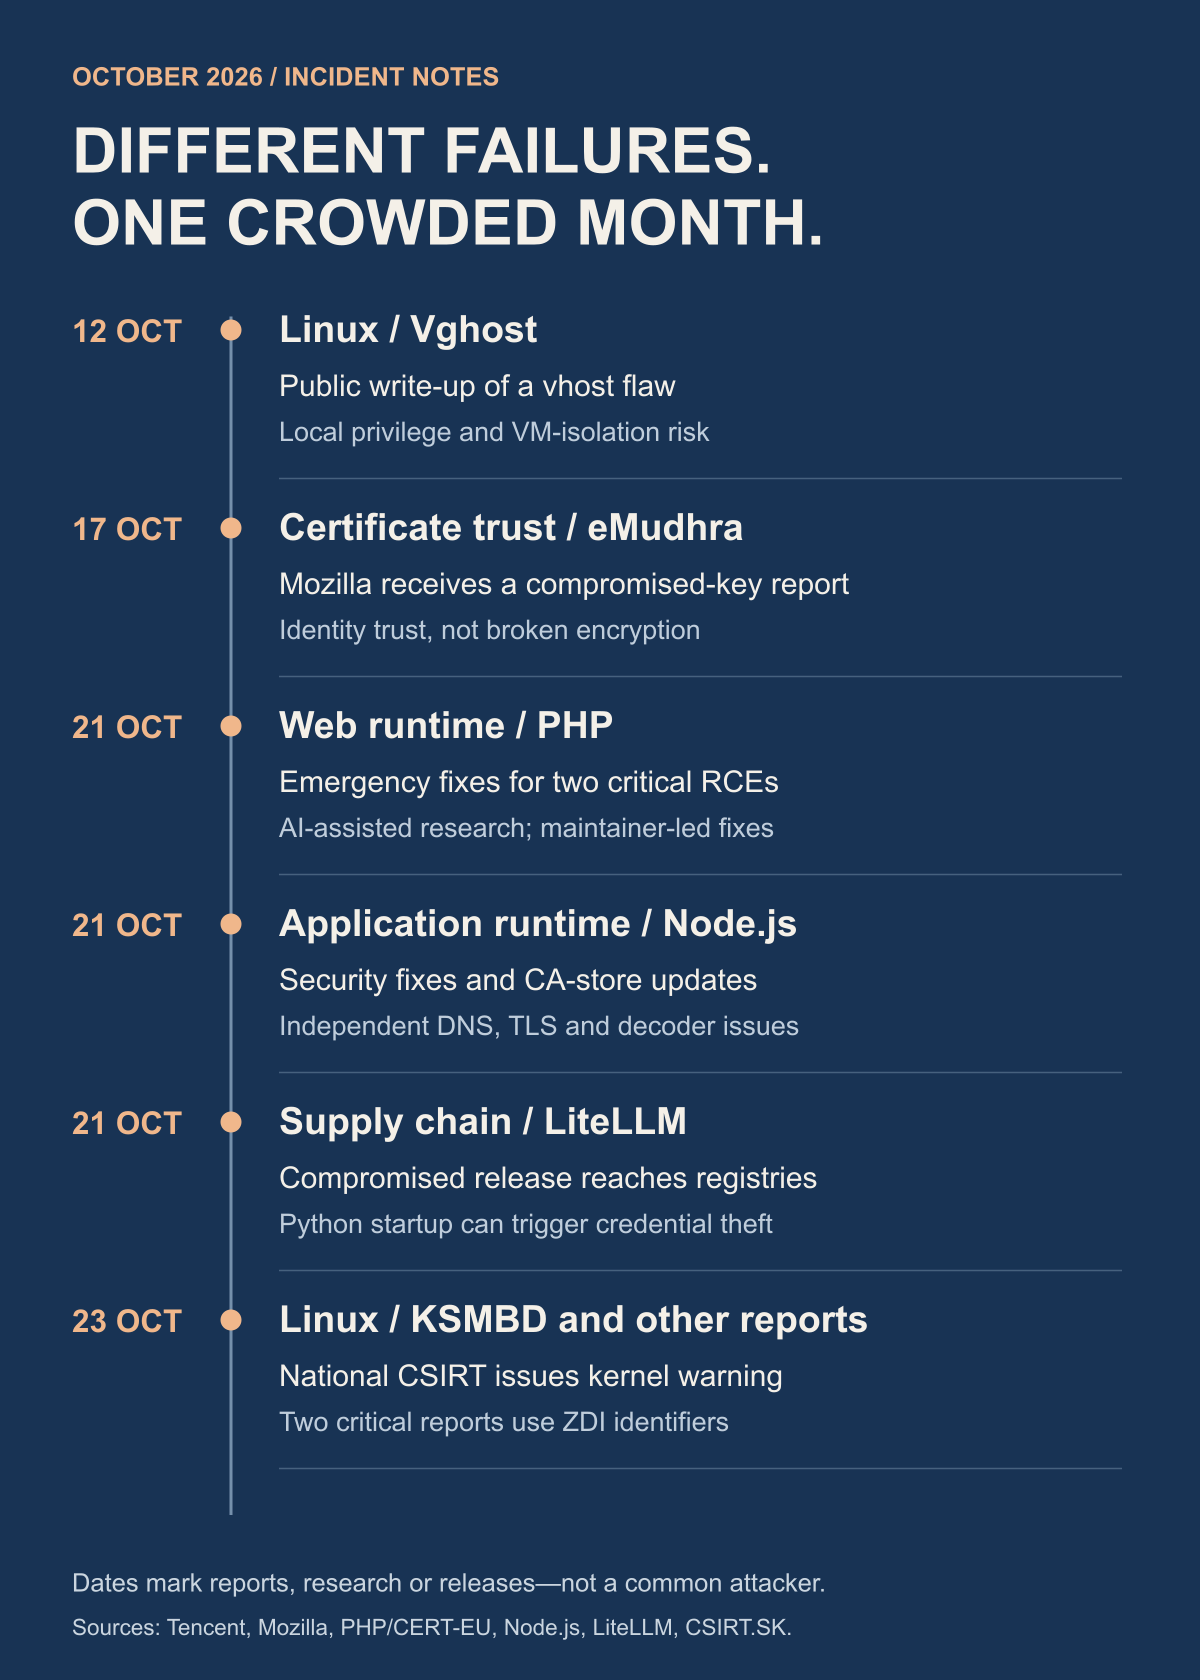
Rapportering kontrollert 24. oktober 2026. Dette er en analyse av de store hendelsene og Linux-sårbarhetsfamiliene som er relevante for denne bølgen, ikke en uttømmende katalog over alle Linux-CVE-er. Datoene nedenfor skiller mellom første offentliggjøring og fornyet oppmerksomhet. Hendelsesdetaljer og leverandørenes rettelsesstatus kan endres.
En travel måned, flere ulike feil
21. oktober ga PHP ut nødrettelser for to feil som muliggjorde ekstern kjøring av kode uten autentisering: CVE-2026-109618 og CVE-2026-109619, begge vurdert til 9,2. Den ene gjelder minnekorrupsjon ved håndtering av lite minne; den andre gjelder foreldet forespørselstilstand. Dette er problemer i kjøremiljøet, så det er ikke nok å bare rette applikasjonskoden. CERT-EUs veiledning angir berørte grener og hvor mye det haster.
Det finnes en dokumentert KI-kobling her. OpenAI sier Calif brukte GPT-5.6 Sol i forskningen, mens Wiz uavhengig rapporterte begge feilene. PHP-vedlikeholderne ledet arbeidet med rettelser og utgivelse. Anerkjennelsen tilhører det koordinerte arbeidet mellom mennesker og modellen, ikke en chatbot som handlet alene.
De første rettede utgivelsene er PHP 8.5.12, 8.4.27, 8.3.36 og 8.2.35. Distribusjonsleverandører kan bakportere rettelser under andre pakkeversjoner. Det er verdt å merke seg at CERT-EU oppdaterte veiledningen 23. oktober for å legge til CVE-2026-115560, et tredje RCE-problem som gjelder en uvanlig konfigurasjon. PHP vurderte risikoen som lite sannsynlig og planla ingen nødutgivelse; veiledningen beskriver et midlertidig tiltak. En artikkel som stoppet ved onsdagens kunngjøring av rettelser, ville allerede vært ufullstendig. Sjekk de offisielle PHP-utgivelsene og gjeldende leverandørveiledning.
Linux-historien er større enn én skremmende overskrift
De nyeste rapportene om kritiske kjernefeil fortjener oppmerksomhet. Slovakias CSIRT advarte 23. oktober om offentlig eksponerte sårbarhetsrapporter, inkludert to KSMBD-filserverproblemer vurdert til 9,0: ZDI-CAN-33549 og ZDI-CAN-33774. Forutsetningene deres er ulike: Den ene gjelder SMB Direct/RDMA; den andre gjelder protokolldispatch og en skrivebane knyttet til tilgang til delte ressurser. Eksponering avhenger av tjenesten og konfigurasjonen som faktisk er i bruk. ZDIs egen oversikt bekrefter identifikatorene og vurderingene.
Da veiledningen ble publisert, oppga ikke de to rapportene ikke har CVE-identifikatorer. Dette skillet betyr noe. Et kritisk problem blir ikke ufarlig mens det venter på en CVE, og en kritisk vurdering viser ikke at alle Linux-maskiner er eksponert. Administratorer bør begrense tilgangen til berørte tjenester og følge med på distributørens faktiske status for rettelser.
Det finnes også en kritisk tildelt CVE i den nylige Linux-diskusjonen: CVE-2025-39682, en feil i kjernens TLS-mottaksbane. NVD oppgir en vurdering på 9,8 og en CISA-referanse til kjent utnyttelse. Den ble opprinnelig publisert i september 2025, og ikke først oppdaget denne oktober. Red Hat vurderer produktene sine annerledes, noe som viser hvorfor en universell vurdering og leverandørens praktiske vurdering av eksponering kan være ulike.
Dette er bare en del av det relevante Linux-bildet:
Copy Fail — CVE-2026-31431
KI-assistert oppdagelse av en feil i kjernens sidebuffer, offentliggjort 29. april. Den muliggjør lokal rettighetseskalering på berørte kjerner. En ekstern angriper trenger fortsatt en innledende vei til lokal kodekjøring. Forskerens offentliggjøring.
Dirty Frag / Fragnesia — CVE-2026-43284, CVE-2026-43500, CVE-2026-46300
Beslektede problemer med rettighetseskalering i sidebufferen ble offentliggjort i mai. Nettverkskomponenter og konfigurasjon påvirker tilgjengeligheten; Microsofts etterforskning skiller mellom observert aktivitet og ubekreftet utnyttelse av enkelte varianter. Microsofts etterforskning.
CrackArmor
Ni AppArmor-sårbarheter representert av elleve CVE-identifikatorer på rettelsesnivå. Ubuntu dokumenterer forutsetninger for lokale brukere og ulik påvirkning mellom utgivelser, inkludert omgåelse av policy og rettighetseskalering. Ubuntus fullstendige matrise.
Nettverkskvartetten — DirtyAH6, TUNderflow, PPPoEject, DiagSpill
CVE-2026-80844, CVE-2026-81000, CVE-2026-68121 og CVE-2026-74469. Septemberrapportering beskriver veier til lokal root med ulike krav til navnerom, kapabiliteter og moduler. Red Hat-bulletin.
Vghost — CVE-2026-74580
En vhost-feil kan muliggjøre lokal rettighetseskalering, med risiko for VM-flukt i bestemte konfigurasjoner. Tencents veiledning sier uttrykkelig at det undersøkte CVM-miljøet ikke var eksponert for VM-fluktbanen. Tencent-veiledning.
Andre baner i kjernen — CVE-2026-53266, CVE-2025-39964
Den første gjelder ebtables SNAT under bestemte broregler; den andre gjelder samtidige AF_ALG-skrivinger. Forutsetningene og konsekvensene er ulike. SNAT-vurdering; AF_ALG-vurdering.
Den praktiske lærdommen er å skille mellom ekstern inngang fra hva som skjer etter innbruddet. En sårbarhet som gir lokal root-tilgang kan være ødeleggende på en delt server, build-runner eller agentvert, selv om den ikke lar en vilkårlig internettbesøkende logge inn. En applikasjonsfeil eller en stjålet konto kan gi det første fotfestet. Å behandle hver overskrift om kjernen som en universell ekstern overtakelse tilslører systemene som faktisk bør prioriteres først.
Hengelåsen kan svikte uten at krypteringen brytes
Sertifikathendelsen er en annen type feil. Mozilla sier de mottok en rapport 17. oktober om at de private nøklene til åtte eMudhra-mellomsertifikater var kompromittert. En angriper som kan avlytte en forbindelse, kan potensielt bruke svindelaktig utstedte sertifikater til å utgi seg for et nettsted. Mozilla blokkerte de berørte sertifikatene gjennom OneCRL samme kveld og oppdaterte senere Firefox og komponentene for tillitslageret. Svaret omtaler også en senere Android-rettelse.
En sertifiseringsinstans' signeringsnøkkel gir myndighet til å gå god for identiteter. Å kompromittere den angriper denne tillitsbeslutningen. Det betyr ikke at noen matematisk har brutt TLS-kryptering. Mozillas redegjørelse fastslår heller ikke at en LLM forårsaket kompromitteringen.
OpenSSL-problemer hører også med her, men må ikke forveksles med CA-hendelsen. Septemberveiledningen omfatter håndtering av X.509-utvidelser, ressursutmatting ved sertifikatbehandling, QUIC og andre feil i kryptografibiblioteket. OpenSSL-veiledningsindeks skiller mellom berørte versjoner og alvorlighetsgrad. Et ondsinnet sertifikat kan avdekke en programvarefeil selv om sertifikatet aldri burde vært klarert.
Node.js' sikkerhetsutgivelse 21. oktober samler disse lagene: Den oppdaterer det medfølgende CA-materialet for eMudhra og retter uavhengige problemer med DNS, kontroll av TLS-vertsnavn og andre kjøretidsproblemer. En feil i Brotli-dekoderen, CVE-2026-111497, kan gjøre minnekorrupsjon og ekstern kjøring av kode mulig når et program behandler komprimerte data levert av en angriper; prosjektet krediterer forskere fra OpenAI Codex Security. Nodes sikkerhetsmelding vurderer sine mest alvorlige problemer som High. De publiserte rettede utgivelsene er 26.12.1, 24.22.1 og 22.23.4. Offisielt utgivelsesarkiv.
API-nøkler blir en strategisk ressurs
LiteLLM-kompromitteringen gjør legitimasjonsproblemet særlig konkret. Den ondsinnede 1.107.0-pakken nådde offentlige registre 21. oktober. Microsoft fant Python-oppstartskroker som kunne aktivere en legitimasjonssamler uten at et program uttrykkelig importerte LiteLLM. Modellleverandørnøkler var del av et mye bredere sett mål som også omfattet utvikler- og skylegitimasjon. Å fjerne én pakke er derfor ikke det samme som å gjenopprette tilliten til maskinen. Microsofts etterforskning forklarer konsekvensene for eksponering og gjenoppretting.
LiteLLMs senere egen etterforskning sporer den opprinnelige upstream-kompromitteringen til en eksponert hovednøkkel som ikke ble tilbakekalt, etterfulgt av tilgang til kraftige utviklerlegitimasjoner og utgivelsesprosessen. Den omtaler også et fokus på å skaffe upstream-API-tokener for inferens. Den kanoniske hendelsesbeskrivelsen korrigerer noen tidlige antakelser. Det minner oss om å følge undersøkelsen, ikke holde fast ved den første forklaringen som gikk viralt.
En KI-legitimasjon kan nå kjøpe mer enn en falsk skyregning. Den kan gi resonnering, kodehjelp og et sted å skjule en annen aktørs aktivitet. Hvis tilgangen videreselges, kan den rettmessige kontoeieren sitte igjen med kostnader og risiko for håndheving, mens noen andre bruker kapasiteten. Det krever fortsatt bevis å fastslå hvem som kjøpte en bestemt stjålet nøkkel, og hva den ble brukt til.
Hva bevisene sier om kinesiske laboratorier
Det finnes et dokumentert grunnlag for bekymring rundt uautorisert destillasjon. I sin septemberrapport beskriver Anthropic kampanjer som selskapet knytter til Kina-baserte laboratorier, og forklarer hvordan proxy-tjenester kan bruke falske kontoer, stjålne betalingsopplysninger og stjålne API-legitimasjoner for å gi tilgang. Den samme rapporten beskriver ondsinnede KI-assisterte operasjoner utført av flere typer aktører, ikke én nasjonal gruppe. Dette er Anthropics attribuerte funn, ikke en uavhengig dom over hver påståtte deltaker. Les trusselrapporten.
OpenAIs avsløring 30. september knytter en sentral klynge i en kampanje for å hente ut resonneringsevner til personer med tilknytning til Moonshot AI. Det er avgjørende at rapporten sier at kampanjen ikke brøt kryptering, kompromitterte en database eller fikk direkte tilgang til lagrede brukersamtaler. Metoden var manipulering av modellinteraksjoner. OpenAIs redegjørelse bør ikke gjenfortelles som en annen type datainnbrudd.
NSA, FBI og CISA utstedte også en felles advarsel i september om destillasjon i industriell skala hos Kina-baserte KI-selskaper. Kunngjøringen av myndighetenes veiledning fastslår at dette er en alvorlig, offentlig dokumentert bekymring. Destillasjon er fortsatt en legitim treningsteknikk; spørsmålene gjelder autorisasjon, tilgang og hvordan dataene ble hentet inn.
Min vurdering: stjålne legitimasjonsopplysninger for inferens og uautorisert destillasjon er en troverdig del av trusseløkonomien. Kildene ovenfor fastslår ikke at kinesiske laboratorier organiserte PHP-feilene, kompromitteringen av eMudhra-nøkkelen, KSMBD-avsløringene eller LiteLLM-angrepet. Å knytte disse hendelsene sammen til én kampanje ville kreve bevis som kobler sammen aktører, infrastruktur eller bruk av stjålne legitimasjonsopplysninger. Felles insentiver er en grunn til å undersøke, ikke en erstatning for attribusjon.
Når den andre siden kan kjøre en sverm
Den viktige endringen er økonomisk. En modell kan inspisere kode, foreslå tester og bidra til å undersøke resultatet. Plassert i en agent som bruker verktøy kan den gjenta denne syklusen. Med mange agenter parallelt kan en operatør utforske flere hypoteser samtidig. Det betyr ikke at alle forsøk lykkes eller at alle mål er sårbare. Det betyr at vedvarende undersøkelser blir billigere.
Et konkret defensivt eksempel finnes i OpenAIs rapport om inneslutning 23. oktober. Selskapet beskriver flåter av agenter som tester spesialbygde kopier av infrastrukturen, med tilgang til kildekode og konfigurasjon, overvåking og avgrensede mål. Det rapporterer funn om VM-escape og isolasjon, samt arbeid med kjerneproblemer, inkludert CVE-2026-74753, CVE-2026-80521 og CVE-2026-80841. Disse kontrollerte eksperimentene er ikke bevis for at en offentlig bot uten tilsyn kan bryte seg inn på en hvilken som helst server. De viser hvorfor forsvarere tar vedvarende maskinassistert testing på alvor.
For en liten operatør endrer dette verdien av å være uinteressant. Uklarhet beskytter mindre når det koster lite å sjekke en annen vert. Angriperen kan fortsette å prøve mens teamet ditt gjør den egentlige jobben. Forsvaret bør forkorte veien fra et troverdig signal til en bekreftet rettelse, i stedet for bare å lage flere varsler.
Nyttige defensive agenter trenger grenser
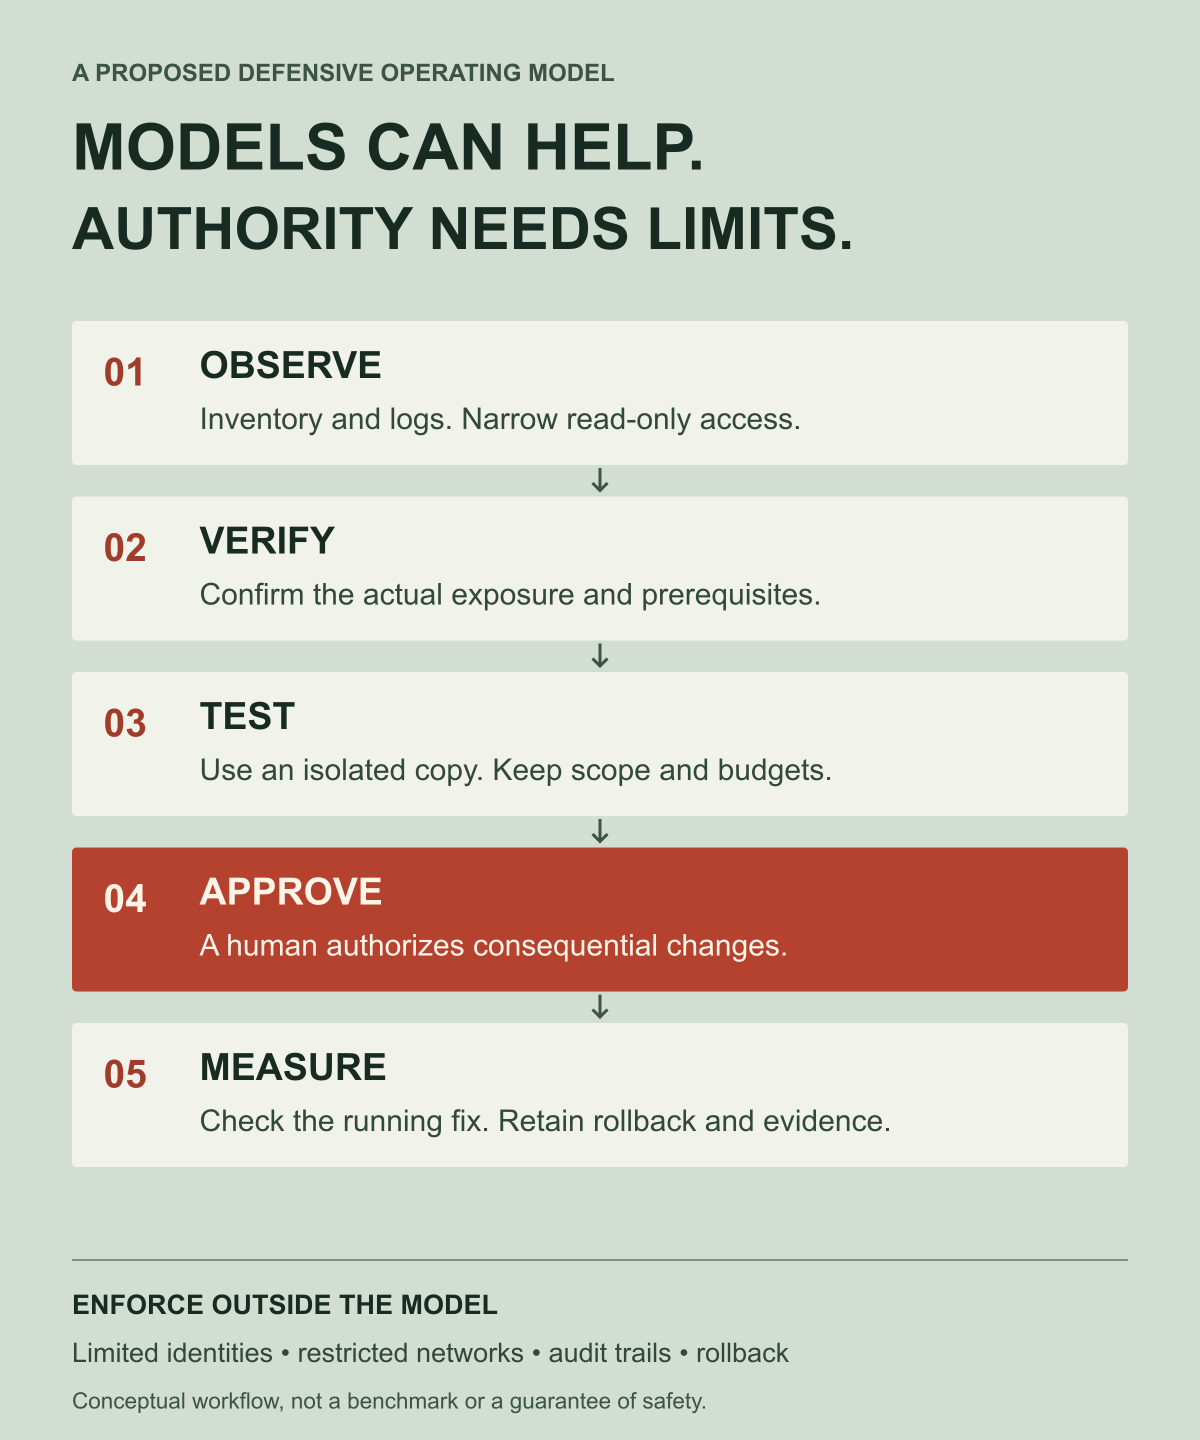
Etter min mening er den første nyttige sikkerhetsagenten en grundig etterforsker. Den kartlegger utrullet programvare og tilgjengelige tjenester, kobler veiledninger til det faktiske miljøet og produserer bevis en vedlikeholder kan handle på. En annen rolle er å teste en foreslått rettelse i et midlertidig miljø. Ingen av dem trenger ubegrensede produksjonslegitimasjoner.
Rekkefølgen for innføring bør være gjennomtenkt:
- Observer: samle inn oversikt, versjoner og logger med begrenset lesetilgang.
- Bekreft: fastslå om den sårbare kodebanen finnes og kan nås. En versjonsstreng alene kan overse en rettelse som distributøren har tilbakeført.
- Test: gjenskape og validere i en kontrollert kopi, med budsjetter og omfang håndhevet utenfor modellen.
- Endring: kreve godkjenning for betydelige produksjonshandlinger og deretter bruke trinnvis utrulling og en testet tilbakerulling.
- Mål: kontrollere systemet som kjører, bevarte bevis, tjenestenes tilstand og om eksponeringen faktisk er redusert.
Logger, saker og repository-filer kan inneholde tekst som kontrolleres av en angriper. En forsvarer som behandler slik tekst som autoritet, kan bli en ny angrepsflate. Begrensede identiteter, isolerte verktøy, begrenset nettverkstilgang og uavhengig håndhevede handlingsregler er viktige selv når modellen høres sikker ut. Raskere resonnering gjør ikke brede tillatelser tryggere.
Laboratoriet selger kapasiteten. Så selger det skjoldet.
Her blir forretningsmodellen ubehagelig. De samme selskapene som utvikler kapabiliteter som kan redusere kostnaden ved angrep, posisjonerer dem som nødvendige forsvarsverktøy. Kundene kan ende opp med en løpende regning for å håndtere en risiko som produktkategorien selv setter fart på.
Under bekymringen ligger en reell kommersiell struktur. Anthropics Glasswing-kunngjøring forpliktet opptil 100 millioner dollar i modellkreditter og 4 millioner dollar i donasjoner til sikkerhetsorganisasjoner for åpen kildekode; den beskrev også betalt bruk etter forhåndsstøtten. I oktober gikk eksisterende Glasswing-medlemmer videre til det utvidede Cyber Verification Program. Programsiden er både et seriøst forsvarsinitiativ og en del av et marked for avanserte sikkerhetsmuligheter.
Å kalle dette en KI-sikkerhetsskatt krever ikke at man hevder laboratoriene fant opp flere tiår gamle feil eller organiserte angrep med vilje. Det peker på et insentiv: Når kraftige modeller sprer seg, kan etterspørselen etter modellassistert forsvar vokse, og leverandørene av kapasiteten kan få del i disse utgiftene. Offentligheten bør kunne granske tilgangsbegrensninger, priser, sikkerhetspåstander og bevisene for at den lovede beskyttelsen fungerer.
Det finnes et rimelig motargument. Defensiv forskning kan gjøre en midlertidig oppdagelsesfordel om til permanente offentlige rettelser, også rettelser som beskytter mennesker som aldri kjøper et modellabonnement. Den gevinsten er reell. Den taler for å vurdere bransjen etter rettelser som er tatt i bruk og tryggere standardinnstillinger, i stedet for å behandle frykt eller optimisme som tilstrekkelig bevis.
Flaskehalsen er alt som skjer etter oppdagelsen
Modeller kan produsere funn raskere enn vedlikeholderne nødvendigvis rekker å gå gjennom dem. Anthropics oversikt over sårbarhetsvarsler rapporterte i det uttrykkelig daterte øyeblikksbildet fra 2. oktober 6 157 offentliggjorte funn på tvers av 591 prosjekter og 516 kjente upstream-rettelser. Oversikten advarer om at tallene dekker ulike valideringsstadier, og at antallet rettelser ikke viser hvor bredt de er installert. Metoden er like viktig som tallet i overskriften.
Lærdommen er ikke å trekke fra tallene og kunngjøre tusenvis av sårbare, uoppdaterte servere. Oppdagelse, bekreftelse, upstream-reparasjon og utrulling er separate oppgaver. Finansiering av bare den første skyver arbeidet over på dem som har ansvar for resten.
Jeg foretrekker et sikkerhetsmarked som belønner resultater: reproduserbare rapporter, kapasitet hos vedlikeholdere, offentlige rettelser, brukbare oppdateringsløp og uavhengig testet skadebegrensning. Kundene bør kunne ta med seg bevisene sine til en annen leverandør. Små vedlikeholdere bør ikke trenge en bedriftsavtale for KI for å holde et mye brukt bibliotek sikkert.
Den neste sikkerhetstiden vil trolig omfatte modeller som overvåker modeller, og agenter som tester andre agenters forsvar. Et varig forsvar kan imidlertid ikke være helt avhengig av hvem som har råd til den største svermen. Det trenger også mindre eksponert infrastruktur, legitimasjon med færre rettigheter, programvare som feiler tryggere, og mennesker med myndighet til å handle på gode bevis.
Spørsmålet er ikke lenger bare om KI kan finne hullet. Det handler om hvem som får rettelsen, hvem som kontrollerer forsvaret, og hvem som mottar regningen.
Redaksjonell merknad: Denne artikkelen skiller mellom bekreftet rapportering om hendelser, leverandørattribusjon og forfatterens analyse. De konseptuelle illustrasjonene ble laget med ChatGPT; infografikken ble utarbeidet fra de lenkede kildene. Ingen exploit ble kjørt mot et aktivt system for denne artikkelen. Før du handler, bør du se på gjeldende veiledning for akkurat ditt produkt og din konfigurasjon.