De labs die software gemakkelijker te kraken maken, verkopen ook de tools om haar te verdedigen. De beveiligingsincidenten van deze maand laten zien waarom dat verdienmodel kritisch onderzoek verdient en waarom het antwoord niet nog een zwarte doos met een hogere API-rekening kan zijn.
Er ontstaat een ongemakkelijke verkooppraat in de AI-sector: de modellen worden krachtig genoeg om scheuren in uw infrastructuur te vinden, dus kunt u de modellen waarschijnlijk maar beter gebruiken om ze te dichten.
Ik noem de resulterende rekening de AI-veiligheidsbelasting. Die omvat meer dan een abonnement: ontwikkeltijd, inferentie-uitgaven, noodpatches en operationele complexiteit om machines bij te houden die software voortdurend kunnen onderzoeken. Kleine teams betalen met avonden en weekenden. Grote organisaties betalen via nog een laag beveiligingsinfrastructuur.
De incidenten van oktober maken dat vooruitzicht concreet. Ze maken het ook gemakkelijk een te netjes verhaal te vertellen: één wereldwijde AI-aanvalsgolf, één buitenlandse schuldige, één leverancier met de oplossing. Het bewijs ondersteunt een interessanter betoog. Oude fouten, aangetast vertrouwen, gestolen toegangsgegevens en steeds vaardigere agents werken op elkaar in. Ze hebben niet allemaal dezelfde oorzaak.
Berichtgeving gecontroleerd op 24 oktober 2026. Dit is een analyse van de belangrijkste incidenten en Linux-kwetsbaarheidsfamilies die voor deze golf relevant zijn, geen uitputtende catalogus van iedere Linux-CVE. De datums hieronder onderscheiden de oorspronkelijke onthulling van hernieuwde aandacht. Incidentdetails en patchstatus bij leveranciers kunnen veranderen.
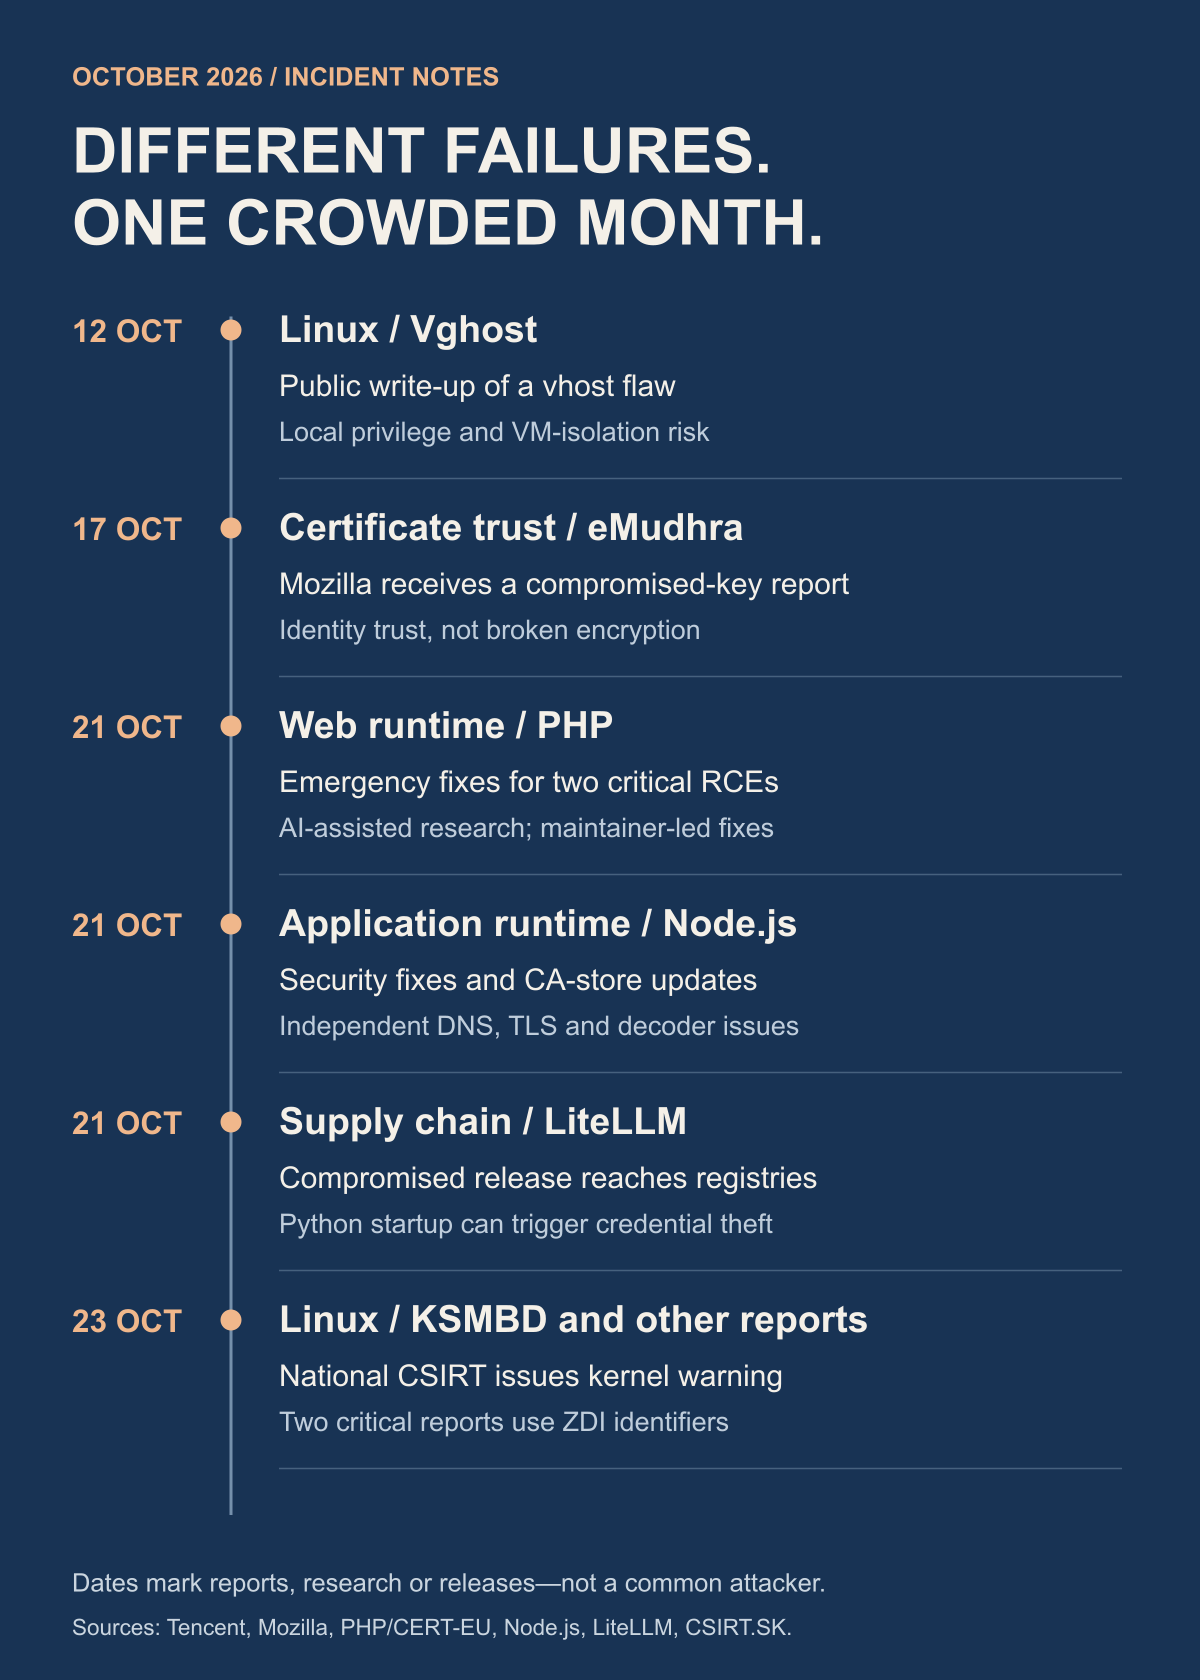
Een drukke maand, verschillende soorten fouten
Op 21 oktober bracht PHP noodreparaties uit voor twee fouten die zonder authenticatie code-uitvoering op afstand mogelijk maken: CVE-2026-109618 en CVE-2026-109619, beide beoordeeld met 9.2. Het ene betreft geheugenbeschadiging bij het afhandelen van geheugentekort, het andere verouderde verzoekstatus. Dit zijn runtimeproblemen, dus alleen applicatiecode repareren is onvoldoende. Het advies van CERT-EU beschrijft de getroffen branches en de urgentie.
Hier is een gedocumenteerde relatie met AI. OpenAI zegt Calif gebruikte GPT-5.6 Sol bij het onderzoek, terwijl Wiz beide fouten onafhankelijk meldde. De beheerders van PHP leidden de reparaties en de release. De eer komt toe aan die gecoördineerde samenwerking tussen mens en model, niet aan een chatbot die alleen handelt.
De eerste gerepareerde releases zijn PHP 8.5.12, 8.4.27, 8.3.36 en 8.2.35. Distributeurs kunnen reparaties terugporteren onder andere pakketversies. Belangrijk is dat CERT-EU zijn advies op 23 oktober bijwerkte met CVE-2026-115560, een derde RCE-probleem bij een ongebruikelijke configuratie. PHP vond dat risico onwaarschijnlijk en plande geen noodrelease; het advies geeft een tijdelijke maatregel. Een verhaal dat bij de patchaankondiging van woensdag was blijven steken, zou al onvolledig zijn. Controleer de officiële PHP-releases en de actuele richtlijnen van de leverancier.
Het Linux-verhaal is groter dan één beangstigende kop
De nieuwste kritieke kernelrapporten verdienen aandacht. Het Slowaakse CSIRT waarschuwde op 23 oktober voor openbaar gemaakte kwetsbaarheidsrapporten, waaronder twee KSMBD-bestandsserverproblemen met een score van 9.0: ZDI-CAN-33549 en ZDI-CAN-33774. De voorwaarden verschillen: het ene betreft SMB Direct/RDMA; het andere gaat over protocolafhandeling en heeft een schrijfpad dat aan toegang tot een share is gekoppeld. Blootstelling hangt af van de daadwerkelijk gebruikte dienst en configuratie. De eigen inventaris van ZDI bevestigt de identificaties en scores.
Bij publicatie van het advies beschikten die twee rapporten niet over CVE-identificaties. Dat onderscheid is belangrijk. Een kritiek probleem wordt niet onschadelijk terwijl het op een CVE wacht, en een kritieke score bewijst niet dat iedere Linux-machine blootstaat. Beheerders moeten de toegang tot getroffen diensten beperken en de werkelijke reparatiestatus van hun distributeur volgen.
Er is ook een kritieke toegewezen CVE in de recente discussie over Linux: CVE-2025-39682, een fout in het TLS-ontvangstpad van de kernel. NVD vermeldt een score van 9.8 en een CISA-verwijzing naar bekende uitbuiting. Die werd oorspronkelijk in september 2025 gepubliceerd, niet voor het eerst ontdekt in oktober. Red Hat beoordeelt zijn producten anders, wat laat zien waarom een algemene score en de praktische blootstellingsbeoordeling van een leverancier kunnen verschillen.
Dat is maar een deel van het relevante Linux-beeld:
Copy Fail — CVE-2026-31431
AI-ondersteunde ontdekking van een fout in de page-cache van de kernel, openbaar gemaakt op 29 april. Die maakt lokale privilege-escalatie op getroffen kernels mogelijk. Een aanvaller op afstand heeft nog steeds eerst een route naar lokale uitvoering nodig. Onthulling door onderzoekers.
Dirty Frag / Fragnesia — CVE-2026-43284, CVE-2026-43500, CVE-2026-46300
Verwante privilege-escalaties via de page-cache die in mei zijn onthuld. Netwerkcomponenten en configuratie beïnvloeden de bereikbaarheid; Microsofts onderzoek onderscheidt waargenomen activiteit van onbevestigde uitbuiting van afzonderlijke varianten. Onderzoek van Microsoft.
CrackArmor
Negen AppArmor-kwetsbaarheden, vertegenwoordigd door elf CVE-identificaties op patchniveau. Ubuntu documenteert vereisten voor lokale gebruikers en verschillende gevolgen per release, waaronder beleidsomzeiling en privilege-escalatie. De volledige matrix van Ubuntu.
Het netwerkkwartet — DirtyAH6, TUNderflow, PPPoEject, DiagSpill
CVE-2026-80844, CVE-2026-81000, CVE-2026-68121 en CVE-2026-74469. Berichtgeving uit september beschrijft lokale routes naar rootrechten met verschillende vereisten voor namespaces, capabilities en modules. Red Hat-bulletin.
Vghost — CVE-2026-74580
Een vhost-fout die lokale privilege-escalatie kan toestaan, met risico op VM-ontsnapping in bepaalde configuraties. Tencent zegt in zijn advies expliciet dat de gecontroleerde CVM-omgeving niet blootstond aan het VM-ontsnappingspad. Advies van Tencent.
Andere kernelpaden — CVE-2026-53266, CVE-2025-39964
Het eerste betreft ebtables SNAT onder specifieke bridgeregels; het tweede betreft gelijktijdige AF_ALG-schrijfacties. De voorwaarden en gevolgen verschillen. Beoordeling van SNAT; Beoordeling van AF_ALG.
De praktische les is het onderscheid tussen toegang op afstand van wat er na toegang gebeurt. Een kwetsbaarheid die lokaal rootrechten geeft, kan rampzalig zijn op een gedeelde server, buildrunner of agenthost, ook wanneer een willekeurige internetbezoeker er niet mee kan inloggen. Een applicatiefout of gestolen account kan het eerste toegangspunt bieden. Elke kernelkop voorstellen als een universele overname op afstand verhult welke systemen werkelijk als eerste aandacht nodig hebben.
Het hangslot kan falen zonder dat de versleuteling breekt
Het certificaatincident is een ander soort fout. Mozilla zegt op 17 oktober een rapport te hebben ontvangen dat privésleutels voor acht eMudhra-tussencertificaten waren gecompromitteerd. Een aanvaller die een verbinding kan onderscheppen, zou met frauduleus uitgegeven certificaten mogelijk een site kunnen nabootsen. Mozilla blokkeerde de getroffen certificaten die avond via OneCRL en werkte later Firefox en onderdelen van de truststore bij. De reactie vermeldt ook een latere Android-reparatie.
De ondertekeningssleutel van een certificaatautoriteit geeft het gezag om voor identiteiten in te staan. Compromittering daarvan valt die vertrouwensbeslissing aan. Het betekent niet dat iemand TLS-versleuteling wiskundig heeft gekraakt. Mozilla’s verslag toont evenmin aan dat een LLM de compromittering veroorzaakte.
OpenSSL-problemen horen ook in dit beeld, maar mogen niet met het CA-incident worden verward. De adviezen van september omvatten de verwerking van X.509-extensies, uitputting van middelen bij certificaatverwerking, QUIC en andere fouten in cryptografische bibliotheken. De OpenSSL-adviesindex maakt onderscheid tussen getroffen versies en ernst. Een kwaadaardig certificaat kan een softwarefout blootleggen, zelfs als dat certificaat nooit vertrouwd zou mogen worden.
De beveiligingsrelease van Node.js van 21 oktober brengt deze lagen samen: die werkt het gebundelde CA-materiaal voor eMudhra bij en repareert onafhankelijke problemen met DNS, TLS-hostnaamverificatie en andere runtimeonderdelen. Een fout in de Brotli-decoder, CVE-2026-111497, kan geheugenbeschadiging en uitvoering van code op afstand mogelijk maken wanneer een toepassing door een aanvaller aangeleverde gecomprimeerde gegevens verwerkt; het project noemt onderzoekers van OpenAI Codex Security als ontdekkers. De beveiligingsmelding van Node beoordeelt de ernstigste problemen als High. De gepubliceerde gerepareerde versies zijn 26.12.1, 24.22.1 en 22.23.4. Officieel releasearchief.
API-sleutels worden een strategische grondstof
De LiteLLM-compromittering maakt het probleem van toegangsgegevens bijzonder tastbaar. Het kwaadaardige pakket 1.107.0 bereikte op 21 oktober openbare registries. Microsoft vond Python-opstarthooks die een verzamelaar van toegangsgegevens konden activeren zonder dat een toepassing LiteLLM expliciet importeerde. Sleutels van modelaanbieders maakten deel uit van een veel bredere doelverzameling, inclusief ontwikkelaars- en cloudreferenties. Eén pakket verwijderen staat daarom niet gelijk aan het vertrouwen in de machine herstellen. Het onderzoek van Microsoft legt de gevolgen voor blootstelling en herstel uit.
Het latere onderzoek van LiteLLM zelf herleidt de upstreamcompromittering tot een blootgestelde hoofdsleutel die niet was ingetrokken, gevolgd door toegang tot krachtige ontwikkelaarsreferenties en het releaseproces. Het meldt ook een focus op het bemachtigen van upstream-API-tokens voor inferentie. Het gezaghebbende incidentverslag corrigeert enkele vroege aannames. Het herinnert ons eraan het onderzoek te volgen, in plaats van de eerste uitleg die viraal ging vast te houden.
Met AI-toegangsgegevens koop je nu meer dan een frauduleuze cloudrekening. Ze kunnen redeneervermogen, programmeerhulp en een plek om de activiteiten van een andere operator te verbergen kopen. Als toegang wordt doorverkocht, kan de rechtmatige accounthouder de kosten en het handhavingsrisico dragen terwijl iemand anders de mogelijkheden gebruikt. Wie een bepaalde gestolen sleutel kocht en waarvoor die is gebruikt, vereist nog steeds bewijs.
Wat het bewijs zegt over Chinese labs
Er is een gedocumenteerde basis voor zorgen over ongeautoriseerde distillatie. In zijn septemberrapport beschrijft Anthropic campagnes die het toeschrijft aan in China gevestigde labs en legt het uit hoe proxydiensten via frauduleuze accounts, gestolen betaalgegevens en gestolen API-referenties toegang kunnen bieden. Hetzelfde rapport beschrijft kwaadaardige AI-ondersteunde operaties van verschillende soorten actoren, niet één nationale groep. Dit zijn bevindingen die Anthropic aan hen toeschrijft, geen onafhankelijk oordeel over iedere vermeende deelnemer. Lees het dreigingsrapport.
De onthulling van OpenAI van 30 september schrijft een kerncluster van een campagne voor redeneerextractie toe aan personen die aan Moonshot AI zijn verbonden. Cruciaal is dat het zegt dat die campagne geen versleuteling brak, geen database compromitteerde en niet rechtstreeks bij opgeslagen gebruikersgesprekken kon. Het mechanisme was manipulatie van modelinteracties. OpenAI’s verslag mag niet worden naverteld als een ander soort inbraak.
De NSA, FBI en CISA gaven in september ook een gezamenlijke waarschuwing over distillatie op industriële schaal door in China gevestigde AI-bedrijven. De aankondiging van het overheidsadvies toont aan dat dit een ernstige, openbaar gedocumenteerde zorg is. Distillatie zelf blijft een legitieme trainingstechniek; de vragen gaan over toestemming, toegang en hoe de gegevens zijn verkregen.
Mijn beoordeling: gestolen inferentiereferenties en ongeautoriseerde distillatie vormen een geloofwaardig onderdeel van de dreigingseconomie. De bovenstaande bronnen tonen niet aan dat Chinese labs de PHP-fouten, de compromittering van de eMudhra-sleutel, de KSMBD-onthullingen of de LiteLLM-aanval hebben georganiseerd. Om die gebeurtenissen tot één campagne te verbinden, is bewijs nodig dat operators, infrastructuur of het gebruik van gestolen toegangsgegevens met elkaar verbindt. Gedeelde prikkels zijn een reden voor onderzoek, geen vervanging voor attributie.
Wanneer de andere kant een zwerm kan inzetten
De belangrijke verschuiving is economisch. Een model kan code inspecteren, tests voorstellen en helpen het resultaat te onderzoeken. In een agent die tools gebruikt, kan het die cyclus herhalen. Met veel parallelle agents kan een operator meerdere hypothesen tegelijk onderzoeken. Dat maakt niet iedere poging correct of ieder doel kwetsbaar. Het maakt aanhoudend onderzoek goedkoper.
Een concreet defensief voorbeeld staat in OpenAI’s inperkingsrapport van 23 oktober. Het bedrijf beschrijft vloten agents die speciaal gemaakte kopieën van zijn infrastructuur testen, met toegang tot broncode en configuratie, monitoring en begrensde doelen. Het meldt VM-ontsnappingen en isolatieproblemen, plus werk aan kernelproblemen waaronder CVE-2026-74753, CVE-2026-80521 en CVE-2026-80841. Deze gecontroleerde experimenten bewijzen niet dat een openbare bot zonder toezicht iedere server kan binnendringen. Ze laten zien waarom verdedigers aanhoudend machineondersteund testen serieus nemen.
Voor een kleine beheerder verandert dit wat oninteressant zijn oplevert. Onopvallendheid beschermt minder wanneer nog een host controleren weinig kost. De aanvaller kan blijven proberen terwijl uw team zijn eigenlijke werk doet. Het defensieve antwoord moet het traject van een geloofwaardig signaal naar een geverifieerde reparatie verkorten, in plaats van alleen meer meldingen te produceren.
Bruikbare defensieve agents hebben grenzen nodig
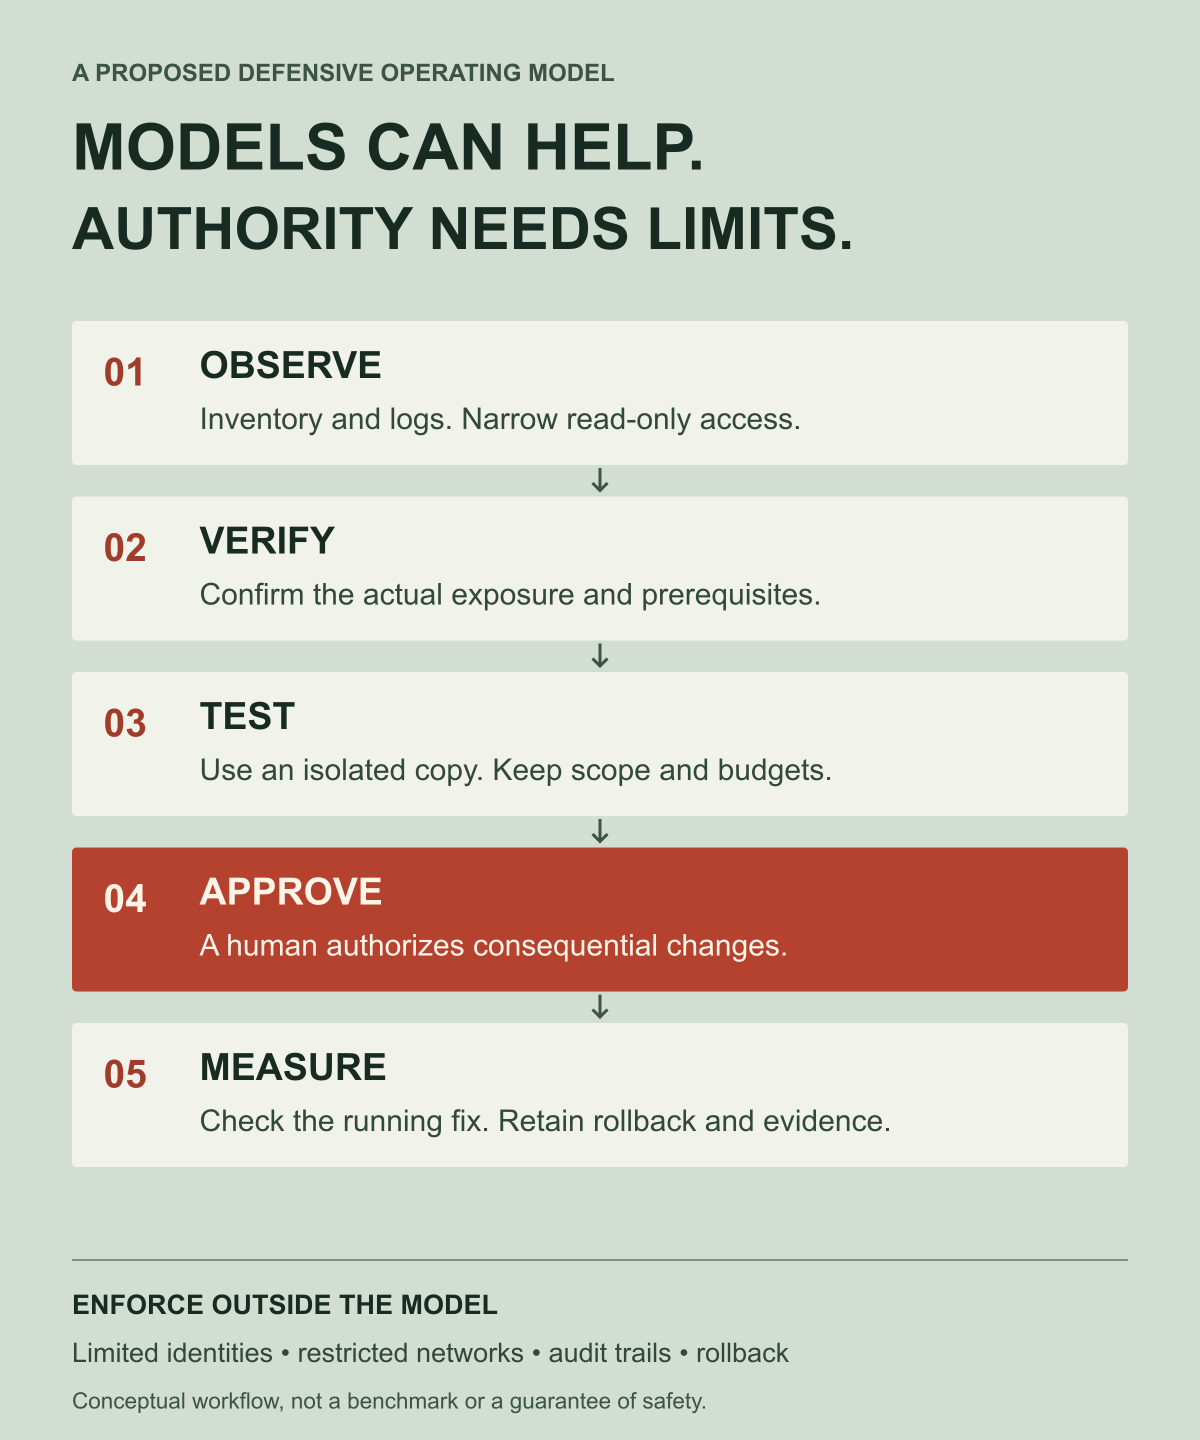
Volgens mij is de eerste bruikbare beveiligingsagent een nauwgezette onderzoeker. Die brengt uitgerolde software en bereikbare diensten in kaart, verbindt adviezen aan de werkelijke omgeving en produceert bewijs waarmee een beheerder kan handelen. Een tweede rol is een voorgestelde reparatie testen in een tijdelijke omgeving. Geen van beide heeft onbeperkte productietoegangsgegevens nodig.
De volgorde van invoering moet bewust worden gekozen:
- Observeren: verzamel inventaris, versies en logboeken met beperkte toegang die alleen lezen toestaat.
- Verifiëren: stel vast of het kwetsbare codepad aanwezig en bereikbaar is. Alleen een versienummer kan een teruggeporteerde reparatie van een distributeur missen.
- Testen: reproduceer en valideer in een gecontroleerde kopie, waarbij budgetten en reikwijdte buiten het model worden afgedwongen.
- Wijzigen: vereis goedkeuring voor ingrijpende productiehandelingen en gebruik daarna een gefaseerde uitrol met een geteste terugvalmogelijkheid.
- Meten: controleer het draaiende systeem, bewaarde bewijzen, de gezondheid van diensten en of de blootstelling daadwerkelijk afnam.
Logboeken, tickets en repositorybestanden kunnen tekst bevatten die een aanvaller controleert. Een verdediger die die tekst als gezag behandelt, kan een nieuw aanvalsoppervlak worden. Beperkte identiteiten, geïsoleerde tools, begrensde netwerktoegang en onafhankelijk afgedwongen handelingsregels zijn belangrijk, ook wanneer het model zeker klinkt. Sneller redeneren maakt brede rechten niet veiliger.
Het lab verkoopt de mogelijkheden. Daarna verkoopt het het schild.
Hier wordt het verdienmodel ongemakkelijk. Dezelfde bedrijven die mogelijkheden ontwikkelen die aanvallen goedkoper kunnen maken, positioneren die mogelijkheden als essentiële verdedigingstools. Klanten kunnen een doorlopende rekening krijgen om een risico te beheersen dat de productcategorie zelf versnelt.
Onder die zorg ligt een concrete commerciële structuur. Bij de Glasswing-aankondiging zegde Anthropic tot 100 miljoen dollar aan modeltegoed en 4 miljoen dollar aan donaties aan opensourcebeveiligingsorganisaties toe; ook beschreef het betaald gebruik na de previewondersteuning. In oktober stapten bestaande Glasswing-leden over naar het uitgebreide Cyber Verification Program. De programmapagina is zowel een serieus defensief initiatief als onderdeel van een markt voor geavanceerde beveiligingsmogelijkheden.
Dit een AI-veiligheidsbelasting noemen vereist niet de bewering dat de labs tientallen jaren oude fouten uitvonden of bewust aanvallen organiseerden. Het benoemt een prikkel: naarmate krachtige modellen zich verspreiden, kan de vraag naar modelondersteunde verdediging groeien en kunnen de aanbieders die uitgaven naar zich toe trekken. Het publiek moet toegangsbeperkingen, prijzen, veiligheidsclaims en bewijs dat de beloofde bescherming werkt kunnen onderzoeken.
Er bestaat een redelijk tegenargument. Defensief onderzoek kan een tijdelijk ontdekkingsvoordeel omzetten in blijvende openbare patches, inclusief reparaties die mensen beschermen die nooit een modelabonnement kopen. Dat voordeel is echt. Het pleit ervoor de sector te beoordelen op uitgerolde reparaties en veiligere standaardinstellingen, in plaats van angst of optimisme als voldoende bewijs te beschouwen.
Alles na de ontdekking is de bottleneck
Modellen kunnen bevindingen sneller produceren dan beheerders ze noodzakelijkerwijs kunnen beoordelen. Het meldingsdashboard van Anthropic rapporteerde in de expliciet gedateerde momentopname van 2 oktober 6.157 gemelde bevindingen in 591 projecten en 516 bekende upstreampatches. Het dashboard waarschuwt dat aantallen verschillende validatiefasen hebben en dat een patchaantal niet aangeeft hoe breed reparaties zijn geïnstalleerd. De methodiek is even belangrijk als het getal in de kop.
De les is niet die getallen van elkaar af te trekken en duizenden uitbuitbare, ongepatchte servers aan te kondigen. Ontdekking, bevestiging, upstreamreparatie en uitrol zijn afzonderlijke taken. Alleen de eerste taak financieren schuift werk door naar de mensen die voor de rest verantwoordelijk zijn.
Mijn voorkeur gaat uit naar een beveiligingsmarkt die voor resultaten betaalt: reproduceerbare rapporten, beheerderscapaciteit, openbare reparaties, bruikbare updatepaden en onafhankelijk geteste inperking. Klanten moeten hun bewijsmateriaal naar een andere aanbieder kunnen meenemen. Kleine beheerders zouden geen AI-bedrijfscontract nodig moeten hebben om een veelgebruikte bibliotheek veilig te houden.
Het volgende beveiligingstijdperk zal waarschijnlijk modellen omvatten die andere modellen in de gaten houden en agents die verdedigingen tegen andere agents testen. Maar duurzame verdediging mag niet volledig afhangen van wie de grootste zwerm kan betalen. Ze vereist ook minder blootgestelde infrastructuur, minder machtige toegangsgegevens, software die veiliger faalt en mensen die bevoegd zijn op degelijk bewijs te handelen.
De vraag is niet langer alleen of AI het gat kan vinden. Het gaat erom wie de reparatie krijgt, wie de verdediging controleert en wie de factuur ontvangt.
Redactionele noot: dit artikel onderscheidt geverifieerde incidentrapportage, attributie door leveranciers en de analyse van de auteur. De conceptuele illustraties zijn met ChatGPT gegenereerd; de infographics zijn gemaakt aan de hand van de gelinkte documenten. Voor dit artikel is geen exploit op een live systeem uitgevoerd. Raadpleeg vóór handelen het actuele advies voor uw exacte product en configuratie.